
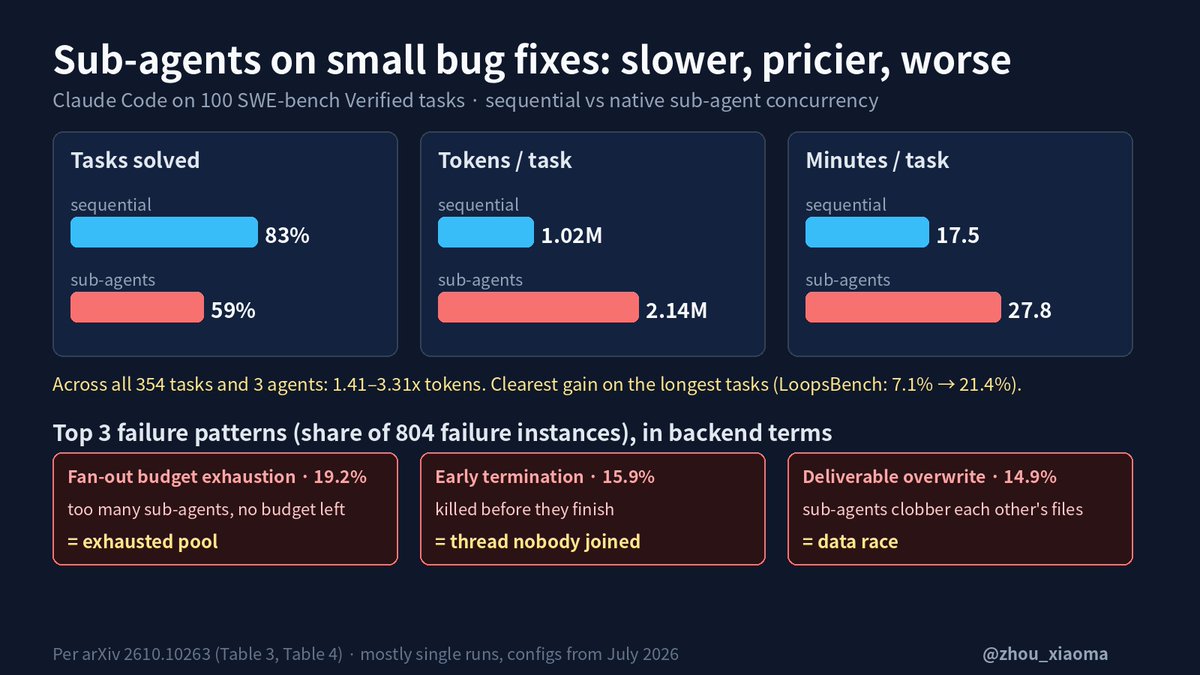
针对业内盲目推崇多智能体并发(Sub-Agent Concurrency)的狂热,最新实测研究对 Claude Code、Codex 与 Kimi Code 在开启/关闭原生 Sub-Agent 模式下进行了 2,124 次对比测试(覆盖 354 项任务,消耗超 2 万美元 API 额度)。结果显示:在 100 项标准 SWE-bench Verified Bug 修复中,开启 Sub-Agent 导致 Claude Code 成功率从 83% 骤跌至 59%,Kimi Code 从 77% 跌至 59%,且 Token 消耗激增 1.41~3.31 倍。研究揭秘了并发死锁、提前终止与文件覆盖三大致命缺陷。
核心要点速览
- ✓资深研究者开展耗资 2 万美元的大规模实测,运行 2,124 次对比测试揭秘编程智能体开启 Sub-Agent 并发的真实代价
- ✓在 SWE-bench Verified 100 项 Bug 修复中,开启 Sub-Agent 导致 Claude Code 成功率从 83% 跌至 59%,Kimi Code 跌至 59%
- ✓Token 消耗激增 1.41~3.31 倍,平均耗时从 17.5 分钟增加至 27.8 分钟,暴露预算耗尽、孤儿提前终止与文件相互覆盖三大并发缺陷
- ✓仅在复杂多文件长任务(LoopsBench,7.1%→21.4%)或设立独立验证者时有净增益,建议日常常规开发维持单 Agent 顺序执行
🖼️要闻配图
🧭
Claude Code 高频使用:比较订阅额度与 API 账单
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
🔬
深度技术解析与实战评估
核心背景与行业痛点
当前 AI 编程智能体领域普遍将“多智能体分工与并发(Multi-Agent / Sub-Agent Concurrency)”奉为提升复杂任务解决能力的银弹。诸多框架宣传通过主 Agent 派发子 Agent 并行搜索、并行编码与审查可以成倍加速工程交付。然而,在分布式后端系统中,无节制的并发往往伴随着数据竞争、死锁与资源枯竭。AI 行业此前缺乏针对“开启 Sub-Agent 到底能带来多大净收益”的大规模严格受控对比实验。资深研究者 @zhou_xiaoma 今日公布了一项耗资超过 2 万美元 API 调用的权威实测,给行业盲目的 Sub-Agent 狂热泼了一盆冷静的冷水。
架构亮点与底层机制
- 严格配对对比实验设计(Paired Comparative Protocol):
- 选取三大主力编程智能体:
Claude Code、Codex与Kimi Code; - 累计运行 2,124 次真实编码流水线,覆盖 354 项复杂软件工程任务,严格控制相同模型、相同提示词与沙盒环境,唯一变量是原生 Sub-Agent 并发是否开启;
- 三大类经典后端并发故障模式解构:
- 无限扇出与预算耗尽(Exhausted Pool / Unbounded Fan-out):主 Agent 盲目将任务拆解为过多微小任务派发,迅速榨干上下文窗口与推理 Token 预算,导致尚未开始写代码即告失败;
- 孤儿进程与提前杀死(Orphaned Unjoined Threads):主 Agent 未等待耗时较长的子 Agent 回传结果便草率汇总提交,有效逻辑被生生截断;
- 数据竞争与相互覆盖(Delivery Data Race):多个子 Agent 并行编辑重叠的文件依赖,后完成者直接抹杀先完成者的修复补丁。
权威 Benchmark 与实测跑分对比
根据 2,124 次完整执行记录统计(Figure 1, Benchmark Disclosures):
- SWE-bench Verified 100 项标准单文件/局部修复:
- Claude Code:单 Agent 顺序执行成功率高达 83%,开启 Sub-Agent 后暴跌至 59%(净降 24 个百分点),平均耗时从 17.5 分钟增加至 27.8 分钟;
- Kimi Code:从 77% 暴跌至 59%(净降 18 个百分点);
- Codex:成功率勉强持平(71% → 71%);
- Token 爆炸:所有模型的平均 Token 消耗激增为顺序单 Agent 的 1.41 倍至 3.31 倍;
- 超长跨文件复杂任务(LoopsBench)的反转表现:
- 在涉及数十个文件、需独立验证假设的极限复杂基准
LoopsBench上,Sub-Agent 展现出真正价值:Claude Code 解决率从 7.1% 显著反弹至 21.4%。
开发者实战落地与开箱指南
- 真实推文与讨论:详见 X 平台
@zhou_xiaoma实测报告(status/2112363831284650435); - 工程架构落地准则:
- 默认采用单 Agent 顺序执行:对于 90% 以上的代码补丁修复与功能迭代,切勿盲目开启多 Sub-Agent,否则只会徒增 3 倍账单并降低 20% 以上的成功率;
- 何时启用 Sub-Agent:仅在满足以下条件时启用:① 任务具备严格解耦的模块所有权划分(明确谁拥有哪个文件);② 采用多假设推演(两个 Agent 分别尝试不同解法,裁判 Agent 择优选拔);③ 设立完全独立且只读的代码审查验证 Agent(Independent Verifier)。
实战指南准备好将技术转化为生产力?
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
接着读Artificial Analysis 发布 AA-Robotics v0.1:让编码智能体直接操控机械臂,GPT-6 Astra 以 69.4 分居首
立即阅读→
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察