
vLLM 官方项目组正式宣布将 PhysisServe 的核心推理加速架构整合至 vLLM-Omni 多模态全能推理引擎中。针对物理世界 AI、视频扩散生成与具身大模型在长程去噪阶段面临的高显存占用与高延迟痛点,PhysisServe 创新性提出去噪步与 Transformer 跨块流水线并行(Block Pipelining)、时间分片批处理与虚拟秩联合调度。在 200 张 GPU 集群上对 MiniMax H3 33B 展开实测,实现每 4.1 毫秒输出一个 Chunk(折合千帧/秒渲染),Wan2.2 5B 单卡单请求延迟从 173 毫秒降至 98 毫秒。
核心要点速览
- ✓vLLM 官方宣布将 PhysisServe 核心加速架构合流至 vLLM-Omni,专精于物理世界大模型与视频扩散生成推理
- ✓首创去噪步与 Transformer 跨块流水线并行(Block Pipelining)与时间分片批处理,彻底消除多卡通信气泡
- ✓在 200 卡集群上 MiniMax H3 33B 达成每 4.1 毫秒产出单 Chunk(纯 DiT 计算达千帧/秒),Wan2.2 5B 单卡时延降至 98 毫秒
- ✓24 卡集群并发承载能力暴增 1.7~3.3 倍,代码已全面开源至 GitHub 并即将进入 vLLM-Omni 正式版
本地显存不够?先比较云端 API 与自部署的实际成本
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
随着 Sora、Wan2.1/Wan2.2 以及物理世界具身世界模型(World Models)的迅速铺开,生成式视频与物理仿真推理正逐渐从离线批处理走向实时交互时代。然而,主流大模型推理框架(如标准 vLLM、SGLang、TensorRT-LLM)最初皆针对自回归(Autoregressive)文本 Token 解码量身定制。面对多轮迭代去噪(Iterative Denoising)、跨时空 3D 注意力计算与多分辨率 DiT(Diffusion Transformer)块,既有框架显存碎片化严重、跨卡通信气泡巨大,导致高并发下请求延迟呈指数级飙升。vLLM 官方团队今日宣布,正式将专为物理世界模型打造的高性能服务引擎 PhysisServe 的核心技术合并至 vLLM-Omni。
架构亮点与底层机制
- 去噪步与 Transformer 块跨阶段流水线(Block & Step Pipelining):
- 彻底打破传统扩散模型每步去噪必须全量同步等待的屏障,在相邻去噪时间步(Timesteps)与前后 Transformer 深度网络层之间构建精细流水线,实现通信开销与计算流的完全重叠掩盖;
- 时间分片多请求批处理(Time-Sharing Multi-Request Batching):
- 允许处于不同去噪阶段(如刚开始去噪与即将完成收敛)的多个异构视频生成请求在同一计算批次中灵活复用显存,显著消除传统批处理中的等待“空泡(Bubbles)”;
- 虚拟秩与全局联合调度器(Virtual Ranks & Joint Scheduling):
- 将物理 GPU 拓扑抽象为动态可伸缩的虚拟计算单元,动态平衡不同视频时长与分辨率的负载倾斜,官方开源代码已上线 GitHub 并启动向 vLLM-Omni 主线合流。
权威 Benchmark 与实测跑分对比
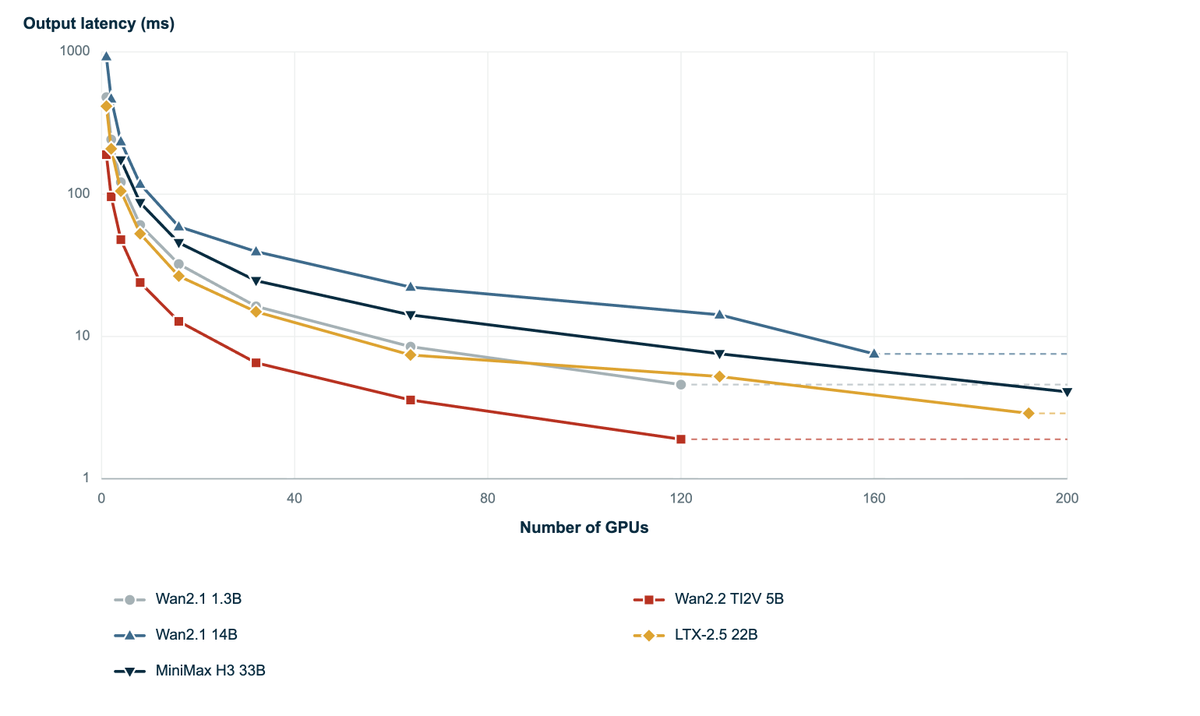
根据 PhysisServe 官方技术披露与 vLLM 联合实测数据(Figure 1, Benchmark Disclosures):
- 千帧级视频生成低延迟表现:
- 在部署 200 张顶尖 GPU 集群上对 MiniMax H3 33B 视频基座展开全链路测试,系统达到每 4.1 毫秒 即可稳定产出一个视频 Chunk(不计 VAE 最终解码下,纯 DiT 生成速率折合约 1,000 FPS);
- 在受测的五大多模态与视频基座上,最低单 Chunk 交付时延被压缩在 1.895 ms 至 7.547 ms 的极致毫秒区间;
- 单卡与并发吞吐跃升:
- Wan2.2 5B 单卡单并发推理时延从基线 173 毫秒断崖式缩减至 98 毫秒(提速 43.4%);
- 在 24 卡分布式集群评测中,针对高并发请求场景,4 款主力视频模型的并发服务承载能力提升了 1.7 倍至 3.3 倍(例如 Wan2.1 1.3B 从 12 个并发飙升至 39 个并发)。
开发者实战落地与开箱指南
- 开源代码与仓库:开发者可访问
github.com/Physis-AI/PhysisServe查阅独立引擎源码,后续将随vLLM-Omni新版本发布直接获得原生支持; - 视频与具身端侧选型建议:对于研发实时数字人交互、自动驾驶物理世界模拟器或云端高并发视频生成 API 的架构团队,应立即关注 vLLM-Omni 的多流调度接口。通过采用其跨去噪步流水线方案,可在维持现有 GPU 集群不变的前提下将视频生成吞吐提升 2~3 倍,直接缓解百万美元级别的云算力成本压力。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察