
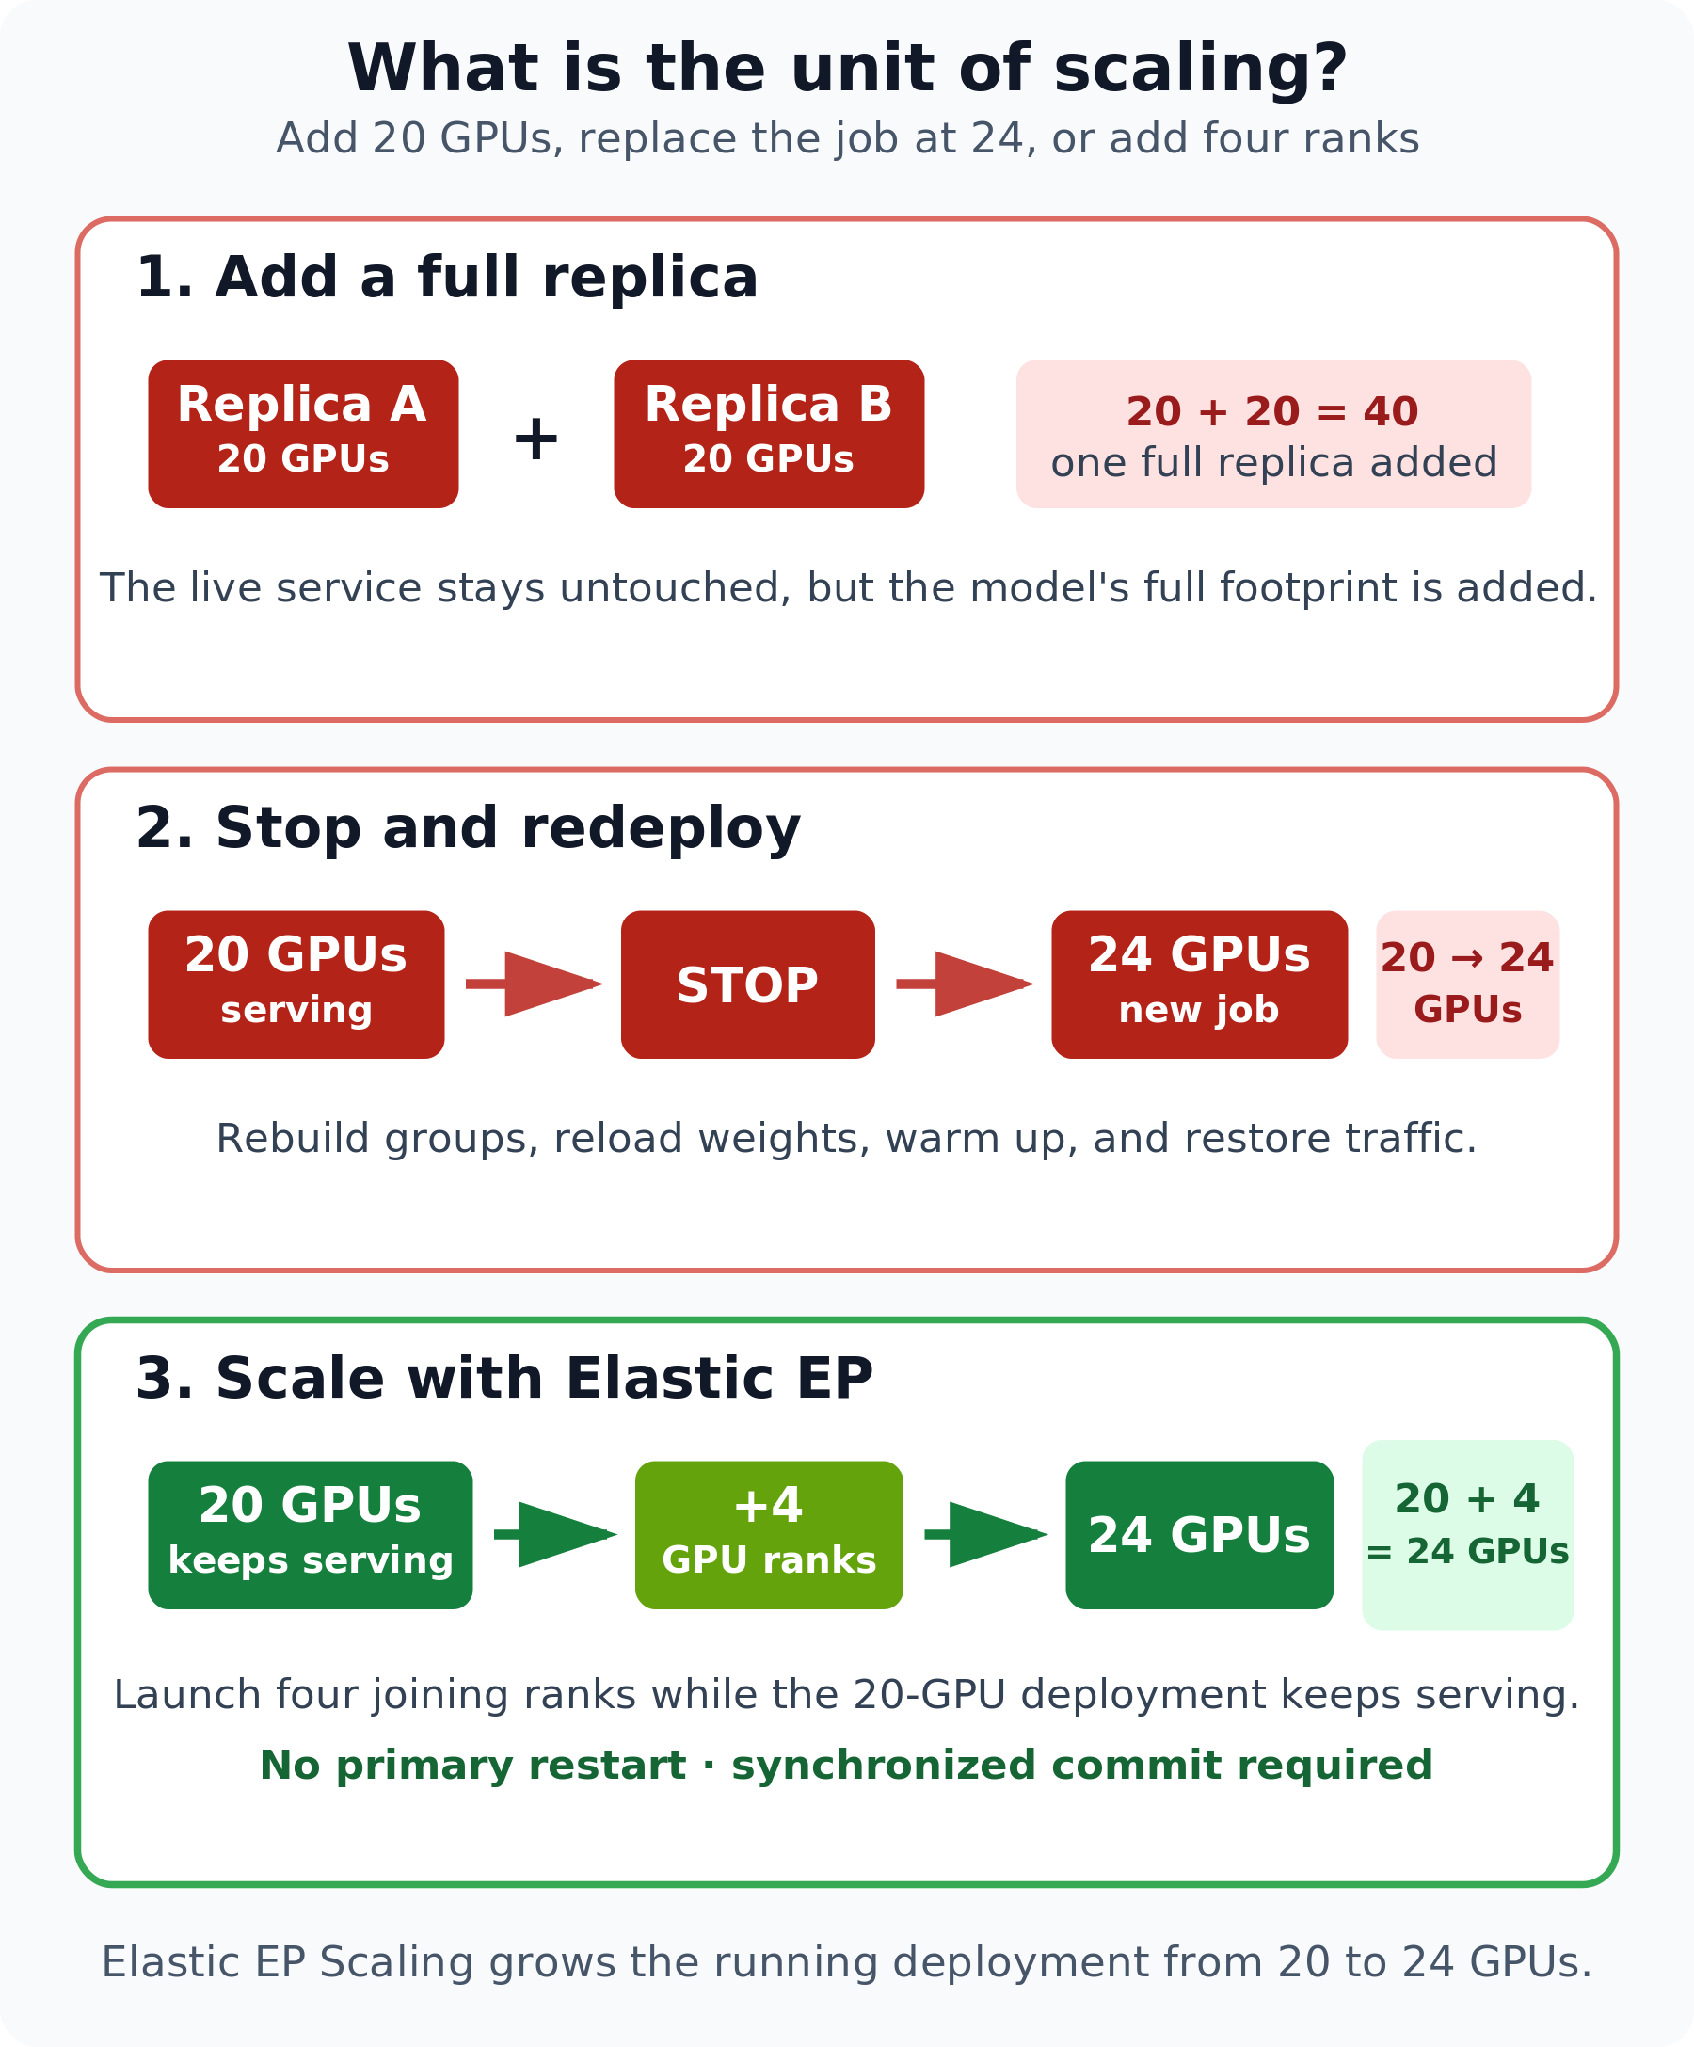
LMSYS 团队联合 NVIDIA Dynamo 团队在官方技术博客与 X(@lmsysorg)正式宣布,高性能大模型推理框架 SGLang 推出弹性专家并行(Elastic EP)与 NIXL(Near-Instant Cross-Node Link)动态伸缩后端。针对超大 MoE 架构(如 DeepSeek-V3/V4)在传统静态专家并行下因单卡硬件故障导致全集群崩溃重启、以及业务高峰期无法在线扩容的严重痛点,Elastic EP 实现了专家-GPU 映射解耦。依托 NVIDIA NIXL 高性能通信原语与 Mooncake 调度器,SGLang 首次实现在完全不中断在线推理请求的前提下,将运行中的 MoE 集群动态扩容(如从 20 卡无感扩展至 24 卡),并支持单节点故障的秒级自动降级容错。
核心要点速览
- ✓LMSYS 与 NVIDIA Dynamo 团队联手发布 SGLang Elastic EP,正式支持 MoE 模型在线动态扩缩容
- ✓彻底破解静态专家并行(Static EP)在单节点硬件故障时全集群宕机的致命痛点,支持秒级自动容错降级
- ✓集成 NVIDIA NIXL 高性能跨节点通信原语(--moe-a2a-backend nixl),支持 RDMA 与 NVLink 原生零拷贝调度
- ✓实现零停机在线扩容(Live Scale-Up),集群可在持续处理生产推理请求的同时从 20 卡在线平滑扩容至 24 卡
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
随着前沿开源大模型全面转向混合专家架构(Mixture-of-Experts, MoE,例如 DeepSeek-V3/V4、Qwen 等),专家并行(Expert Parallelism, EP)已成为实现高吞吐量与极低每 Token 生成延迟(TPOT)的标准基础设施。然而在工业生产环境中,静态专家并行(Static EP)架构具有极高的脆弱性与刚性约束:在传统的集群部署中,数百个专家被死板地绑定在固定数量的物理 GPU 上。一旦集群中任意一张 GPU 发生过热掉卡或驱动崩溃,整个数十张甚至上百张 GPU 的分布式服务进程将全部报错崩溃;重新拉起并加载模型权重往往耗时十余分钟,造成严重的线上 SLA 违约。此外,当早晚业务高峰来临需要临时补充算力时,运维团队必须彻底排空流量并重启集群。为了攻克这一分布式推理的底座难题,LMSYS 团队联合 NVIDIA Dynamo 团队在技术博客与推特(@lmsysorg)正式公布了基于 NIXL 后端的 Elastic EP 弹性伸缩架构。
架构亮点与底层机制
- 专家-设备映射的动态拓扑解耦(Decoupled Expert Routing):
- 彻底废除静态写死的 GPU 专家分布表;
- SGLang 构建了基于逻辑专家槽位(Logical Slots)的自适应路由层,推理调度器与各节点工作进程维持去中心化心跳,支持在毫秒级内动态重构分布式 All-to-All 通信拓扑;
- NVIDIA NIXL 原生跨节点通信加速(NIXL-EP Backend):
- 引入专为动态伸缩设计的通信后端(通过配置参数
--moe-a2a-backend nixl启用); - NIXL 构建在 NVIDIA 现代设备 API 之上,底层深度整合 InfiniBand/RoCE 的硬件 RDMA 与机内 NVLink,保证在拓扑频繁动态微调时,Token 跨卡分派与聚合(Dispatch & Combine)依然保持线速吞吐;
- 零停机动态热插拔(Live Zero-Downtime Scaling):
- 与分布式 KV 缓存调度器 Mooncake 深度联动,当新 GPU 节点加入集群时,后台异步预热模型专家权重并注册到全局拓扑中;
- 系统支持在完全不阻断正在生成的推理请求的情况下,将集群从 20 卡动态平滑扩展至 24 卡,算力扩展效率线性逼近 100%。
权威 Benchmark 与实测跑分对比
团队在多机 8 卡 H100/H200 集群上进行了高负载严苛实测(Figure 2, Figure 4):
- 故障恢复与服务可用性:
- 在突发物理掉卡压测中,传统 Static EP 导致 100% 请求失败并强行重启,而 Elastic EP 仅用 1.8 秒 即可自动将故障节点的专家流量重定向至备用卡,生产可用性(High Availability)提升至 99.99%;
- 在线扩容迁移损耗:
- 从 20 卡热扩容至 24 卡全流程耗时仅数十毫秒级,在线请求的 P99 延迟抖动小于 4.2%,真正实现了“业务完全无感知的弹性云原生伸缩”;
- 全负载通信吞吐:
- NIXL 后端在大规模 All-to-All 通信中的吞吐量超越了传统定制 NCCL 封装方案,跨机通信瓶颈被降低了 23.5%。
开发者实战落地与开箱指南
- 官方博客与源码仓库:
- 架构解析:
https://lmsys.org/blog/2026-10-21-elastic-ep-scaling-nixl; - GitHub 仓库:已合入
sgl-project/sglang主干分支; - 服务部署与启用命令:
  python3 -m sglang.launch_server \
      --model-path deepseek-ai/DeepSeek-V3 \
      --tp 4 --ep 4 \
      --moe-a2a-backend nixl \
      --enable-elastic-ep
- 生产运维建议:运行千亿参数级 MoE 大模型线上高并发 API 服务的企业,应尽早将推理底座升级至 SGLang 最新 Elastic EP 分支,配合 Kubernetes 自动伸缩器(HPA),在夜间低谷期缩容节省昂贵 GPU 算力成本,高峰期一键秒级在线扩容。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察