
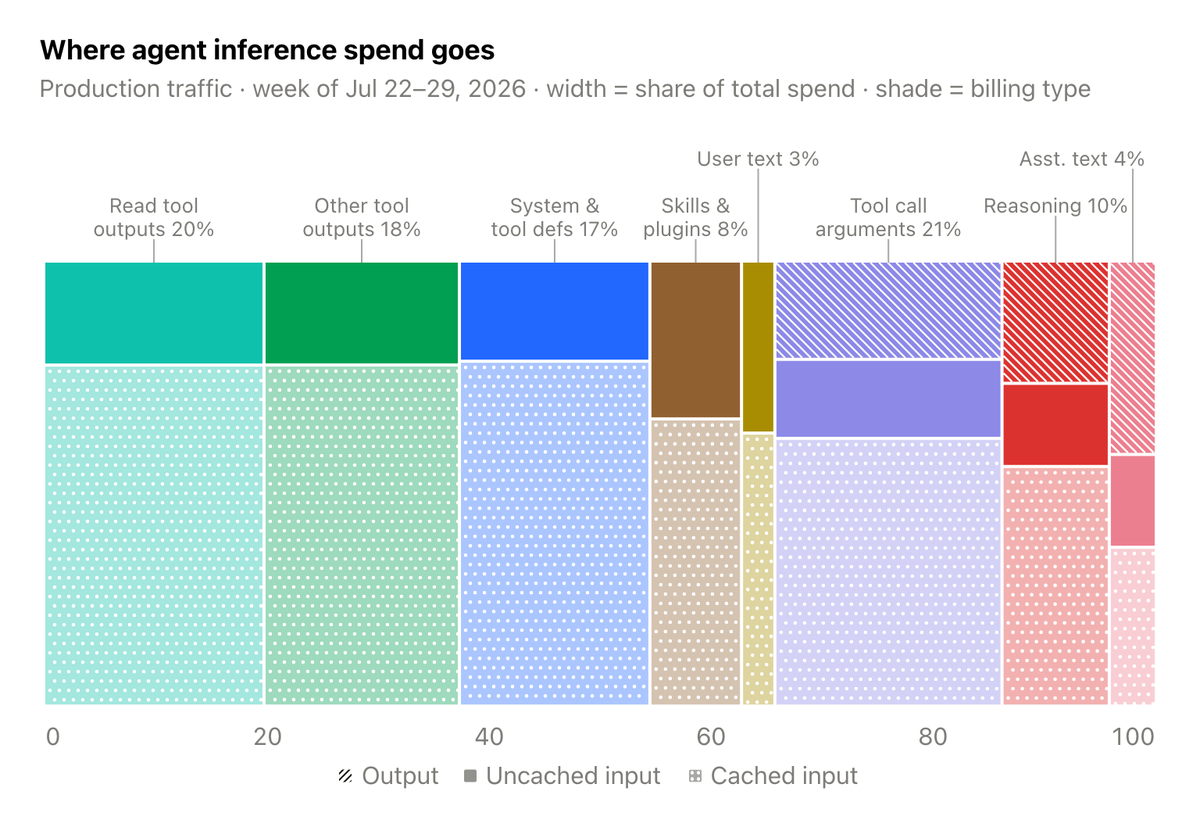
Cursor(@cursor_ai)发布 Agent Harness 效率升级:在不明显降低 Agent 质量的前提下,用户 Token 成本整体下降约 7%。手段包括系统提示约砍 66%、内置工具按需加载(MCP 动态上下文曾在相关会话省 46.9%)、为稳定前缀设置显式缓存断点(冷缓存未命中率降 20%),以及文件行号改为每 10 行标注一次(缓存读 Token 再降约 1.6%)。
核心要点速览 (Key Takeaways)
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
编码 Agent 任务变长后,Token 账单主要来自「每轮必带」的系统提示、工具定义与不断膨胀的上下文,而非单次补全。Cursor 在官方博文 Improved token efficiency 指出:Harness 直接控制请求拼装、缓存复用与子 Agent 分工,是平台侧最可优化的成本杠杆,也是长程 Agent 能否可持续使用的关键。
架构亮点与底层机制
1) 系统提示约精简 66%,用工具行为描述替代冗长禁令;2) 高频读写/搜索/编辑/Shell 留在静态上下文,其余内置工具按需加载(延续 MCP 动态上下文思路);3) 自 GPT-5.6 起在稳定前缀后打显式缓存断点,把易变的 skills/环境信息挪到「phantom user message」;4) Read 改为每 10 行标号;5) 收敛子 Agent 滥用探索与乱选模型。
权威 Benchmark 与实测跑分对比
Cursor 基于大规模用户 A/B(Token、成本、延迟、工具错误率、Agent 使用量)给出产品侧指标,而非公开 SWE-bench:整体成本 −7%;MCP 动态上下文历史增益 46.9%;冷缓存未命中 −20%;行号稀疏化使缓存读 Token −1.6%。官方称 Agent 质量无下降。
开发者实战落地与开箱指南
升级/保持最新 Cursor 即可自动受益,无需改项目配置。长会话可关注 Prompt Caching 命中与工具是否被过早塞进静态上下文;Plan Mode 仍保留 create_plan 等关键工具。细节与图示见 cursor.com/blog/improved-token-efficiency。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察