
vLLM 项目(@vllm_project)发布 v0.30.0(762 提交、315 贡献者)。亮点包括混合注意力热路径:Kimi K3 精简 KDA/AttnRes/MLA,DeepSeek-V4.1-Flash 加入 MXFP8 KV 与异步 Engram,Qwen3.8-Flash-Next 融合 QSA/PLE 并降低 sparse-GQA 开销;另有 HiSparse 主机层、Model Runner V2 的 EAGLE3 管线并行与自适应校验、双密钥 Gumbel-max 水印,以及 Fast Start(CUDA IPC 权重缓存)与 GLM-5.3-Flash、K2-Horizon、Cohere Compass、Bailing V3 VL 等新模型支持。
核心要点速览
- ✓混合注意力热路径覆盖 Kimi K3、DeepSeek-V4.1-Flash、Qwen3.8-Flash-Next 等当前编码常用模型。
- ✓Model Runner V2 把 EAGLE3 式草稿扩展到流水线并行,并在线估计验收率。
- ✓Fast Start 用 CUDA IPC 缓存量化分片权重,重启加载更快。
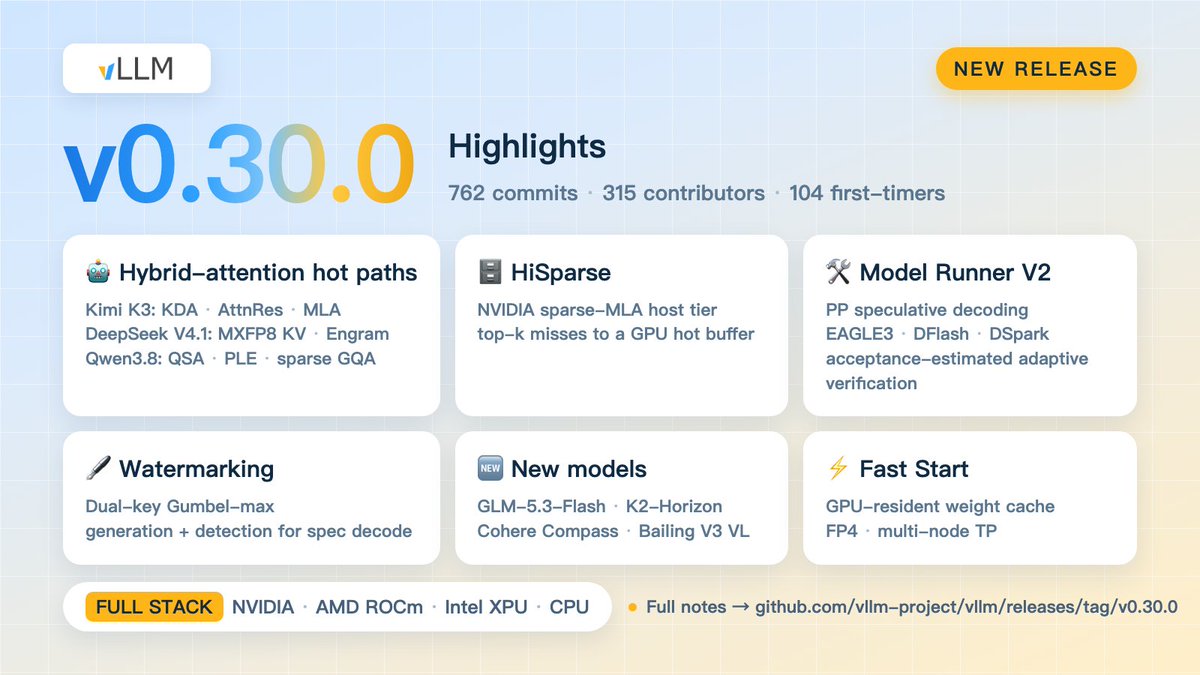
🖼️要闻配图
⚡
一眼结论开发者 3 秒速决决策指标
🧭
本地显存不够?先比较云端 API 与自部署的实际成本
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
实战指南准备好将技术转化为生产力?
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
接着读vLLM v0.31.0:717 提交上线 vllm preload 秒级重启,DeepSeek-V4.1-Flash 默认 FlashMLA,多项安全与破坏性变更
立即阅读→
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察