

Amazon 10 月 19 日宣布 TorchNeuron:通过 PyTorch 标准的 PrivateUse1 设备后端机制,把 Trainium 注册成原生 "neuron" 设备,支持 eager 模式、torch.compile 和 FSDP/DTensor/DDP 等原生分布式 API,覆盖 Trn2 与 Trn3。官方称现有 PyTorch 代码只需改一处设备配置即可运行,将于 10 月 20 日在 PyTorch Conference North America 以 Apache 2.0 开源。官方文档显示,目前它仍处于封闭 Beta。
核心要点速览
- ✓开源时间:10 月 20 日 PyTorch Conference North America,许可证 Apache 2.0(官方口径)。
- ✓支持硬件:Trainium2、Trainium3;通过 PrivateUse1 注册为 neuron 设备,支持 eager 与 torch.compile(backend="neuron")。
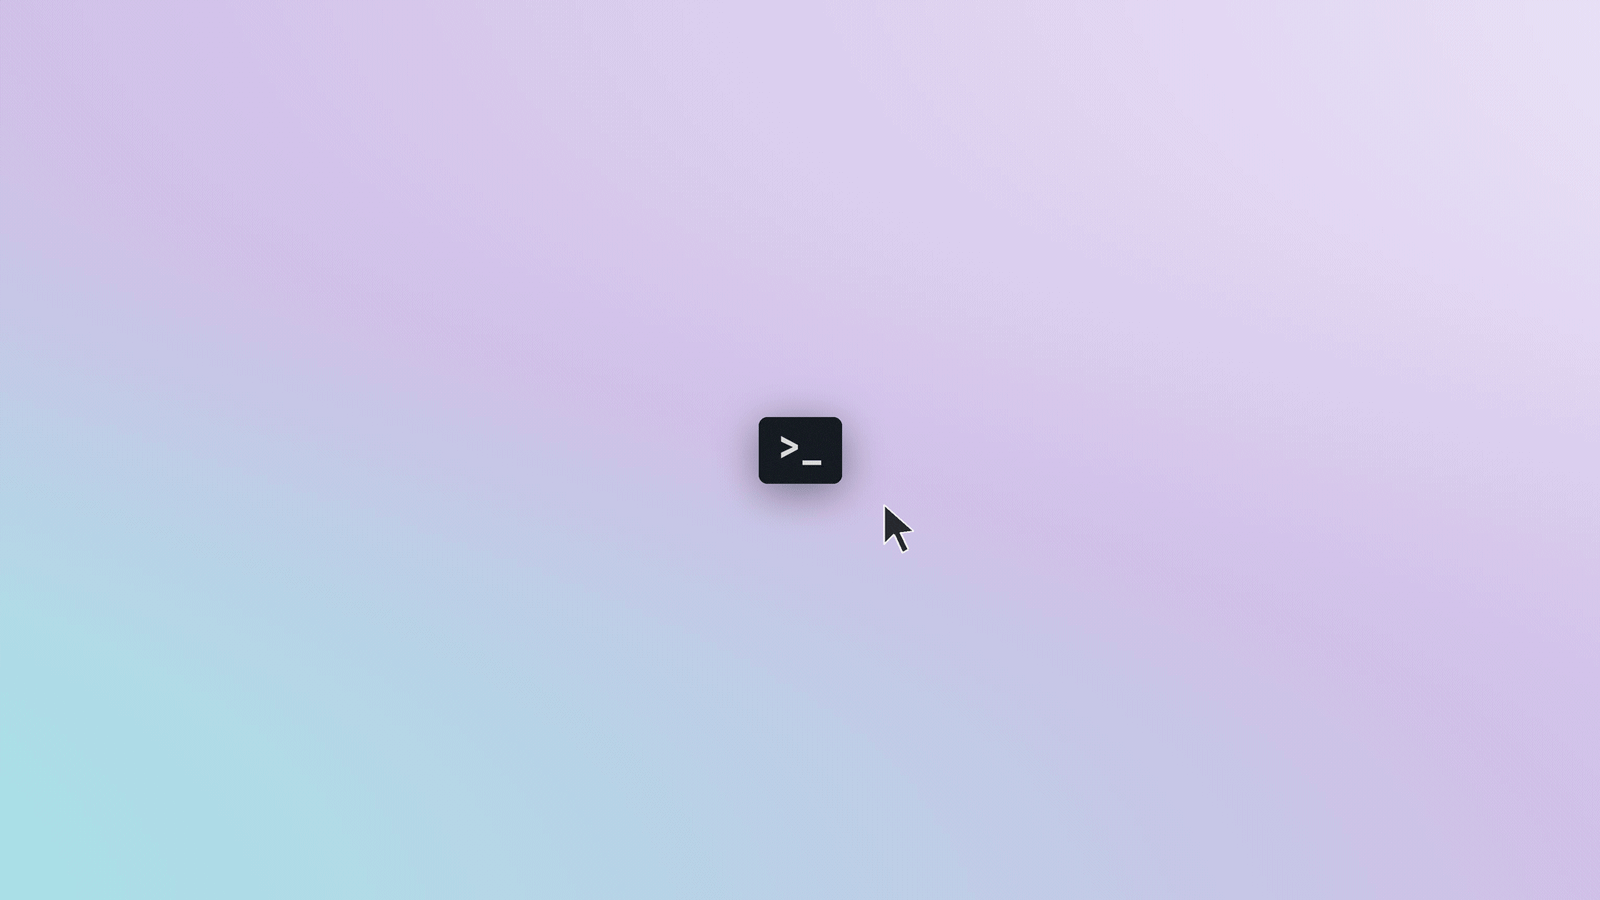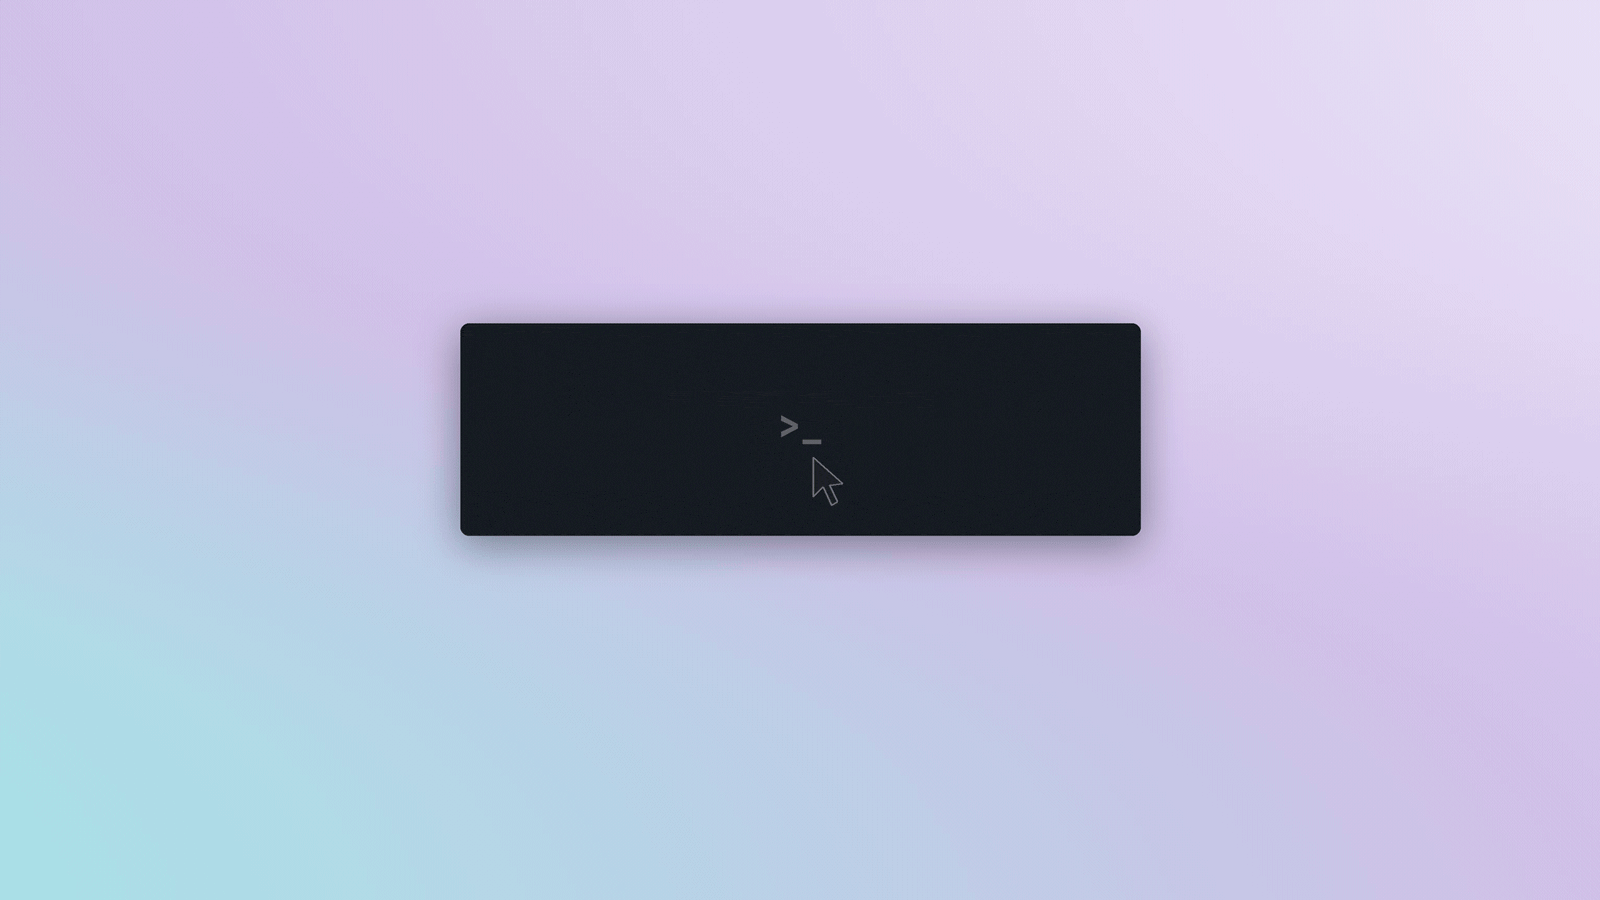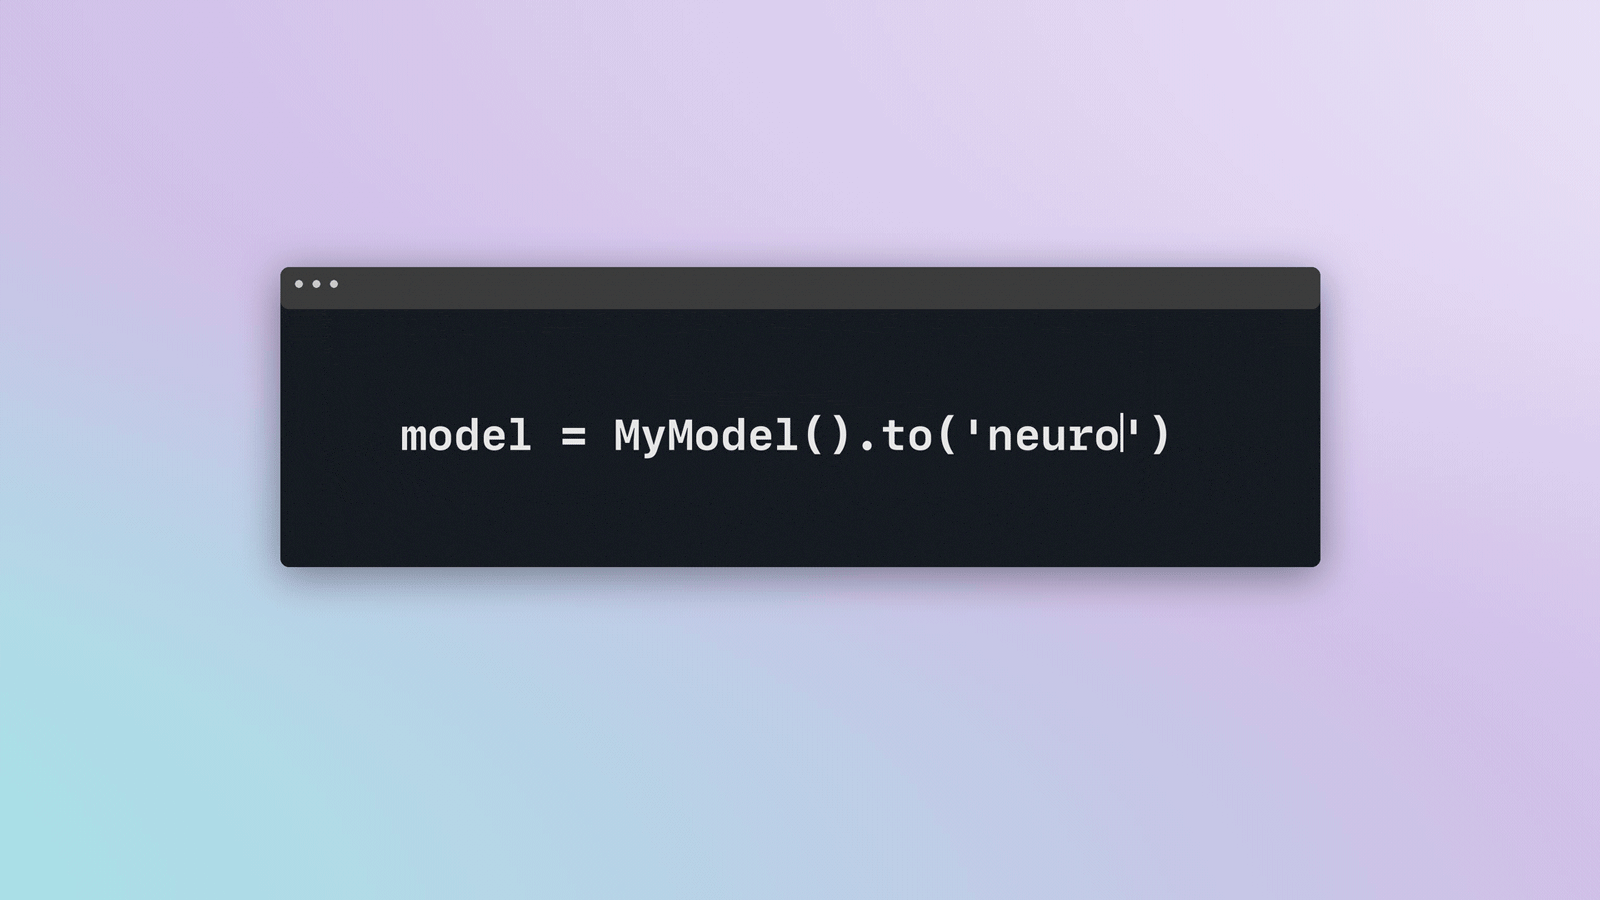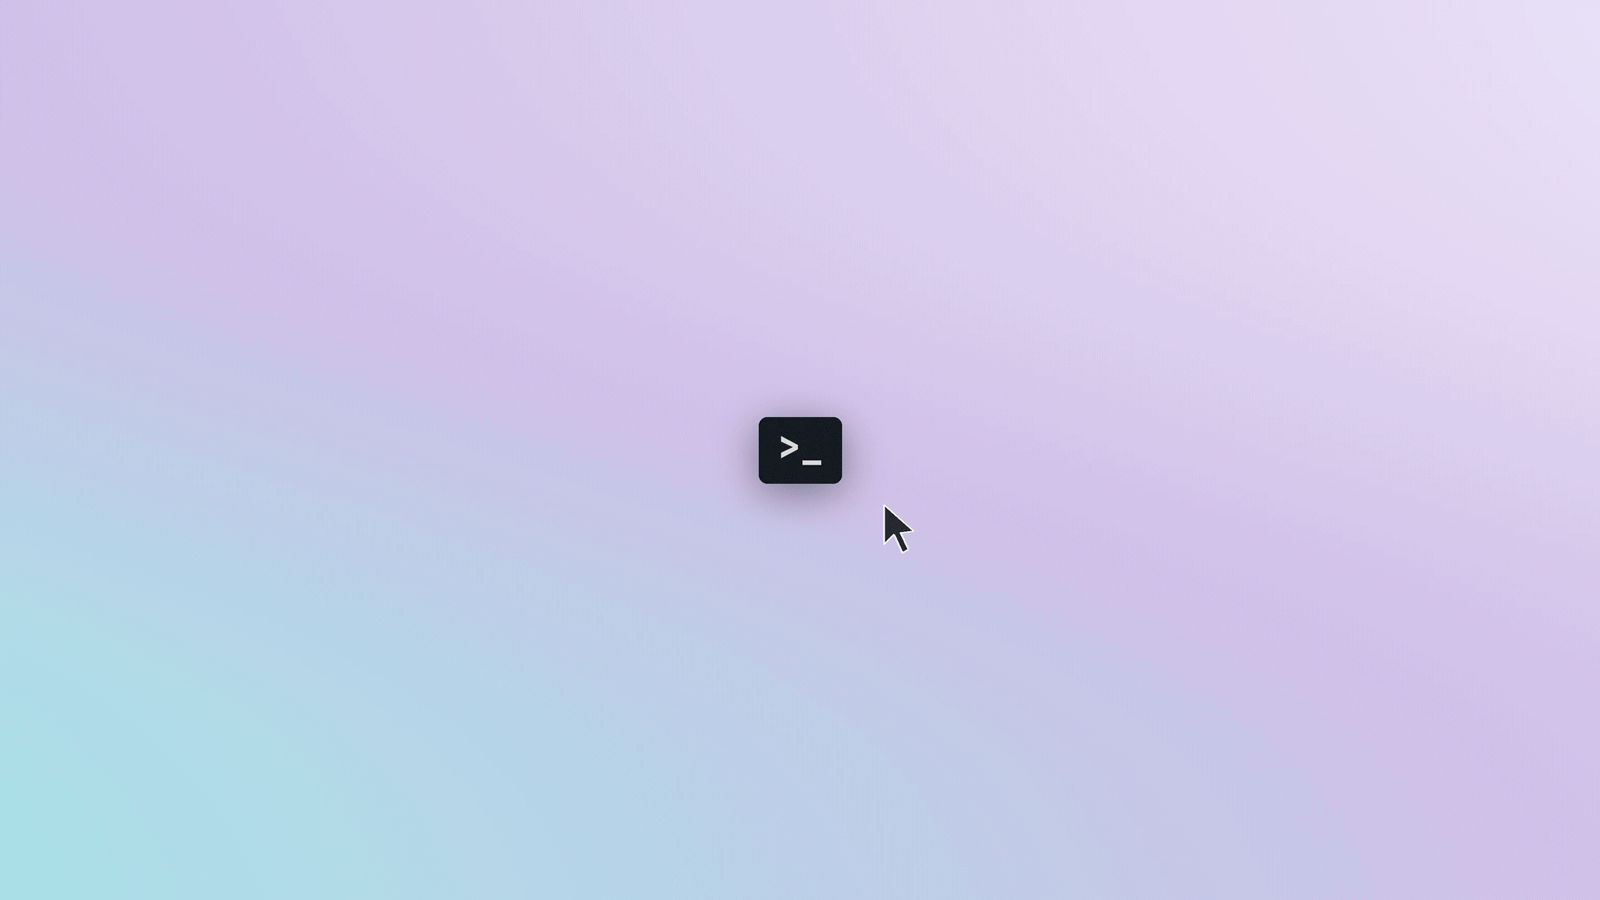
- ✓迁移改动:官方宣传「一处配置、无需重写」;文档列出的最小改动是 .to("cuda") 改 .to("neuron"),张量并行还要按 NeuronCore 数量调整分片配置。
- ✓PyTorch 2.9 是最后一个基于 PyTorch/XLA 的版本,从 PyTorch 2.10 起 Neuron 改走 TorchNeuron,老脚本升级时需要修改。
- ✓质量与生态:官方称每次构建都对数十万个模型做回归测试,已接入 TorchTitan,Hugging Face 工具链已原生支持 Trainium;官方未公布性能跑分。
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
Amazon 引用的数据是 85% 的 AI 研究者和开发者用 PyTorch 写代码,但能顺畅跑这些代码的硬件选择很少。换到新芯片往往意味着重写、重新验证,对小团队来说工程时间比芯片价格更贵。AWS 此前的 Trainium 路线依赖 PyTorch/XLA。
架构亮点与底层机制
TorchNeuron 不再走 XLA,而是通过 PyTorch 自带的 PrivateUse1 设备后端机制,把 Trainium 注册成原生的 neuron 设备。它支持 eager 模式方便调试,用 torch.compile 做即时编译,原生支持 FSDP、DTensor、DDP 和张量并行,自定义算子可用 NKI 编写。
权威 Benchmark 与实测跑分对比
官方未公布性能跑分。官方口径只说明:同一训练脚本在常规芯片和 Trainium 上并排运行,模型收敛轨迹一致;每次构建都会对数十万个模型做回归测试。真实吞吐与成本还待社区实测。
开发者实战落地与开箱指南
官方宣传「一处配置、无需重写」,文档写得更具体:把 .to("cuda") 改成 .to("neuron"),编译时指定 backend="neuron";FSDP 基本不用改,张量并行要按 NeuronCore 数量配置分片。需要 PyTorch 2.10 及以上,2.9 是最后一个 XLA 版本。文档目前仍标注封闭 Beta,开源版定于 10 月 20 日发布。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察