

DeepSeek 于 10 月 20 日(UTC)开源内部推理框架 DeepInfer(Apache 2.0),即支撑 DeepSeek-V4.1-Flash 大规模线上服务的推理栈。本次开源版本提供离线推理,支持 Attention DP/CP、MoE EP+EPLB 并行、DSpark 投机解码、SWA bounded replay、批次不变推理、确定性采样和结构化输出,硬件为 NVIDIA SM100 与华为昇腾 950。KV cache 系统、PD 分离和负载均衡未包含在内。同时开源的 deepseek-recipe(MIT)负责把 Chat Completions、Messages、Responses 等格式请求统一转换并编码,对齐官方 API 行为。
核心要点速览
- ✓DeepInfer 以 Apache 2.0 开源,官方称即支撑 DeepSeek-V4.1-Flash 线上服务的推理框架,目前只支持这一个模型
- ✓硬件仅支持 NVIDIA SM100(Blackwell)GPU 和华为昇腾 950 NPU;官方性能曲线测于 4 卡 prefill、64 卡 decode
- ✓开源版缺 KV cache 系统、VE/Prefill/Decode 分离和多副本负载均衡三块,离完整线上服务还有距离
- ✓官方给出的 V4.1 参考成绩(Pass@1,厂商口径):AIME 2026 99.9%、GPQA Diamond 93.4%、HLE-Full 42.6%,用于校验部署是否配置正确
- ✓同步开源 deepseek-recipe(MIT,Rust+Python 绑定),统一处理 Chat Completions/Messages/Responses 请求转换与 token 编解码
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
DeepSeek 的开源权重一直很受欢迎,但社区部署 V4.1-Flash 这类带 Engram、SWA 的新架构时,往往要等 vLLM、SGLang 适配,效果和官方 API 也难对齐。10 月 20 日,DeepSeek 把支撑线上服务的推理框架 DeepInfer 开源,并称后续新模型的推理代码也会放在这里。
架构亮点与底层机制
据 GitHub 仓库,DeepInfer 最初主要基于 vLLM 构建,内核层用 FlashMLA、DeepGEMM、DeepEP、TileKernels 和自研 TileLang 算子。并行支持 Attention DP/均衡 CP 和 MoE EP+EPLB;DSpark 用草稿 token 加速解码,并按置信度调度验证;SWA bounded replay 只重放有限后缀以减少 prefill;另有零开销异步调度、批次不变推理、确定性采样,以及 regex/JSON Schema/EBNF 结构化输出。同步开源的 deepseek-recipe 负责请求格式转换与编解码,对齐官方 API 行为。
权威 Benchmark 与实测跑分对比
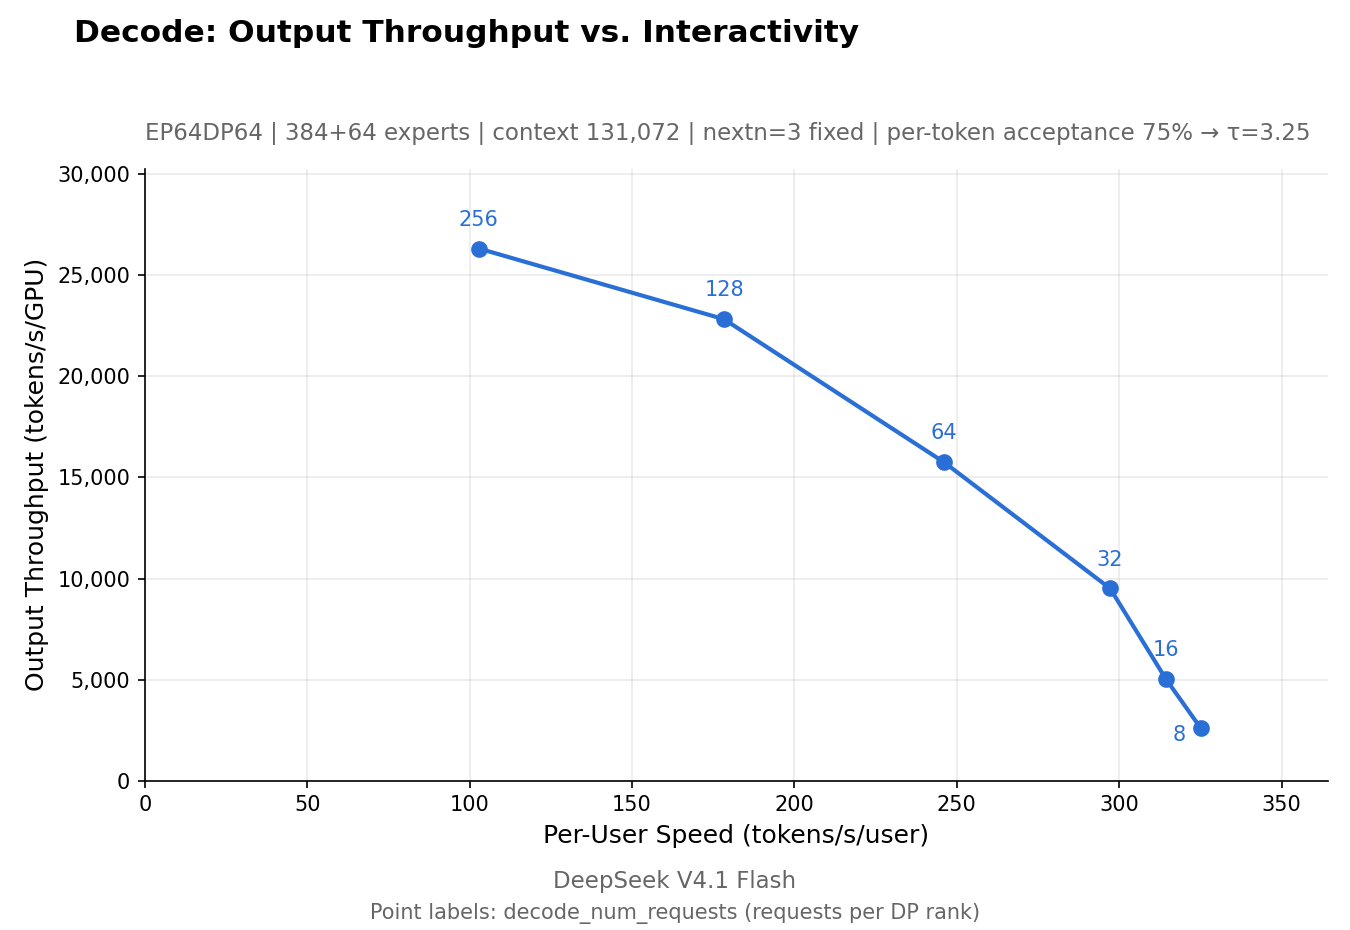
官方仅给出吞吐-延迟曲线图(prefill 4 卡、decode 64 卡),未公布与 vLLM、SGLang 的具体对比数字。V4.1 参考成绩(厂商口径)为 AIME 2026 99.9%、GPQA Diamond 93.4%、HLE-Full 42.6%,用于校验部署是否正确。
开发者实战落地与开箱指南
- 硬件门槛高:只支持 NVIDIA SM100 或昇腾 950,需 Linux、Python 3.12、GCC 13+、CUDA 13 或 CANN 9.2。
- 设置
DEEPINFER_ACCELERATOR后运行./build.sh,再用examples/offline_inference.py跑离线推理。 - 开源版不含 KV cache、PD 分离和负载均衡,想做线上服务需自行补齐,或继续用 vLLM/SGLang。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察