

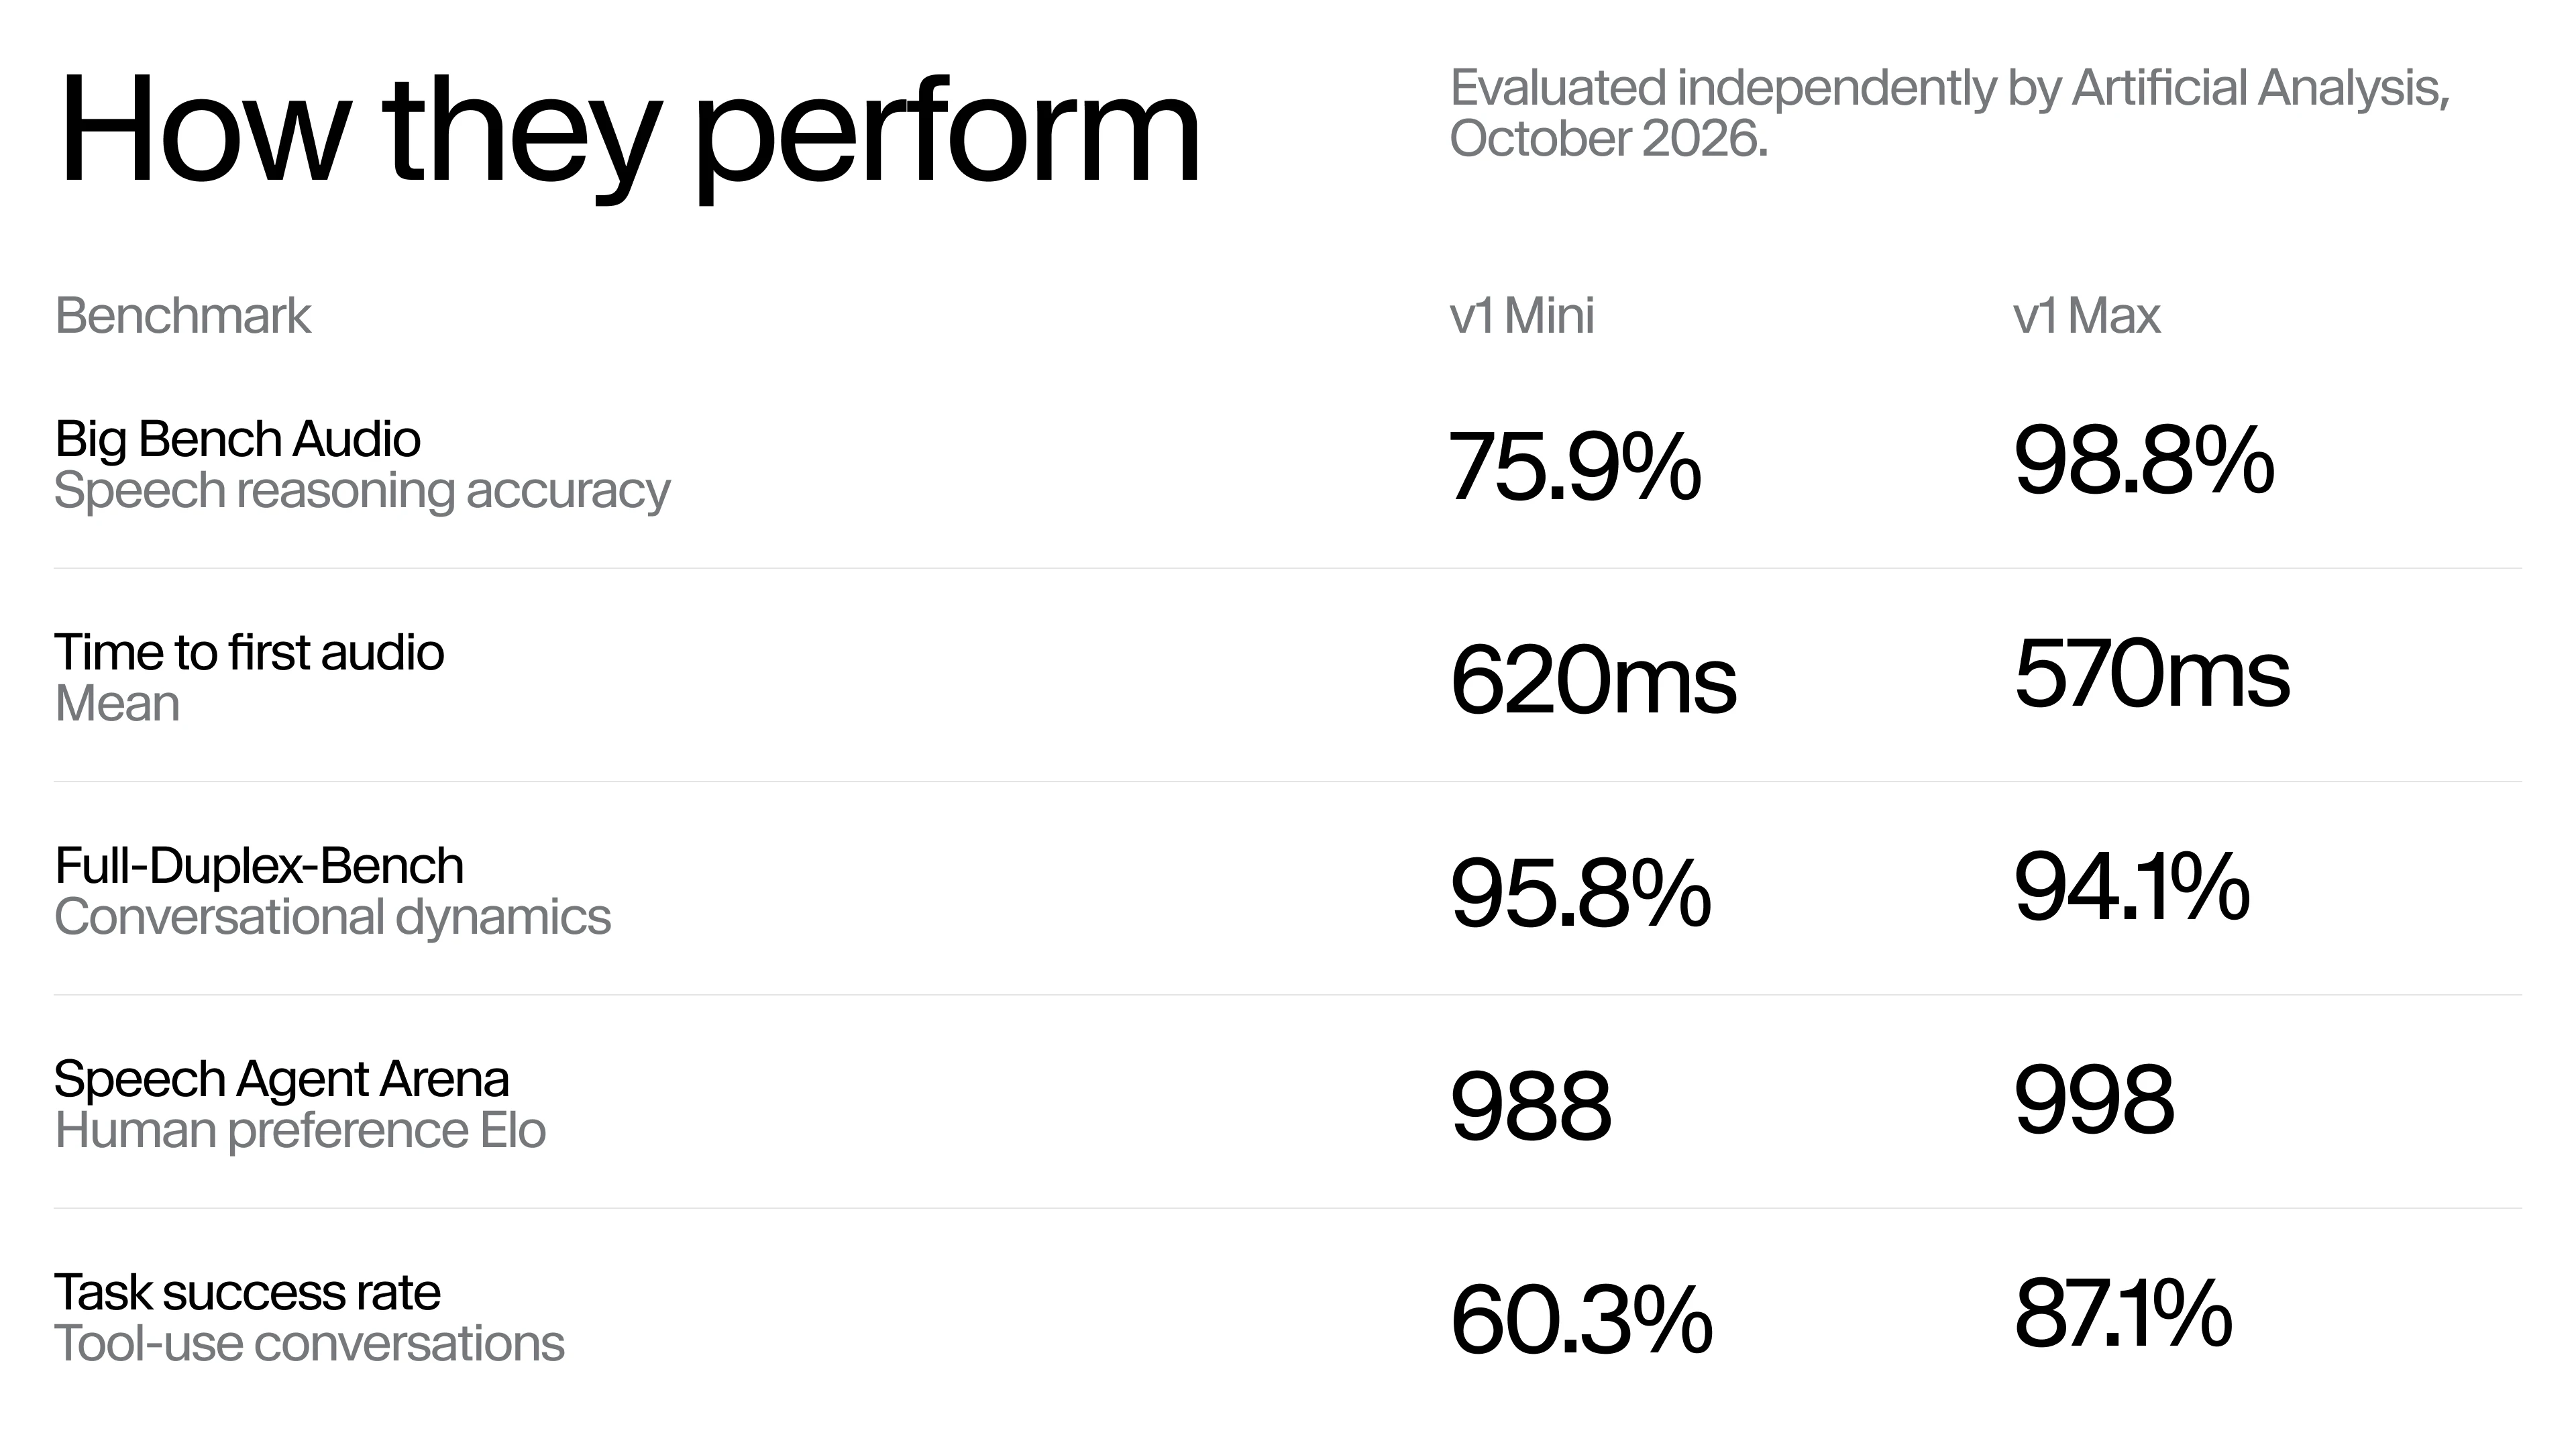
10 月 20 日,ElevenLabs 发布 Eleven Realtime,一类端到端语音到语音模型,每个模型本身就是完整的语音 Agent,不再需要自己拼语音识别、大模型和语音合成。v1 Mini 主打低成本自然对话,v1 Max 面向客服和多步骤工具调用。两者支持 90+ 语言、可用 17,000+ 种音色。官方引用 Artificial Analysis 独立评测:Max 在 Big Bench Audio 答对 98.8%、平均 0.57 秒开始说话。接口兼容 OpenAI Realtime API,改端点和模型名即可迁移。
核心要点速览
- ✓语音推理(Artificial Analysis 独立评测,官方引用):Big Bench Audio 1,000 道语音推理题,v1 Max 答对 98.8%,v1 Mini 75.9%
- ✓速度(官方口径):Max 平均 0.57 秒开始说话,Mini 0.62 秒;官方推文说「半秒开口」,发布文给出的实测略高于半秒
- ✓对话动态与偏好:Full-Duplex-Bench 上 Mini 95.8%、Max 94.1%;Speech Agent Arena 盲测 Max 998 分、Mini 988 分
- ✓工具调用任务完成率 Max 87.1%、Mini 60.3%,官方因此建议重度调工具的场景用 Max
- ✓覆盖 90+ 语言、17,000+ 音色;Realtime API 走 WebSocket(
wss://api.elevenlabs.io/v1/convai/realtime),可直接用 OpenAI 官方 SDK,发布文未公布价格
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
做一个听起来自然的语音 Agent,通常要自己挑语音识别、语音活动检测、轮次切换、大模型和语音合成,再反复调它们之间的配合。ElevenLabs 的判断是开发者不该先变成配置专家,所以把整条链路做进一个模型。同一天 Mistral 发布的 Voxtral 3 语音 Agent SDK 走的是串联管线路线,两种思路正好形成对照。
架构亮点与底层机制
Eleven Realtime 是语音到语音模型,直接听、想、说。v1 Mini 面向助手、教学和互动角色,官方说大多数场景够用;v1 Max 会先推理再回答,适合要按流程走的客服和线索筛选。两者都支持 90+ 语言,可调用 ElevenLabs 库里 17,000+ 种音色,接口遵循 OpenAI Realtime 规范。
权威 Benchmark 与实测跑分对比
以下为 ElevenLabs 引用的 Artificial Analysis 独立评测。Big Bench Audio 上 Max 答对 98.8%、Mini 75.9%;平均开口时间 Max 0.57 秒、Mini 0.62 秒,比推文里的「半秒」略慢。Full-Duplex-Bench 上 Mini 95.8% 反超 Max 的 94.1%;Speech Agent Arena 盲测 Max 998、Mini 988;工具调用任务完成率 Max 87.1%、Mini 60.3%。官方发布文未公布价格。
开发者实战落地与开箱指南
官方推荐在 ElevenAgents 里新建或打开 Agent,在下拉框选 Realtime 模型,即可使用电话、网页、WhatsApp 和呼叫中心渠道、知识库和监控。已经接了 OpenAI Realtime 的应用,把 WebSocket 地址改成 wss://api.elevenlabs.io/v1/convai/realtime、模型改成 eleven_realtime_v1_mini 就能试。注意它只支持 WebSocket,WebRTC 需先迁移,且独立 API 不带 ElevenAgents 的渠道和知识库。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察