
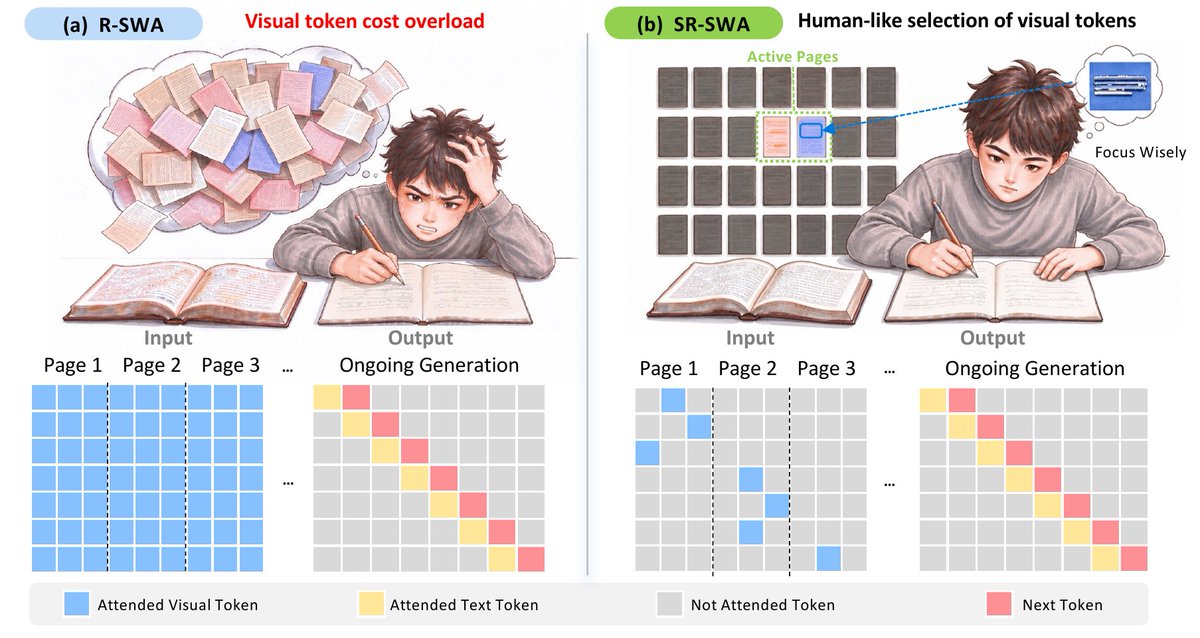
百度官方账号 @Baidu_Inc 10 月 27 日宣布开源 Unlimited OCR 2,以 MIT 协议发布在 Hugging Face。新的 SR-SWA 稀疏参考滑窗注意力把图文注意力压缩到固定大小的参考集合,官方称可在有限上下文内解析任意长度文档,在几十页的 MPDocBench 得 84.6、上百页的 MarathonDocBench 得 77.1,均为厂商自测。
核心要点速览
- ✓SR-SWA 把超长序列的图文注意力压缩到固定大小的参考集合(如 512 token),官方称每步解码延迟和显存几乎不随页数增长
- ✓官方口径:MPDocBench 总分 84.6,比次优的 Qwen3.8-Max(78.3)高 6.3 分
- ✓官方口径:MarathonDocBench 总分 77.1,比次优的 Kimi-K3(33.7)高 43.3 分;一代 Unlimited-OCR 在该榜为 0
- ✓权重以 MIT 协议发布在 Hugging Face,约 3.3B 参数(按 HF 权重统计),支持 Transformers 和定制版 SGLang 部署
- ✓所有跑分均为百度自测,尚无第三方复现
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
RAG 和 Agent 常要把几十到上百页的扫描件转成结构化文本。逐页 OCR 会丢掉跨页表格和段落,整份塞进多模态模型又会让注意力计算和 KV 显存随页数膨胀。百度 6 月开源的一代 Unlimited-OCR 基于 DeepSeek-OCR 思路,10 月 27 日官方账号 @Baidu_Inc 宣布开源二代 Unlimited OCR 2。
架构亮点与底层机制
核心是 SR-SWA(稀疏参考滑窗注意力):把超长序列里的图文注意力交互压缩成固定大小的工作参考集合(模型卡举例 512 token),让每步解码的计算量有上界。官方称因此可在有限上下文窗口内解析任意长度文档,解码延迟和显存几乎不随文档变长而增长。按 Hugging Face 权重统计约 3.3B 参数,MIT 协议。
权威 Benchmark 与实测跑分对比
以下均为百度官方口径:MPDocBench(几十页)总分 84.6,高于 Qwen3.8-Max 的 78.3 和 Gemini-3.8-Flash 的 76.2;MarathonDocBench(上百页)总分 77.1,次优的 Kimi-K3 为 33.7,一代 Unlimited-OCR 为 0。目前没有第三方复现。
开发者实战落地与开箱指南
权重在 Hugging Face 的 baidu/Unlimited-OCR-2,可用 Transformers 的 infer_multi 一次传入多页图片做跨页解析,也可装官方定制的 SGLang wheel 起 OpenAI 兼容服务。模型卡建议超长文档按 10 页一窗调度,mem-fraction-static 设 0.7 更稳。上生产前建议用自己的长文档对比表格和阅读顺序准确率。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察