

Mamba 作者、Cartesia 首席科学家 Albert Gu 团队 10 月 28 日发布两篇研究博客,公布新一代分层网络 H-Net 的扩展结果:在严格对照的 scaling ladder 中,只把 BPE 分词换成学习式动态分块,就获得最高 3–5 倍计算效率提升;更大的两阶段字节级 H-Net(3.67B 参数)在与 SmolLM3-3B 每字节算力对齐的条件下,约 1T token 即达到 SmolLM3 训练 11T token 后的平均下游分数(厂商口径)。新架构尚未开源,官方称计划逐步发布。
核心要点速览
- ✓对照实验(官方口径):1 阶段 H-Net 直接替换 BPE,验证损失约 1.3 倍、代码约 2 倍计算效率,整体最高 3–5 倍
- ✓大模型对比:两阶段字节级 H-Net 3.67B 参数 vs SmolLM3 3.08B,每字节 FLOPs 相差在 2% 以内,约 1T token 追平对方 11T token 的六项任务平均分
- ✓代码收益更明显:训练分布内 15 种语言倍数 1.49x–2.40x(中位 2.04x),分布外 10 种语言中位 3.10x,Prolog 最高 5.37x
- ✓训练数据配比为英文 70%、代码 20%、数学 5%、多语言 5%;主网络约每 7.6 字节处理一个位置,外层编解码占约 43% FLOPs
- ✓官方未公布权重与代码,称会把部分架构逐步开放;原始 H-Net 论文为 arXiv 2507.07955
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
今天的大模型几乎都依赖 BPE 这类手工设计的分词器:先把文本切成固定词表的片段再训练。分词器在代码、多语言、生僻格式上表现不稳定。Cartesia 首席科学家、Mamba 作者 Albert Gu 在 X 上发帖称,能否端到端地从字节学习语言,是检验通用学习方法的核心问题。
架构亮点与底层机制
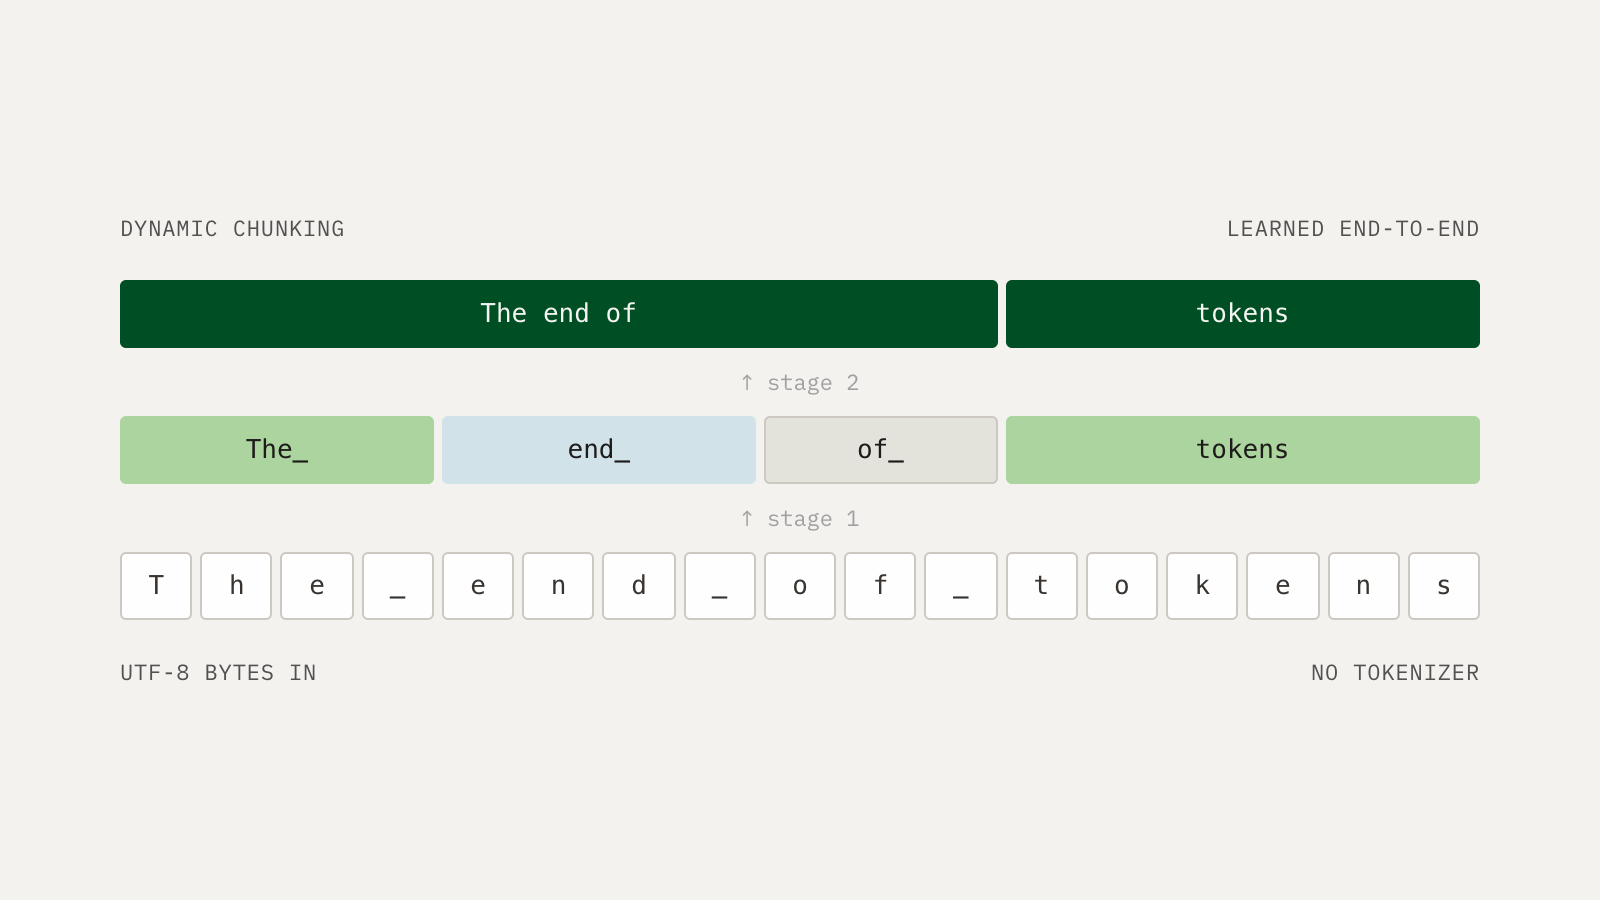
H-Net(分层网络)于 2025 年提出(arXiv 2507.07955),本次是大幅改进的新版本。它由编码器、学习式动态分块、主网络、反分块和解码器五部分组成,在模型内部把字节动态压缩成块,并可递归嵌套。本次大模型为两阶段结构:外层用 Mamba-2 层,第二阶段加滑动窗口注意力,主网络是 40 层 Transformer,主网络约每 7.6 字节处理一个位置。
权威 Benchmark 与实测跑分对比
以下均为 Cartesia 官方口径,尚无第三方复现。对照 scaling ladder 中,H-Net 在验证损失上约 1.3 倍、代码约 2 倍计算效率,分布外代码最高 5.37 倍(Prolog)。对比 SmolLM3-3B(总训练 11.1T token),每字节算力对齐的 3.67B H-Net 约 1T token 即达到其最终六项任务平均分。
开发者实战落地与开箱指南
目前没有公开权重、代码或 API,开发者暂时只能阅读两篇博客和原论文;Cartesia 表示计划逐步开放部分架构,并会把它用于直接从原始音频学习的语音模型。关注点:代码与多语言场景的收益,以及第三方能否在更大规模复现。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察