

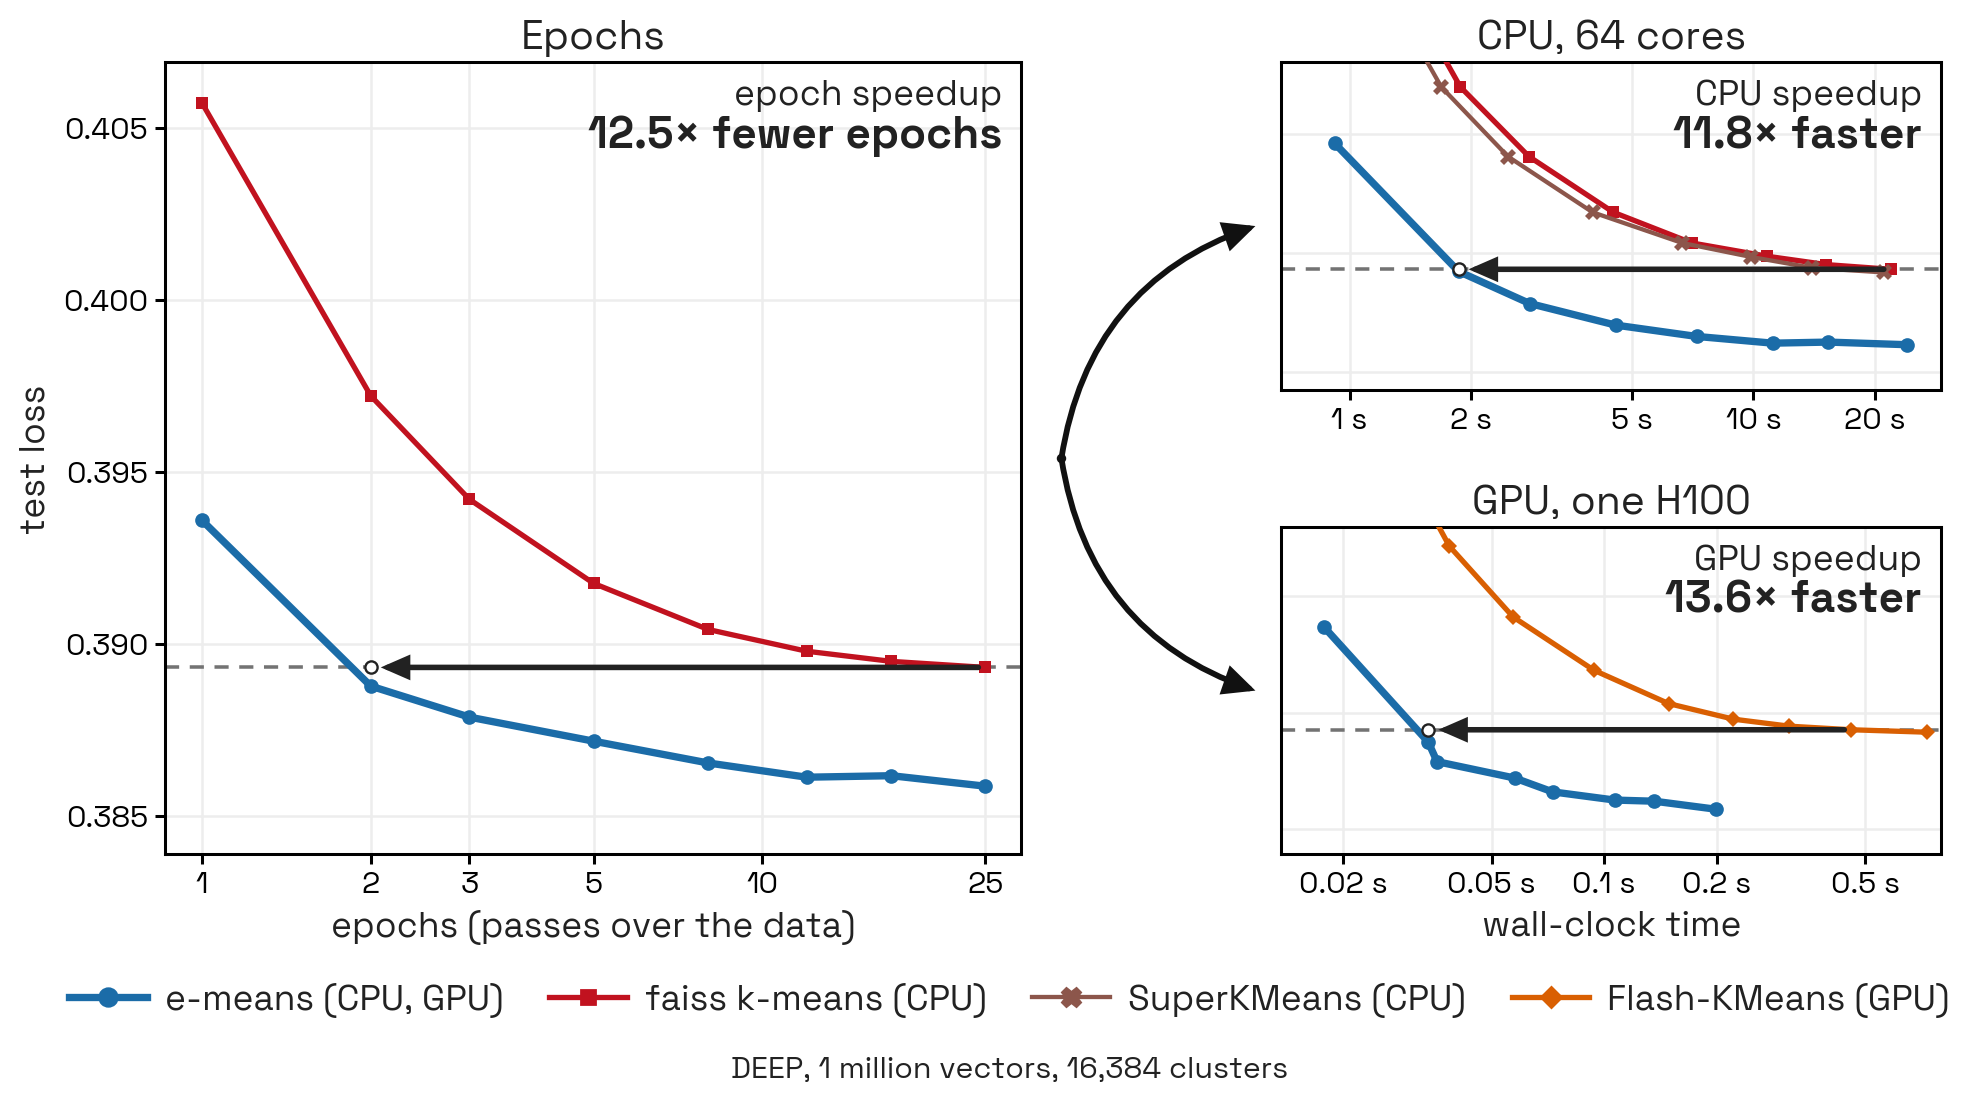
Meta FAIR 研究员 Swann Bessa 11 月 10 日在 X 上发布 e-means,这是一种替代经典 Lloyd k-means 的聚类算法,已随 FAISS 1.16.0 开源。它用小批量更新加指数移动平均取代全量迭代,批大小和步长由拟合出的缩放定律自动设定,除簇数 k 外无需调参。论文称,在多个嵌入数据集上,e-means 只需 1.4–2.6 轮就低于 Lloyd 跑 25 轮的误差,GPU 端比 Flash-KMeans 快 10–45 倍,CPU 端比 FAISS 自带 k-means 快 8–15 倍(作者口径)。对建向量索引、做 RAG 和数据去重的团队,这一步可以直接提速。
核心要点速览
- ✓轮数:在多个嵌入数据集上 1.4–2.6 轮即低于 Lloyd 25 轮的测试误差;VIBE 基准 11 个数据集每个只需 1.6–2.4 轮(论文/作者口径)
- ✓速度:GPU 端比 Flash-KMeans 快 10–45 倍,CPU 端比 FAISS k-means 快 8–15 倍;单张 H100 上 1000 万向量、65,536 簇,Flash-KMeans 25 轮需 14–22 秒
- ✓规模:把 100 亿条 DINO 嵌入分成 1600 万簇,只用 2.5 轮就低于 Lloyd 25 轮的误差
- ✓死簇:100 万向量、k=16,384 时,按比例拆分大簇的复活策略让死簇降到 0.1%–0.3%,EnCodec 式重采样为 4.6%–14.3%
- ✓上手:
from faiss.contrib.e_means import Emeans,默认 5 轮,支持 PyTorch 与 NumPy,论文 arXiv:2611.09501
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
k-means 是向量检索、RAG、量化和数据清洗的基础一步:FAISS 建 IVF 索引、给语料去重聚类都要先跑它。主流的 Lloyd 算法每轮要扫完全部数据才更新一次中心,通常要跑 20–50 轮,数据到亿级时这一步很耗时。现有的小批量方法大多沿用 1967 年的 MacQueen 规则,还容易出现「死簇」。
架构亮点与底层机制
e-means 每个小批量都更新每个簇的计数和向量和,用指数移动平均逐步淡化旧分配,中心取二者之比。批大小和初始步长由论文拟合的缩放定律按数据量、簇数和轮数自动算出,步长按余弦退火。它还改进了初始化,用「按大小拆分大簇」复活死簇,最后一轮取每簇精确均值,并配有融合 GPU 内核。
权威 Benchmark 与实测跑分对比
以下为论文和作者口径:多个嵌入数据集上,e-means 1.4–2.6 轮即低于 Lloyd 25 轮的误差,GPU 端比 Flash-KMeans 快 10–45 倍,CPU 端比 FAISS k-means 快 8–15 倍;100 亿条 DINO 嵌入分 1600 万簇只用 2.5 轮。玩具实验 200 次随机起点中,Lloyd 陷入局部最优的比例为 15.5%–46%,e-means 为 0%–4%。目前暂无独立第三方复现。
开发者实战落地与开箱指南
e-means 已在 FAISS 1.16.0 的 faiss/contrib/e_means 中开源,用 Emeans(d, k, nepochs=T) 创建后调用 train(x) 即可得到中心和标签,NumPy 用户可用 NumpyEmeans。建议先在自己的嵌入上对比 Lloyd 的测试误差和耗时,再替换 IVF 训练流程。项目页提供浏览器内的交互演示。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察