

OpenAI 在对齐研究博客发布《What affects chain-of-thought monitorability across the model lifecycle?》,用「无 CoT 推理能力」和「CoT 可控性」两个代理指标,追踪从 GPT-5 到 Astra 级模型的思维链可监控性。四个结论:无 CoT 能力随基座困惑度下降平滑提升;部分架构在多跳规划和串行计算上超出困惑度预期;只有长度约束和最终答案评分的 RL 也会显著抬高 CoT 可控性;这种可控性还能通过 SFT 从教师模型传给学生模型。OpenAI 称结论「令人清醒」,但也强调可控性只是嘈杂的代理指标,在一对能力相当的模型上没有看到它与监控规避存在明显关联。
核心要点速览
- ✓覆盖 GPT-5(2025 年 8 月)到 Astra 级(2026 年 9 月) 的内部与已发布模型,用 NCRI、Think Fast 和两项内部无 CoT 评测衡量
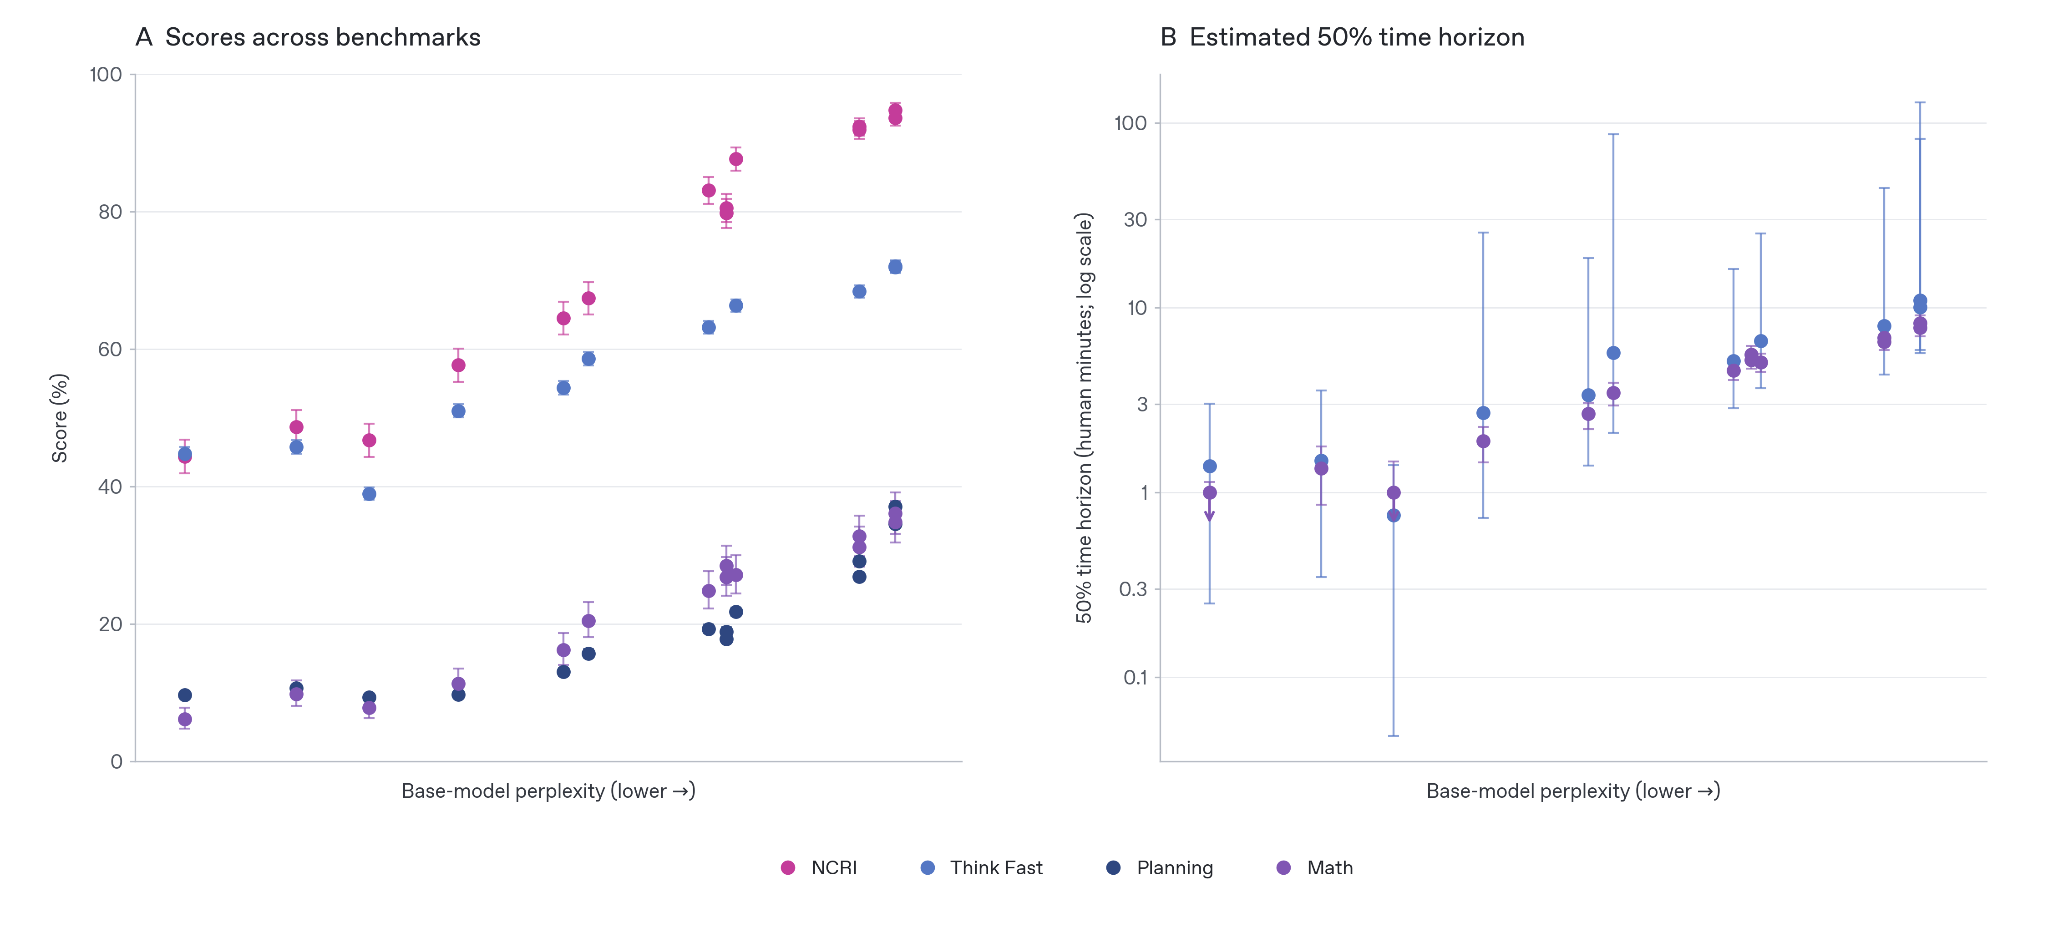
- ✓无 CoT 能力是基座困惑度的平滑函数:按困惑度看,GPT-6 Astra 并未偏离趋势,尽管英国 AISI 曾判定它在数学时间跨度上偏离历史进度
- ✓对比 3 种架构:多数评测由困惑度决定,但「架构 2」在多跳规划和串行计算上明显超出预期
- ✓Astra 级模型在只有长度约束和最终答案评分的 RL 中 CoT 可控性大幅上升;Terra 级模型加上工具访问和工具监督只带来小幅额外提升
- ✓用 2 个能力相当、可控性不同的教师做 SFT,学生模型保留了同样的可控性差距;但在监控规避评测上未见可控性与规避成功率的明显关联
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
OpenAI 把思维链(CoT)监控当作可扩展监督和安全论证的关键一环:CoT 里通常会暴露模型的意图和不当行为计划。但 OpenAI 在 GPT-6 Astra 上观察到非对抗场景下 CoT 可监控性下降、对抗测试中规避监控的能力变强,无 CoT 推理能力也明显更高。这篇由 Jeffrey Wang 等人撰写、Jakub Pachocki 参与指导的研究,想弄清训练流程中的哪些环节在削弱可监控性。
架构亮点与底层机制
研究用两个代理指标:「无 CoT 能力」指不输出思维链和工具调用、只靠一次前向传播的推理能力;「CoT 可控性」指按提示在思维链里添加、删除或改写内容的能力,例如每句末尾加 safe、词间插入 meow、全部小写或大写。结论覆盖四个环节:预训练困惑度越低,无 CoT 能力越强;部分架构在多跳规划和串行计算上超出困惑度预期;RL 即使没有过程监督也会抬高可控性;可控性还能通过在模型生成数据上做 SFT 传给下一代,类似「潜意识学习」。
权威 Benchmark 与实测跑分对比
博客只给出图表和趋势,没有公布具体分数。评测包括 NCRI、Think Fast、内部无 CoT 规划与数学评测,以及 Astra 系统卡中的数学附带任务监控规避和多选题能力藏拙。OpenAI 也强调,在一对能力相当的模型上,可控性更高的那个并没有更会规避监控,说明可控性只是嘈杂的代理指标。
开发者实战落地与开箱指南
对搭建 Agent 安全体系的团队,这项研究的提示是:不要只靠读思维链来发现问题,应同时监控完整轨迹,包括工具调用、终端和浏览器操作。用强模型的输出做蒸馏时,CoT 可控性等特性也可能一并传过去,最好在训练前后跑可控性和监控规避评测。OpenAI 表示自 GPT-6 Astra 起已在前沿 RL 和上线前审查中追踪监控规避能力,并预计未来的预训练进展需要新的监控方法。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察