AI 编程实时动态与要闻

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

NVIDIA AI 官方账号 10 月 28 日发布 Nemotron 3.5 Transcribe,权重已上架 Hugging Face 和 ModelScope。它是可用自然语言指令驱动的离线语音模型,一个检查点同时做 40 种语言转写、31 种语言与英语互译、13 种语言的说话人标注和音频问答,可处理最长 1 小时录音、最多标注 8 位说话人。官方称它在 Hugging Face Open ASR 英文榜以 5.33% 平均 WER 居开源模型第一;Artificial Analysis 测得 AA-WER 2.8%,与 24B 激活参数的 Voxtral Small 并列开源第一。权重、Granary v2 训练数据和微调配方一并开放。

NVIDIA 开源 Nemotron 3.5 Transcribe:30B MoE 仅约 4B 激活,一个模型做 40 语种转写、说话人标注和翻译,Open ASR 英文榜开源第一

核心要点速览

  • 架构:语音编码器加 Mamba-2/Transformer 混合 MoE 语言模型,总参数约 30B(模型卡含音频编码器计为 34B),每 token 激活约 4B(模型卡为 4.3B),提供 BF16、FP8、NVFP4 版本
  • 能力:40 语种转写、31 语种与英语互译、13 语种说话人标注、音频问答(问答仅英语训练)、词级时间戳,单段最长 1 小时、最多 8 位说话人
  • 官方/第三方口径:Open ASR 英文榜开源第一(平均 WER 5.33%),多语种 7 语言平均 4.62%,长音频 10.98%;Artificial Analysis AA-WER 2.8%,语音智能体对话集 AA-AgentTalk 1.8%(次优开源 2.3%)
  • Artificial Analysis 在 DeepInfra 托管端点实测:速度因子 75 倍,1 分钟音频不到 1 秒转完,价格每 1000 分钟 2 美元
  • 许可为 OpenMDW-1.1,可商用;配套开放 Granary v2 数据和 NeMo Speech 微调工具,官方医疗案例中微调比最佳提示词再降 45.8% 相对 WER
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Transcribe 30B-A4B⚡ Voxtral Small🌐 NVIDIA🌐 Hugging Face🌐 Artificial Analysis

蚂蚁 inclusionAI 开源 5 款 Ming-3.0 语音模型:0.5B TTS 拿下开源权重音色控制第一,126B MoE 音频理解模型同步发布

蚂蚁 Ant Ling(inclusionAI)10 月 19 日以 MIT 协议开源 Ming-3.0 的 5 个模型,覆盖语音合成(tts-0.5B、tts-tiny 7.9B/1.3B 激活)、音频理解(audio-flash 126B/6.5B 激活、audio-tiny 9.3B/2.7B 激活)和语音识别(asr-tiny 8.6B/2B 激活)。官方称 tts-0.5B 在 Artificial Analysis Controlled Voice 榜以 1069 Elo 位列开源权重第一,发音稳健性 93.2% 并列全榜第一;asr-tiny 四类 ASR 平均错误率 4.41%。权重已上 Hugging Face 和 ModelScope,SGLang 与 vLLM 首日支持。

蚂蚁 inclusionAI 开源 5 款 Ming-3.0 语音模型:0.5B TTS 拿下开源权重音色控制第一,126B MoE 音频理解模型同步发布

核心要点速览

  • 阵容:3 个系列 5 个模型,TTS 2 个、音频理解 2 个、ASR 1 个,全部 MIT 协议。
  • TTS 成绩:tts-0.5B 在 AA Controlled Voice 获 1069 Elo,开源权重第一;Provider Voice 1188 Elo 排第 3;发音稳健性 93.2% 并列全榜第一(官方口径)。
  • TTS 能力:支持 7 种语言加四川话、粤语,14 种行内副语言标签(笑声、叹气、咳嗽等),44.1 kHz 输出,基于 Qwen2.5-0.5B。
  • 音频理解:audio-flash 总参 126B、每步激活 6.5B,可做长录音总结、语音问答、音频推理并生成工具调用请求。
  • ASR:asr-tiny 支持热词和对话上下文,在 15 个方言测试集上评测,四类任务平均错误率 4.41%(官方口径)。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ming-3.0-tts-0.5B⚡ Ming-3.0-tts-tiny⚡ Ming-3.0-audio-flash⚡ Ming-3.0-audio-tiny⚡ Ming-3.0-asr-tiny🌐 Ant Group🌐 inclusionAI🌐 SGLang🌐 vLLM

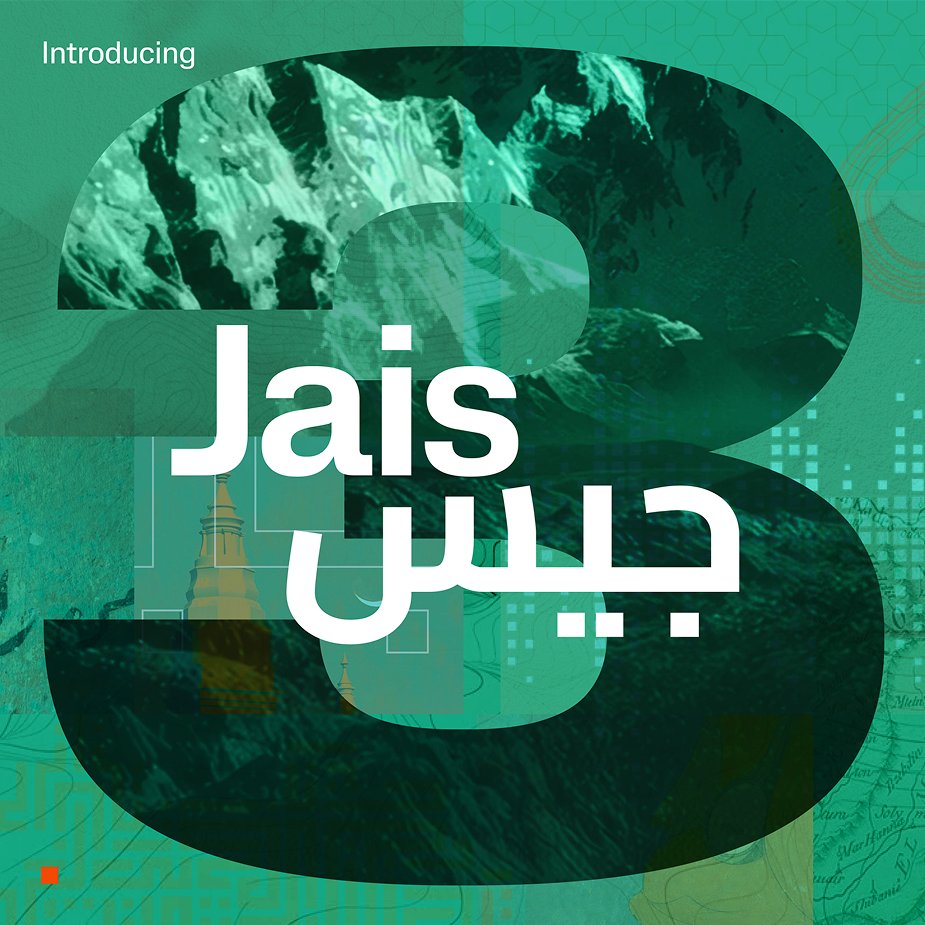
MBZUAI IFM × Inception42 发布 Jais 3:六档开源阿拉伯语智能体模型(0.9B–375B)+ Jais Speech,512K 上下文落地 Hugging Face

阿联酋 MBZUAI 旗下 Institute of Foundation Models(IFM)与 Inception42 于 2026-10-15 正式发布 Jais 3:在开源底座 K2 Horizon 上做的首个语言适配,提供六档开源权重(0.9B 稠密至 375B-A23B 稀疏 MoE,每 token 激活约 23B)与阿拉伯语 ASR 模型 Jais Speech。全系列共享训练配方与智能体能力,上下文最长 512K(0.9B 为 128K),Apache-2.0,权重与分阶段 checkpoint 已上 Hugging Face,vLLM 宣布 Day-0 支持。

MBZUAI IFM × Inception42 发布 Jais 3:六档开源阿拉伯语智能体模型(0.9B–375B)+ Jais Speech,512K 上下文落地 Hugging Face

核心要点速览

  • 规模:六档 0.9B / 3.7B / 7B / 32B 稠密 + 36B-A4B(MoE+MoVA,约 4B 激活)+ 375B-A23B(约 23B 激活);旗舰需约 8×H200 BF16 节点(模型卡)
  • 官方自测阿拉伯语均分:375B 开源对照最高 84.0(Qwen3.5-397B 82.0);7B 79.4,相对同尺寸 K2 Horizon 基座 56.4→79.6(技术博客)
  • 智能体:3.7B/7B 在同尺寸对照中领先约 20 分;375B agentic average 60.2,SWE-Bench Verified 70.2、Terminal-Bench 2.1 73.8(官方同 harness 复测)
  • 语音:Jais Speech 在六套公开 ASR 测试宏平均 WER/CER 22.85/8.37,低于 Audar、Cohere Transcribe Arabic、omniASR 等对照(Jais 页)
  • 开箱:Apache-2.0;HF 集合 IFM/jais-3;vLLM≥0.30 / SGLang≥0.5.20 参考配方;推理 parser k2_horizon;配对 github.com/ifm-ai/JaisVoice
阅读全文
关联模型 / 智能体 / 厂商:

Meta 发布 Muse Voice Transcribe:实时多语 ASR,支持 20+ 说话人分离,API 约 0.18 美元/小时

Meta Superintelligence Labs 于 9 月 1 日推出首个实时音频感知模型 Muse Voice Transcribe:流式 ASR、20+ 说话人 diarization、endpointing,原生支持句内/句间语码转换,训练覆盖 70+ 语言(首发验证 25 种),可处理超一小时音频。官方称在 Artificial Analysis 流式语音转写榜单排名第一(截至 9 月 1 日)。已接入 Meta AI for Mac(按住 Fn 全局听写)、Muse Code,并向 Meta Model API 开放,定价为每 1000 音频分钟 3 美元(约合每小时 0.18 美元)。

核心要点速览

  • 流式 ASR + 说话人分离 + 端点检测一体,无需后处理拼流水线
  • Mac 全局听写与 Muse Code 已切换到该模型;开发者可走 Meta Model API
  • API 价约 0.18 美元/小时;自适应 delay 在速度与准确率之间动态权衡
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Muse Voice Transcribe⚡ Muse Spark🤖 muse-code🌐 Meta AI
AD赞助内容

VS Code 中 Copilot 听写默认改用端侧多语言模型,音频不出本机

GitHub 宣布 VS Code 中的 Copilot 听写默认改用多语言端侧模型,音频留在本机。可跟随配置语言、系统/浏览器区域设置,或自动检测语种。对在编辑器里用语音下指令、写注释或驱动智能体的开发者,这把听写从云端 ASR 收成默认本地推理,降低延迟与代码语境外泄面。企业场景下,语音控制 Copilot 不再默认把原始音频送出设备。

核心要点速览

  • VS Code 听写默认使用端侧多语言模型,原始音频留在本机。
  • 可按配置语言、系统/浏览器区域或自动检测语种工作。
  • 语音驱动 Copilot 的默认路径不再把音频送出设备,利于低延迟与企业合规。
阅读全文
关联模型 / 智能体 / 厂商:

xAI 把 Grok Voice 接入 LiveKit:STT、Grok 4.3 与 TTS 同会话级联,全链路 ZDR

SpaceXAI 宣布可在 LiveKit 中使用 Grok Voice 模型构建语音代理,并支持零数据保留(ZDR)。LiveKit 演示了端到端患者预问诊代理:Grok STT → Grok 4.3 → Grok TTS 在同一 AgentSession 中级联,无需多套 API Key 与账单。开发者可用三条模型字符串拼出语音智能体,适合客服、预问诊与工具调用场景。

核心要点速览

  • Grok Voice 可在 LiveKit 构建语音代理,全链路支持 ZDR。
  • STT、Grok 4.3 与 TTS 可在同一 AgentSession 级联,无需多套密钥与账单。
  • 官方示例为患者预问诊,面向可调工具的实时语音智能体。
阅读全文
关联模型 / 智能体 / 厂商: