AI 编程实时动态与要闻

Cartesia 发布语音 Agent 平台 Managed Agents:Speech Agent Arena 30 个系统中排第 1,上线价每分钟 0.03 美元

语音模型公司 Cartesia 于 10 月 29 日发布 Managed Agents,一个面向企业电话场景的端到端语音 agent 平台,把自家语音识别、语音合成模型与 agent 框架一起设计调优,并自带电话接入、知识库、工具调用和批量外呼。官方称它在 Artificial Analysis 的 Speech Agent Arena 中以 1115 Elo 排第 1,在 ServiceNow 的 EVA-Bench 上拿到 87.4% 准确率和 90.7% 体验分(均为厂商口径,推理模型为 GPT-5.5);上线期价格打五折,为每分钟 0.03 美元。

Cartesia 发布语音 Agent 平台 Managed Agents:Speech Agent Arena 30 个系统中排第 1,上线价每分钟 0.03 美元

核心要点速览

  • Artificial Analysis Speech Agent Arena 盲测偏好中,Managed Agents 以 1115 Elo 在 30 个 agent 中排第 1,高于 Gemini 3.1 Flash Live Minimal(1099)、Grok Voice 3.0(1064)和 GPT-Live-1(1041)(Cartesia 博客,厂商引用口径)
  • ServiceNow EVA-Bench 200 多个客服、IT 服务和 HR 场景首轮成绩:准确率 87.4%、体验分 90.7%,对比 Grok Voice 3.0 为 73.7%/71.2%、GPT Realtime 2.1 为 59.0%/61.6%(EVA-Bench)
  • 以上跑分都以 GPT-5.5 作为推理模型;Cartesia 内部评测称 85% 的通话没有抢话/打断问题,其他 agent 为 67%
  • 上线期五折,每分钟 0.03 美元;官方称该平台此前已在金融、零售、酒店、医疗场景跑过数千万次对话
  • 支持 44 种语言,目前英语、西班牙语、印地语、法语、日语可在通话中途切换,其余语言「即将支持」
阅读全文

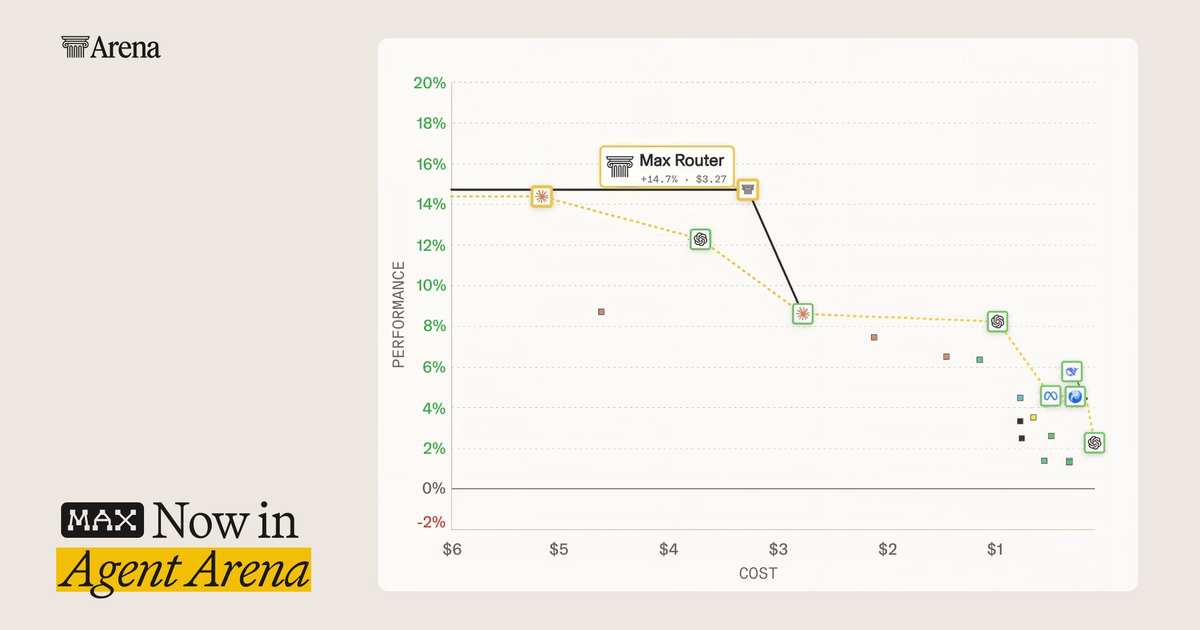
Arena 发布 Agent 版 Max 路由器:基于 250 万真实会话训练,在 Agent Arena 以低 37.5% 的成本追平 Fable 5.1 (Max)

Arena(原 LMArena)发布 Agent 版 Max 路由器:基于 250 万+ 次真实 Agent Arena 会话训练,按任务复杂度、类型与成本在 Fable 5.1 (Max)、Astra (Max) 与 Astra (Medium) 间动态选模型。实测中它以 +14.7% 得分登顶 Agent Arena,单任务中位成本 3.27 美元,比当时第一的 Fable 5.1 (Max) 高 0.3% 且便宜 37.5%;代码会话 67% 被路由到更便宜的 Astra (Medium)。现可在 Agent Mode 限时免费试用,API 需填表申请。

Arena 发布 Agent 版 Max 路由器:基于 250 万真实会话训练,在 Agent Arena 以低 37.5% 的成本追平 Fable 5.1 (Max)

核心要点速览

  • 训练数据:250 万+ 次真实 Agent Arena 会话;过去 4 个月 Arena 共测试 60+ 个 Agent 模型(官方博客)
  • 实测成绩:Agent Arena 第 1,得分 +14.7%,单任务中位成本 3.27 美元;比 Fable 5.1 (Max) 高 0.3%,成本低 37.5%
  • 路由分布:代码 67% → Astra (Medium);聊天 Astra (Max) 49% / Fable 5.1 (Max) 42%;工作类 Fable 5.1 (Max) 49% / Astra (Medium) 43%
  • 可换模型组合:此前 Fable 5 + Kimi K3 组合净提升 +10.7%,中位成本 1.06 美元,比 Fable 5 (High) 高 0.6 个百分点、成本低 54%
  • 限制:训练数据截至 9 月 17 日,未覆盖 Opus 5.5;目前只能在 Agent Mode 试用,API 需申请
阅读全文

Artificial Analysis:Gemini 3.8 Live Extended Thinking 登顶 Speech to Speech Index,得分 82.6

Artificial Analysis(@ArtificialAnlys)更新 Speech to Speech Index:Google Gemini 3.8 Live Extended Thinking(High)以 82.6 分登顶,领先 GPT-Live-1(Astra medium)81.5、Grok Voice Think Fast 2.0 High 81.3;标准版 Gemini 3.8 Live 以 76.0 排第 5。同批还覆盖 Speech Agent Arena、Tau Voice(Extended Thinking 68.6% 登顶)、Big Bench Audio、首音延迟与每小时输入音频成本(标准版 $0.84,Extended Thinking $3.50)。

核心要点速览

  • Gemini 3.8 Live Extended Thinking(High)Speech to Speech Index 82.6 登顶,超 GPT-Live-1 Astra 81.5。
  • Tau Voice 智能体榜:Extended Thinking 68.6% 第一;标准版仅 30.1%。
  • 标准版输入音频约 $0.84/小时(指数最便宜);Extended Thinking 约 $3.50/小时,仍低于 Astra $5.83。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Google Gemini 3.8 Live⚡ GPT Live 1⚡ GPT-6 Astra🌐 Google DeepMind

Agent Arena Image-to-WebDev:GPT-6 Astra (Max) 登顶 1733 分,Claude Fable 5.1 居次

Arena 更新 Image-to-WebDev 榜:GPT-6 Astra (Max) 以 1733 分登顶,领先 GPT-5.6 Sol (xHigh) 129 分;Claude Fable 5.1 (Max) 以 1710 分列第二。该榜评测模型从图像到网页开发的交付能力,对新近发布模型给出公开对比。

核心要点速览

  • GPT-6 Astra (Max) 以 1733 分登顶 Image-to-WebDev。
  • Claude Fable 5.1 (Max) 以 1710 分位列第二。
  • 榜单覆盖四款新近评测的模型发布。
阅读全文
AD赞助内容

Artificial Analysis:GPT-Live-1(Astra)登顶 Speech to Speech Index,得分 81.5

Artificial Analysis(@ArtificialAnlys)公布 Speech to Speech Index:OpenAI GPT-Live-1 在委托后端为 Astra(medium)时以 81.5 分登顶,Sol(low)为 80.1 排第 3,夹在中间的是 Grok Voice Think Fast 2.0 High(81.3)。GPT-Live-1 为全双工语音模型,可在对话中把推理与工具调用委托给后端文本模型;同批评测还覆盖 Speech Agent Arena、Tau Voice、Big Bench Audio 与成本/首音延迟。

核心要点速览

  • GPT-Live-1(Astra medium)Speech to Speech Index 81.5 登顶;Sol low 80.1 排第 3。
  • Tau Voice 智能体榜:Astra medium 67.9%、Sol low 59.3%,分列前两名。
  • 成本约 $5.83/$4.47 每小时输入音频(含后端);首音延迟约 1.34s/1.24s,慢于 Grok Voice 0.70s。
阅读全文
关联模型 / 智能体 / 厂商:

Agent Arena:DeepSeek-V4.1-Flash (Max) 以约 $0.07/任务重塑开源成本帕累托前沿

Arena.ai(@arena)公布 Agent Arena 数据:DeepSeek-V4.1-Flash (Max) 净提升约 +4.87%,中位任务成本约 $0.07,在开源 Top-3 中成本最低;相对 Hy4 preview 保留约 98% 净提升且成本低约 73%,相对 Kimi K3 (Max) 保留约 76% 表现且成本低约 92%。

核心要点速览

  • DeepSeek-V4.1-Flash (Max) 进入 Agent Arena,约 +4.87% 净提升。
  • 中位任务成本约 $0.07,开源 Top-3 中最便宜。
  • 相对 Hy4 / Kimi K3 在成本上大幅占优,重塑帕累托前沿。
阅读全文
关联模型 / 智能体 / 厂商:

LMArena:Muse Spark 1.3 Max 升至 Agent Arena 第 13,净提升 +4.2%,编码榜升至第 15

LMArena 公布 Muse Spark 1.3(Max)在 Agent Arena 升至第 13 名,基于逾 8700 次真实智能体会话净提升 +4.2%;相对 1.2(xHigh)的第 30 名上升 17 位。编码、工作与聊天分榜均改善,其中 Code 升至第 15(+4.3%)。

核心要点速览

  • Agent Arena 第 13,净提升 +4.2%(8.7K+ 真实会话)。
  • 较 Muse Spark 1.2 xHigh 的第 30 名上升 17 位。
  • Code 升至第 15(+4.3%),Work / Chat 同步改善。
阅读全文
关联模型 / 智能体 / 厂商:

LMArena:Claude Fable 5.1 (Max) 登顶 Agent Arena,净提升 +15.8%,中位成本 $4.14/任务

Arena.ai 官方公布:Anthropic Claude Fable 5.1 (Max) 在 Agent Arena 基于 6.7k+ 真实长程智能体会话登顶,净提升 +15.8%,同时以中位 $4.14/任务改写价格-性能帕累托前沿。赞美 vs 投诉隐式情绪领先 +42.5%,确认成功 +22.4%,Bash 恢复 +13.1%,且无工具幻觉;GPT-6 Astra 轨迹仍在收集中。

核心要点速览

  • Claude Fable 5.1 (Max) 在 Agent Arena 登顶,6.7k+ 真实智能体会话净提升 +15.8%。
  • 中位成本 $4.14/任务,同时为当前榜单最强也最贵模型,改写帕累托前沿。
  • 赞美 vs 投诉 +42.5%、确认成功 +22.4%、Bash 恢复 +13.1%,无工具幻觉;Astra 对比轨迹仍在收集。
阅读全文

LMArena:Meta Muse Spark 1.3 进入 Agent/Code Arena,开放投票、分数即将公布

Arena.ai(@arena)宣布 Meta Muse Spark 1.3 已进入 Arena:Agent Arena 用海量真实长程智能体任务评测(可调用网页搜索、文件系统与终端),并以因果追踪相对平均模型衡量结果;同时覆盖 Code Arena 的 WebDev、Text、Vision 与 Document,现可投票,分数即将发布。

核心要点速览

  • Muse Spark 1.3 已登陆 Agent Arena 与 Code Arena(含 WebDev)。
  • Agent Arena 评测真实长程工具调用工作流,分数即将公布。
  • 现可提交难题提示并投票,便于与前沿模型横比。
阅读全文

LMArena:Gemini 3.8 Flash 首次登上 Agent Arena 帕累托前沿,单任务中位成本仅 $0.22

Arena.ai(@arena)指出 Google DeepMind 的 Gemini 3.8 Flash (High) 首次把 Gemini 推上 Agent Arena 帕累托前沿:API 价 $0.75/$3.75 每百万 token,Agent Arena 中位成本约 $0.22/任务且净提升 +5.94%,表现接近 Grok 4.5 与 GLM 5.2 (Max),但单价低约 44–50%。

核心要点速览

  • Gemini 3.8 Flash (High) 首次登上 Agent Arena 帕累托前沿。
  • API 定价 $0.75/$3.75 per MTok;Agent Arena 中位约 $0.22/任务,净提升 +5.94%。
  • 相对 Grok 4.5($0.39/任务)与 GLM 5.2 Max($0.44/任务)约便宜 44–50%。
阅读全文
AD赞助内容

Cursor 上线 Gemini 3.8 Flash:编辑器内可直接调用谷歌新工作马模型

Cursor 官方账号(@cursor_ai)宣布 Gemini 3.8 Flash 已在 Cursor 中可用。结合 Google DeepMind 同日发布的智能体与网络安全强化叙事,以及 LMArena Agent Arena 上的明显跃升,开发者可在熟悉的 AI 编程 IDE 里直接使用这款更快更强的 Flash 档模型。

核心要点速览

  • 官方确认:Gemini 3.8 Flash 已在 Cursor 内可用。
  • 把谷歌最新 Flash 工作马模型直接送进主流 AI IDE,降低切换成本。
  • 与 Agent Arena 提升叙事叠加,适合日常编码、工具调用与长程任务。
阅读全文

LMArena:Gemini 3.8 Flash (High) Agent Arena 净提升 +5.94%,总榜升至第 14

LMArena(@arena)详解 Gemini 3.8 Flash (High) 相对 3.7 Flash (High) 在 Agent Arena 的跃升:净提升从 +0.84%(总榜 #32)升至 +5.94%(总榜 #14)。Agent Arena 用网页/文件系统/终端等真实长程任务衡量相对平均模型的净改进;五维信号里 Praise vs Complaint 改善最猛(+14.78% vs -1.60%),Confirmed Success 与 Bash Recovery 也明显变好,Steerability 仍弱但已好转。

核心要点速览

  • Agent Arena 净提升 +5.94%、总榜 #14,相对 3.7 的 +0.84%/#32 大幅跃升。
  • Praise vs Complaint +14.78%(前代 -1.60%),用户正向反馈显著增多;Bash Recovery 与 Confirmed Success 同步改善。
  • Steerability 仍为短板(-1.43%),但已好于 3.7;Tool Hallucination 两边均无显著问题。
阅读全文

LMArena:Gemini 3.8 Flash 登陆 Agent/Text/Code Arena,Agent 榜第 14、Text 第 7

LMArena(@arena)宣布 Gemini 3.8 Flash(High)已进入 Agent Arena、Text Arena 与 Code Arena WebDev。Agent Arena 排名第 14(净提升 +5.94%),远高于 3.7 Flash 的第 32;Text Arena 第 7(1494 分),Coding 类别从第 22 升至第 7;Code Arena WebDev 第 18(1567 分)。

核心要点速览

  • 同步进入 Agent、Text、Code WebDev 三大 Arena,面向真实工具调用与编程评测。
  • Agent Arena 第 14(+5.94%),较 3.7 Flash 第 32 大幅跃升。
  • Text Arena 第 7;Coding 类别 #22→#7;WebDev 第 18,助力 DeepMind 实验室榜保持前列。
阅读全文

LMArena:Claude Fable 5.1 已进入 Arena,Agent Arena 将评测长程工具调用智能体

LMArena(@arena)宣布 Anthropic Claude Fable 5.1 已可在 Arena 投票评测,分数即将公布。Agent Arena 面向真实长程智能体任务,模型可使用网页搜索、文件系统与终端等工具;Fable 5.1 同时进入 Code Arena 的 WebDev、Text、Vision 与 Document 赛道。

核心要点速览

  • Fable 5.1 已进入 LMArena 公开投票,官方分数尚未放出。
  • Agent Arena 强调长程、可调用搜索/文件/终端的真实智能体工作流。
  • 同步覆盖 Code Arena WebDev、Text、Vision、Document 多赛道。
阅读全文