AI 编程实时动态与要闻

蚂蚁灵波开源触觉基础模型 LingBot-Touch:近 5000 小时真实触觉数据预训练,冻结的 546 万参数编码器让 4 种机器人策略在 26 项真机任务上成功率提升 14–26 个百分点

蚂蚁集团旗下具身智能公司灵波科技(Robbyant)11 月 9 日开源触觉基础模型 LingBot-Touch(Apache 2.0),用 JEPA 式潜空间预测和共享 Haptic Transformer,把压阻、磁感、视触觉三类传感器统一成同一套触觉 token。官方技术报告称:在 26 项双臂灵巧手真机任务上,接入冻结的 546 万参数 Tiny 编码器后,Diffusion Policy、π0.5、LingBot-VLA、T-Rex 的平均成功率分别提升 13.9–24.8 个百分点,而直接喂原始触觉信号最多只有约一半收益。Tiny 与 Small 两个权重已上 Hugging Face。

蚂蚁灵波开源触觉基础模型 LingBot-Touch:近 5000 小时真实触觉数据预训练,冻结的 546 万参数编码器让 4 种机器人策略在 26 项真机任务上成功率提升 14–26 个百分点

核心要点速览

  • 预训练语料 4,983 小时、46.4 万段交互、约 13.3 亿帧,来自触觉手套与遥操作机器人手,覆盖压阻、磁感、视触觉三种原理
  • 官方口径:26 项真机任务平均成功率,LingBot-VLA 48.3%→73.1%、π0.5 48.1%→69.9%、T-Rex 45.4%→68.6%、Diffusion Policy 21.6%→35.6%
  • Tiny 编码器仅 546 万参数,给所增强的策略增加不到 0.2% 参数;Small 为 2176 万参数,两者均为 12 层 Transformer
  • 仿真 12 项灵巧手强化学习任务中成功率 69%,对比任务专用 CNN 特征 46%、无触觉 21%
  • 注意:可迁移到预训练时没见过的传感器型号,但新的传感器排布仍需先做几何标定
阅读全文
关联模型 / 智能体 / 厂商:
⚡ LingBot-Touch⚡ LingBot-VLA⚡ pi0.5🌐 Ant Group🌐 Robbyant

蚂蚁百灵发布 Ling-3.2-flash:560B/25B 原生多模态 MoE、1M 上下文,厂商评测多项超 Opus 5,上线前两周免费

蚂蚁集团 Ant Ling(@AntLingAGI)于 11 月 5 日发布 Ling-3.2-flash:560B 总参 / 25B 激活的原生多模态 MoE,1M 上下文,原生支持图/文/视频。官方 changelog 写明聚焦复杂视觉理解、多模态长程 Agent、3D 理解与交互、医学多模态;兼容 OpenAI 与 Anthropic 协议,上线前 2 周免费。官方帖给出相对 Claude Opus 5(max)的厂商评测:OmniDocBench1.5 92.21 vs 90.56、ZEROBench(Sub) 43.71 vs 39.52、Vision2Web 85.86 vs 80.20。DesignArena 称 Image-to-Frontend 约第 10、Elo 1238。

蚂蚁百灵发布 Ling-3.2-flash:560B/25B 原生多模态 MoE、1M 上下文,厂商评测多项超 Opus 5,上线前两周免费

核心要点速览

  • 规格(官方文档):560B 总参 / 25B 激活;1M 上下文;原生图文视频;四能力:复杂视觉、多模态长程 Agent、3D、医学多模态
  • 供应:对话页可体验;API 兼容 OpenAI / Anthropic;changelog 写明上线前 2 周免费,促销结束后恢复原价
  • 厂商评测(官方 X):OmniDocBench1.5 92.21 vs Opus 5 90.56;ZEROBench(Sub) 43.71 vs 39.52;Vision2Web 85.86 vs 80.20
  • 第三方:DesignArena Image-to-Frontend 约 #10、Elo 1238;官方价目页强调 2 周免费,暂未单列 3.2 USD 价
  • 落地:模型 ID Ling-3.2-flash;图像用 image_url、视频用 video_url;权重未上 Hugging Face(API-first)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Ling-3.2-flash⚡ Ling-3.1-flash⚡ Claude Opus 5🌐 Ant Ling🌐 Ant Group

vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

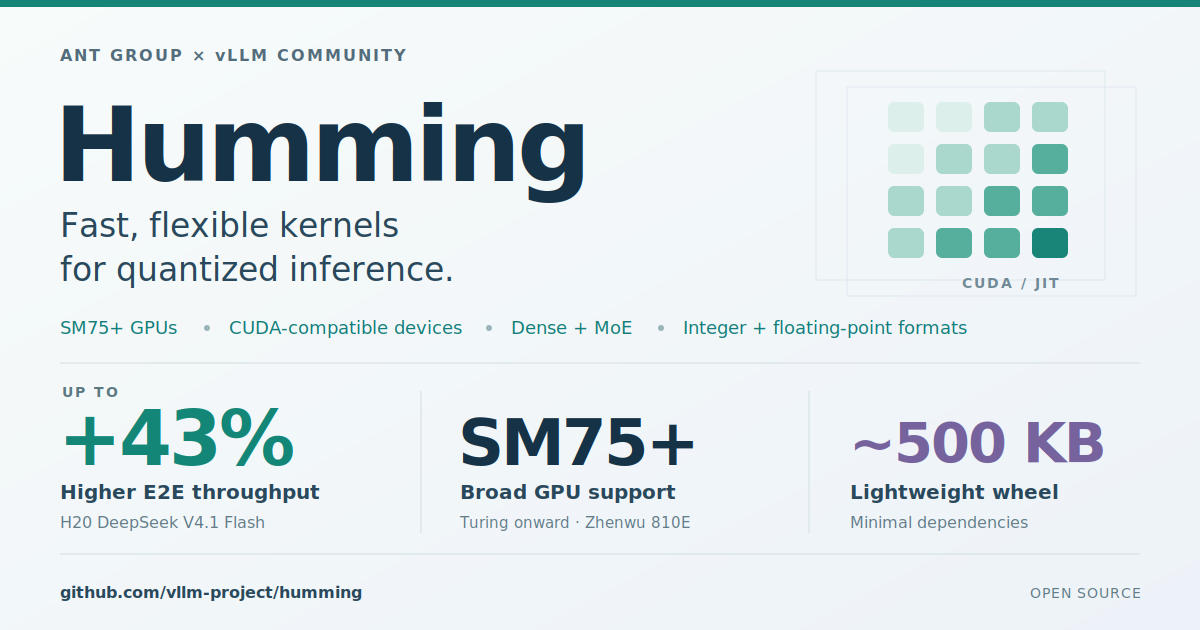
vLLM 官方联合蚂蚁集团正式开源底层高性能量化推理算子库 Humming(humming-kernels)。该算子库专为大规模混合专家(MoE)与低精度密集模型的高并发服务而设计,全面覆盖 WnA16、W8A8、W4A8 与 W4A4 多种量化精度,横跨 INT1~INT8 与 FP4~FP8 数据格式,并原生适配从 NVIDIA Turing 到 Blackwell 架构及平头哥真武 810E 芯片。实测显示,Humming 算子在小 Batch 下比 cuBLAS 快 3~4 倍,在大 Batch 下比 Marlin 快 2 倍;在 8 张 H20 GPU 上运行 DeepSeek-V4.1-Flash,64 并发下整机端到端吞吐暴增 43.3%,首字时延(TTFT)大幅降低 32%,现已作为默认引擎整合至 vLLM v0.29.0+ 中。

vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

核心要点速览

  • vLLM 与蚂蚁集团联合开源 Humming 高性能算子库(Apache 2.0),现已原生内置于 vLLM 0.29.0+ 核心代码中
  • 全方位打通 WnA16、W8A8、W4A8 与 W4A4 低比特精度,算子即时编译耗时仅需 1.82 秒(相比 CUTLASS 的 23.35 秒提速 12 倍)
  • 在 8 卡 H20 集群部署 DeepSeek-V4.1-Flash 实测:64 并发下吞吐从 442 提升至 634 tokens/s(净增 +43.3%)
  • 首字生成时延(TTFT)缩减 25%~32%,在下一代 B300 架构上 MoE 核心算子实现最高 5 倍极限加速
阅读全文

vLLM 与蚂蚁集团开源量化推理内核库 Humming:一套内核覆盖多种量化格式和 Turing 以来全部 NVIDIA GPU,DeepSeek-V4.1-Flash 端到端吞吐提升 14%–43%

10 月 21 日,vLLM 社区与蚂蚁集团开源 Humming(Apache 2.0),一个用 JIT 编译按需生成 GEMM 内核的量化推理库,支持 Turing 起所有 NVIDIA 架构及平头哥真武 810E,覆盖 INT1–INT8、FP4–FP8 等权重/激活组合和稠密、MoE 两类负载。官方微基准中部分场景比 vLLM Marlin、FlashInfer、DeepGEMM 快 2–5 倍;在 8 张 H20 上跑 DeepSeek-V4.1-Flash,MoE 从 Marlin W4A16 换成 Humming W4A8 后吞吐提升 14%–43%。vLLM 0.29.0 起已内置。

vLLM 与蚂蚁集团开源量化推理内核库 Humming:一套内核覆盖多种量化格式和 Turing 以来全部 NVIDIA GPU,DeepSeek-V4.1-Flash 端到端吞吐提升 14%–43%

核心要点速览

  • 一套 JIT 内核框架替代按格式各写一个内核:支持 WNA16、W8A8、W4A8、W4A4,INT1–INT8 与 FP4–FP8 权重,稠密与 MoE
  • 硬件:Turing(SM75)起全部 NVIDIA GPU,含 Blackwell SM100/103/120/121,以及平头哥真武 810E
  • 端到端:8×H20、TP=8 跑 DeepSeek-V4.1-Flash,Humming W4A8 比 Marlin W4A16 吞吐高 14%–43%,平均 TTFT 降 25%–32%;并发 64 时输出 442→634 tok/s
  • 微基准(vLLM 社区测):H200 W4A8-MXFP4 约为 DeepGEMM W8A8 的 4.5 倍,B300 MoE Grouped 路径约为 Marlin 的 5 倍;单个 W4A16 内核编译 1.82 秒,CUTLASS 为 23.35 秒
  • 使用:pip install humming-kernels(wheel 约 500 KB);vLLM 0.29.0 起内置,用 --linear-backend humming --moe-backend humming 启用
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

蚂蚁集团开源语音大模型 Ming-3.0-tts:发音准确率 93.2% 登顶全球开源榜,MIT 协议商用友好

在 Artificial Analysis 最新发布的全球文本转语音(TTS)独立基准评测中,蚂蚁集团(Ant Group)开源的 Ming-3.0-tts 斩获 93.2% 的发音准确率,在全部 31 款参评模型中位列第一(超越 ElevenLabs v4 的 91.7%)。该模型提供 0.5B 密集版与 7.9B MoE 架构版本,支持高质量声音克隆与预设音色,在受控声音评测榜以 1,069 Elo 分位居开源第一,且以极度宽松的 MIT 开源协议完全向开发者免费开放。

蚂蚁集团开源语音大模型 Ming-3.0-tts:发音准确率 93.2% 登顶全球开源榜,MIT 协议商用友好

核心要点速览

  • 蚂蚁集团开源新一代语音大模型 Ming-3.0-tts,在 Artificial Analysis 独立测评中斩获 93.2% 发音准确率登顶全球开源第一
  • 发音表现超越 ElevenLabs v4(91.7%),在受控声音竞技场以 1,069 Elo 分位居开源模型榜首
  • 提供面向低延迟端侧的 0.5B 稠密版与极致拟真的 7.9B MoE 旗舰版,支持 3 秒极速零样本声音克隆
  • 采用无限制 MIT 开源协议完全免费商用,权重与代码已全面上线 Hugging Face
阅读全文
关联模型 / 智能体 / 厂商:

蚂蚁集团等开源 Mara Chain:重新审视‘失败’的价值!智能体系统跨越局部最优实现自主进化

当前的 AI 智能体系统与代码框架在自主进化和自优化(如提示词搜索、工作流生成、脚手架重构)中普遍遵循贪婪策略——一旦某个候选变异在测试基准上出现性能回退,就会被算法立即抛弃。然而复杂系统的搜索空间高度崎岖,绝大多数通往全局最优的质变突破在早期往往表现为临时的负向或劣质状态。蚂蚁集团(Ant Group Research)、北京大学与北京智源人工智能研究院联合提出了 Mara Chain(arXiv:2609.35855)自主进化新范式。Mara Chain 打破了传统贪婪拒绝机制,将未通过评估但包含结构创新或局部潜力的‘失败变体’转化为拓扑进化的阶梯(Stepping Stones)。框架由三大核心引擎驱动:其一,语义与功能去重驱动的进化缓存(Stepping-Stone Buffer);其二,基于失败根因逆向回溯的分层变异器(Hierarchical Mutator);其三,多目标非支配 Pareto 排序淘汰机制。在 AppWorld 基准上,Mara Chain 在减少 65.5% 采样轮数的前提下,相比 GEPA、ACE 和 SkillOpt-Lite 取得了最高 20.5% 的性能跃升;在真实的 TerminalBench 2.1 运维环境中,Mara Chain 更是相比 AHE 和 Meta-Harness 分别大涨 20.2 和 22.5 个百分点,并将官方代码与框架 AntOmniEvo 全面开源。

核心要点速览

  • 蚂蚁集团与北大、智源联合提出 Mara Chain,打破贪婪优化桎梏,将‘失败候选’转化为系统自演化的拓扑阶梯
  • 在 AppWorld 基准上超越 GEPA 与 ACE 高达 20.5% 且减少 65.5% 采样轮数;TerminalBench 2.1 解决率相比 AHE 大涨 20.2 个百分点
  • 全面开源 AntOmniEvo 框架,提供 AST 拓扑去重缓存与分层逆向归因变异器,助力 Coding Agent 自主重构
阅读全文

蚂蚁百灵 Ling-3.1-flash:560B/25B 激活 MoE;厂商报 SWE-Pro 65.39、CyberGym 87.9;Vercel/OpenCode 免费到 10/13

蚂蚁集团 InclusionAI 于 2026-09-30 公布 Ling-3.1-flash:约 560B 总参、每 token 激活约 25B 的混合推理 MoE,设计上下文最高 1M(试用/网关当前多暴露 256K–262K)。权重尚未上 Hugging Face;Vercel AI Gateway 与 OpenCode Zen 提供限时免费(至约 2026-10-13)。厂商自报含 SWE-Pro 65.39、Terminal-Bench 4.0 40.40、CyberGym 87.90——均未独立复现。

蚂蚁百灵 Ling-3.1-flash:560B/25B 激活 MoE;厂商报 SWE-Pro 65.39、CyberGym 87.9;Vercel/OpenCode 免费到 10/13

核心要点速览

  • 规模:约 560B 总参 / 25B 激活(对比 Ling-3.0-flash 的 124B/5.1B);设计最高 1M 上下文,试用期/网关当前常见 256K–262K
  • 架构(官方摘要):提高线性 Attention 比例——7 层 KDA : 1 层 Gated MLA;512 路由专家选 8 + 1 共享专家
  • 厂商基准(未独立复现):SWE-Pro 65.39、Terminal-Bench 4.0 40.40、CyberGym 87.90、BrowseComp 91.67;对标表含 DeepSeek-V4.1-Flash / GLM 5.3 flash 等
  • 可用性:Vercel AI Gateway inclusionai/ling-3.1-flash / -free(Novita),免费到约 10/13;OpenCode Zen ling-3.1-flash-free
  • 风险:权重未开源;免费通道可能用于改进模型(勿喂专有代码);HealthBench 等分数带「AQ 环境」脚注
阅读全文

低比特量化新标杆!PrismQuant 开源:零阶闭式零空间旋转对齐 INT4 分组,70B 模型精度损耗仅 0.22% 且显存立省 56%

在千亿参数大模型与端侧推理场景中,低比特权重量化与 KV Cache 压缩(如 W4A4KV4)是降低显存门槛与大幅提升吞吐的核心命脉。然而学术界长期存在一个认知误区:盲目追求削减激活值中的离群异常值(Outliers),而忽视了异常值与量化器本身的几何对齐关系。高通与苏黎世联邦理工学院等机构联合团队推出突破性量化框架 PrismQuant:首次揭示离群点绝对数值较小并不意味着低比特误差小,真正决定量化保真度的是异常值主特征空间与非对称分组量化器(Grouped INT4)常数子空间的最优几何对齐。团队将旋转矩阵设计巧妙构建为 Ky Fan 迹最大化问题,推导出了严格最优的闭式数学解析解。在 Llama、Qwen 与 Mistral 等涵盖 70B 密集模型与 30B MoE 模型的广泛评测中,W4A4KV4 配置下的 PrismQuant 刷新了业界 SOTA:在 Llama-3.1-70B 上零样本准确率仅比未量化的 FP16 全精度低 0.22 个百分点;在 8B 部署实测中实现 1.51 倍 Prefill 加速、解码显存峰值狂降 56.34%,代码已全面开源。

低比特量化新标杆!PrismQuant 开源:零阶闭式零空间旋转对齐 INT4 分组,70B 模型精度损耗仅 0.22% 且显存立省 56%

核心要点速览

  • 颠覆离群值抑制固有直觉:首次证明激活离群值幅度小不等于量化误差低,关键在于异常值能量空间与 INT4 分组量化器几何子空间的最优对齐。
  • 闭式最优解与无梯度构建:基于 Ky Fan 迹最大化与紧凑 Householder 变换,实现完全免梯度微调的秒级闭式解析旋转构建,极大简化部署流程。
  • 70B 仅降 0.22% 且显存立减 56%:在 Llama-3.1-70B 上 W4A4KV4 量化准确率达 72.46%(仅较 FP16 损耗 0.22%),8B 模型解码峰值显存缩减 56.34%,Prefill 提速 1.51 倍。
阅读全文
关联模型 / 智能体 / 厂商: