AI 编程实时动态与要闻

NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

NVIDIA 官方博客 10 月 30 日披露,Breakthrough Listen 与 SETI 研究所已把 Agent 接入北加州艾伦望远镜阵列(ATA,42 面 6 米天线)的日常地外文明搜索:研究员用一句自然语言请求,Agent 就能转动天线、校准聚焦、纠正数据错误并对实时数据流跑 AI 模型。底层由 Holoscan 的 DAQIRI 库把传感器数据直接送进 GPU 显存,SETI 研究所的 CyberEther 做信号处理,Web 编排器 Nexus 充当 Agent harness,在 RTX PRO 6000 Blackwell 上本地处理最高 2.4 Tbps。系统已完成首次蟹状星云脉冲星的实时 AI 检测;团队正在评估 Nemotron 等开放模型。@NVIDIAAI 10 月 31 日万圣节帖约 274 赞。

NVIDIA:SETI 艾伦望远镜阵列接入 AI Agent,一句自然语言即可操控天线、校准并实时分析 2.4 Tbps 射电数据

核心要点速览

  • 吞吐:在 NVIDIA RTX PRO 6000 Blackwell GPU 上最高处理 2.4 Tbps 射电数据,推理在望远镜旁本地运行(NVIDIA 博客,厂商口径)
  • 三层架构:DAQIRI 把传感器数据直送 GPU 显存,CyberEther 用 cuFFT/cuBLAS 做信号处理,Nexus 作为 Agent harness 管理仪器状态、算力和流水线
  • 能力:一句自然语言即可转动 ATA 的 42 面 6 米天线、校准聚焦、修正数据错误并出图;官方称把人类数周到数年的工作压缩到数小时
  • 里程碑:完成蟹状星云脉冲星的首次实时 AI 检测;官方未公布误报率等量化指标,也没有发现地外信号
  • 下一步:评估 Nemotron 等开放模型,用于数据本地性要求高、甚至未来可能在月球背面离线运行的天文台
阅读全文
关联模型 / 智能体 / 厂商:

Mistral 与 NVIDIA 达成工业工程 AI 战略结盟:万亿参数 Mistral Large 4 重磅前瞻曝光

欧洲前沿 AI 巨头 Mistral AI 与 NVIDIA 在 GTC Berlin 宣布达成工业工程 AI 深度战略合作,全面加速物理 AI、计算机辅助工程(CAE)与芯片设计(EDA)的智能化变革。合作将 Mistral 旗舰模型与 NVIDIA CUDA-X、Warp 物理引擎以及 Omniverse 实时数字孪生进行全链路打通。官方博客同时公布了备受瞩目的下一代旗舰模型 Mistral Large 4 的核心技术参数:总参数量接近 1 万亿(1T),激活参数为 490 亿(49B MoE),在 3800 张 Grace Blackwell GPU 集群上训练完成,模型权重定于 10 月底正式开源发布,并将联合 Nemotron 联盟共建工业基座。

Mistral 与 NVIDIA 达成工业工程 AI 战略结盟:万亿参数 Mistral Large 4 重磅前瞻曝光

核心要点速览

  • Mistral AI 与 NVIDIA 官宣战略合作,将大模型能力全面注入计算机辅助工程(CAE)、物理仿真与半导体芯片设计(EDA)
  • 深度融合 NVIDIA Warp、CUDA-X 物理加速库与 Omniverse 数字孪生平台,构建工程仿真领域的开源智能体评测与基准
  • 首次正式公开 Mistral Large 4 核心规格:约 1 万亿总参、49B 稀疏激活 MoE 架构,在 3800 张 Grace Blackwell 算力集群完成预训练
  • Mistral Large 4 官方权重定于 2026 年 10 月底全量开源发布,并宣布双方加入 Nemotron 联盟向 2030 年 1 GW 绿色算力推进
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

vLLM 官方联合蚂蚁集团正式开源底层高性能量化推理算子库 Humming(humming-kernels)。该算子库专为大规模混合专家(MoE)与低精度密集模型的高并发服务而设计,全面覆盖 WnA16、W8A8、W4A8 与 W4A4 多种量化精度,横跨 INT1~INT8 与 FP4~FP8 数据格式,并原生适配从 NVIDIA Turing 到 Blackwell 架构及平头哥真武 810E 芯片。实测显示,Humming 算子在小 Batch 下比 cuBLAS 快 3~4 倍,在大 Batch 下比 Marlin 快 2 倍;在 8 张 H20 GPU 上运行 DeepSeek-V4.1-Flash,64 并发下整机端到端吞吐暴增 43.3%,首字时延(TTFT)大幅降低 32%,现已作为默认引擎整合至 vLLM v0.29.0+ 中。

vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

核心要点速览

  • vLLM 与蚂蚁集团联合开源 Humming 高性能算子库(Apache 2.0),现已原生内置于 vLLM 0.29.0+ 核心代码中
  • 全方位打通 WnA16、W8A8、W4A8 与 W4A4 低比特精度,算子即时编译耗时仅需 1.82 秒(相比 CUTLASS 的 23.35 秒提速 12 倍)
  • 在 8 卡 H20 集群部署 DeepSeek-V4.1-Flash 实测:64 并发下吞吐从 442 提升至 634 tokens/s(净增 +43.3%)
  • 首字生成时延(TTFT)缩减 25%~32%,在下一代 B300 架构上 MoE 核心算子实现最高 5 倍极限加速
阅读全文

Blackwell 4-bit 强化学习终获稳态解!南京大学等提出 TRIAGE:NVFP4 原生训练零性能损耗,吞吐暴增 2.3 倍

在大语言模型后训练阶段引入强化学习(如 PPO、GRPO、DPO)极度消耗显存与算力,海量 Rollout 生成让推理集群不堪重负。采用极低精度(如 NVIDIA Blackwell 架构原生支持的 NVFP4 / W4A4)进行端到端强化学习是突破吞吐瓶颈的终极方向。然而,量化导致训练端(Learner)与采样端(Sampler)之间产生执行不匹配(Mismatch),极易引发策略梯度的灾难性震荡。南京大学联合团队在最新研究(arXiv:2610.07043)中打破了“只看量化误差幅度”的传统视角,首次从策略梯度方向角度揭示了失衡本质:在原生 NVFP4 训练初期,误差集中放大负优势、负差距更新,导致尾部 Token 梯度急剧恶化。针对此,团队打造了方向感知稳定算法 TRIAGE,利用片段级诊断动态重平衡策略梯度,同时保留 Sampler 与 Learner 原生的 W4A4 纯 4-bit 前向执行。在 Qwen3-4B 和 Qwen3-30B-A3B 上,TRIAGE 在数学与复杂推理基准上完全追平 BF16 全精度上限,并将 Rollout 吞吐大幅提升高达 2.3 倍。

核心要点速览

  • 南京大学与 Polixir 提出 TRIAGE 框架,首次攻克 NVIDIA Blackwell 硬件原生 NVFP4(W4A4)极低精度强化学习失稳难题
  • 首创方向感知策略梯度重平衡与片段级诊断,彻底解决 Learner-Sampler 偏差导致的尾部 Token 崩溃
  • 在 Qwen3 模型上实测性能 100% 追平 BF16 全精度基线,Rollout 生成吞吐暴增 2.3 倍,大幅节省训练算力开销
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Mistral Large 4「Le Chonk」公测:1.05T 总参 / 49B 激活原生多模态 MoE,1M 上下文,月底开放权重

Mistral 于 2026-10-06 发布 Mistral Large 4 公测 API:1.05T 总参、49B 激活的细粒度 MoE,配 1.6B 视觉编码器,1M 上下文,在欧洲自建机房 3,800 张 Grace Blackwell 上从零训练。DeepSWE v1.1 61.7%、Cybench 93%,官方称在开源模型中网络安全、金融、法律达到 SOTA;权重承诺本月底开放。

Mistral Large 4「Le Chonk」公测:1.05T 总参 / 49B 激活原生多模态 MoE,1M 上下文,月底开放权重

核心要点速览

  • 规模:1.05T 总参 / 49B 激活 MoE + 1.6B 视觉编码器,1M 上下文(模型文档)
  • 编码(Artificial Analysis 私测):DeepSWE v1.1 61.7%、SWE-Atlas-QnA 59.4%、Terminal-Bench 4 28.3%,Coding Agent Index 49.8%,高于 DeepSeek V4 Pro 0813 与 Qwen3.8 Max
  • 安全:Cybench 93%;AA Cyber Index 漏洞复现+修补子项 82% 为全场最高;Lakera B3 抗攻击 93.3%
  • Agent / 知识工作:AutomationBench 59.9%,AA-Briefcase 1,393 Elo;Surge AI 盲评 3.74 分,仅次于 Claude Opus 5(4.22)
  • 价格:每百万 token 输入 $1.36 / 缓存 $0.14 / 输出 $4.18,文档另列半价一档;权重月底发布
阅读全文
关联模型 / 智能体 / 厂商:

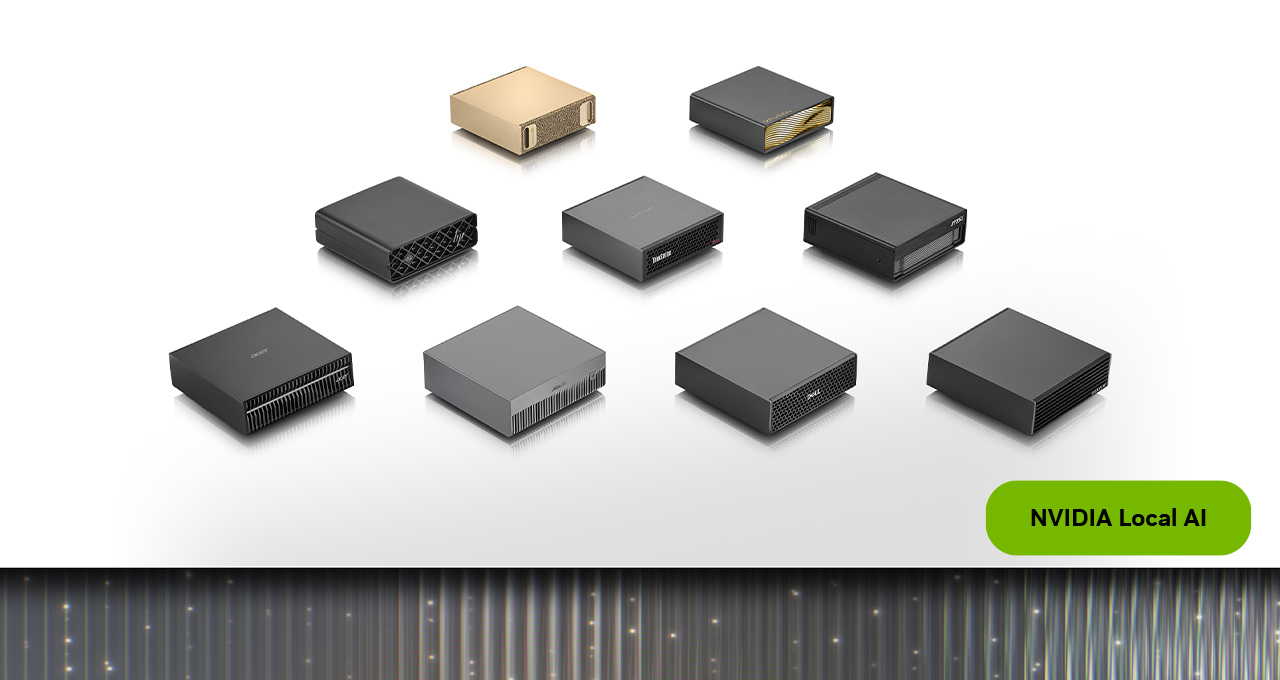
NVIDIA 推出 DGX Spark 64GB:10/23 起 OEM 开卖起价 $4,999;双机集群最高约 1.7×,本地跑至约 100B

NVIDIA 于 2026-10-02 在博客宣布 DGX Spark 64GB:10 月 23 日(周五) 起经 Acer / ASUS / Dell / Gigabyte / HP / MSI 发售,起价 $4,999。同款 GB10 Grace Blackwell、DGX OS 与完整 CUDA AI 栈;单机统一内存 64GB、官方称可本地支撑约 100B 参数模型与 Agent。两台经 ConnectX-7 + QSFP 集群可池化 128GB(约 200B);Qwen 3.8 27B 测试中双 64GB 相对单机最高约 1.7×。

NVIDIA 推出 DGX Spark 64GB:10/23 起 OEM 开卖起价 $4,999;双机集群最高约 1.7×,本地跑至约 100B

核心要点速览

  • 官宣:NVIDIA Blog — DGX Spark 64GB(Allen Bourgoyne,2026-10-02)
  • 渠道与价格:2026-10-23 起 OEM(Acer/ASUS/Dell/Gigabyte/HP/MSI);博客写明 starting at $4,999;64GB 仅经参与 OEM
  • 算力栈:保留 GB10 + DGX OS + CUDA AI;开箱支持 Agent Toolkit、Ollama、vLLM、PyTorch、Nemotron 等
  • 扩展:内置 ConnectX-7;双机 QSFP 直连池化 128GB / 约 200B 参数;Qwen 3.8 27B 实测双机相对单机最高约 1.7×
  • 月底预告:NVIDIA Sync Model Launcher 可一键拉起 Qwen3.8 27B,并配置 OpenCode 走本地模型
阅读全文

NVIDIA RTX Spark:本地 Agent 加速——RTX 5090 上 llama.cpp 最高 1.9×,Blackwell vLLM 1.2×

NVIDIA RTX Spark 公布本地 Agent 推理优化:GeForce RTX 5090 上 llama.cpp 吞吐最高提升约 1.9 倍;RTX PRO 6000 Blackwell 上 vLLM 约 1.2 倍;双机 DGX Spark 集群最高约 1.4 倍。面向本地部署与边缘 Agent 服务路径的持续加速。

核心要点速览

  • llama.cpp:RTX 5090 吞吐最高约 1.9×,本地 Agent 推理更轻。
  • vLLM:RTX PRO 6000 Blackwell 约 1.2×;双机 DGX Spark 集群最高约 1.4×。
  • 定位:强化本地 / 边缘 Agent 服务栈,而非仅云端推理。
阅读全文
关联模型 / 智能体 / 厂商:

DeepInfra 在 NVIDIA Blackwell 上线 GLM-5.3:支持零数据保留(ZDR)与公开缓存计价

低时延云推理服务商 DeepInfra 宣布在发布当日上线 GLM-5.3。部署在美国本土 NVIDIA Blackwell GPU 集群上,全面支持企业级零数据保留(ZDR)合规,并以每百万 Token $1.40 输入 / $4.40 输出 / $0.26 缓存的透明价格开放。

核心要点速览

  • 前沿硬件加持:依托 Blackwell 架构实现超高推理并发吞吐与极致的 首 Token 响应时延(TTFT);
  • 大幅优化 Agent 缓存成本:提供每百万仅 $0.26 的提示词缓存价格,极大降低频繁重读上下文的开销;
  • 严格合规保障:支持 ZDR 零数据保留,满足金融与企业级代码隐私安全要求。
阅读全文
关联模型 / 智能体 / 厂商:

SGLang 推出 GLM-5.3 Day-0 推理支持:NVFP4 达 537.6 tok/s,全面覆盖 Blackwell 与 AMD

高性能大模型推理框架 SGLang 宣布对开源权重 GLM-5.3 实现 Day-0 生产级适配。在真实多轮 Agent 复杂负载下,8×B300 上 NVFP4 吞吐达到 537.6 tok/s/user,并同步支持 AMD MI300X/355X 硬件加速。

核心要点速览

  • 首发适配开源 320B-A18B 混合注意力架构,实现权重发布当日即可高并发部署上线;
  • 基于 NVFP4 与 FP8 量化内核深度优化,在真实 Agent 编程会话中保持超 500 Token/s 用户吞吐;
  • 同一套开源代码库全面打通 NVIDIA Blackwell/Hopper 与 AMD MI300X/325X/355X,避免硬件锁定。
阅读全文
关联模型 / 智能体 / 厂商: