AI 编程实时动态与要闻

Hao AI Lab 开源 FastH3 Omni:把 MiniMax H3 蒸馏到 8 步,多参考音视频生成端到端延迟降低 5.6–11.9 倍

10 月 20 日,UCSD Hao AI Lab 的 FastVideo 团队开源 FastH3 Omni,这是 MiniMax H3 参考生成音视频(Ref2VA)模型的蒸馏版,可同时用文本、最多 9 张图、视频片段和人声参考生成带同步立体声的视频。采样从 50 步降到 8 次 transformer 计算,官方在 8 张 GB200 上测得端到端延迟降低 5.6–11.9 倍,训练代码一并开源,并提供面向 DGX Spark、RTX 5090 的 NVFP4 权重和 ComfyUI 支持。

Hao AI Lab 开源 FastH3 Omni:把 MiniMax H3 蒸馏到 8 步,多参考音视频生成端到端延迟降低 5.6–11.9 倍

核心要点速览

  • 步数:8 次 transformer 计算,基座 MiniMax H3 为 50 步,采用 PDD + DMD 蒸馏
  • 速度(官方口径):27 组对照负载、8×GB200,端到端延迟降低 5.6–11.9 倍;例如 15 秒单图请求 139.69 秒降到 14.14 秒
  • 输入:最多 9 张图、3 段视频、3 段音频,合计不超过 12 个参考;输出 24 FPS 视频 + 32kHz 立体声
  • 本地运行:DGX Spark(128GB)和 RTX 5090(32GB)用 NVFP4 QAD 权重,默认 480p;RTX 4090 可用 FP8 版
  • 许可:沿用 MiniMax-H3 Community License,不是 Apache/MIT
阅读全文
关联模型 / 智能体 / 厂商:

NVIDIA 开源 Nemotron 3.5 Super VL:120B-A12B 多模态智能体模型、1M 上下文;同步放出 2-bit 24GB 本地版 Bolt 74B-A9B

NVIDIA 于 2026-10-15 发布开源多模态智能体模型 Nemotron 3.5 Super VL:120B 总参、每 token 激活 12B,Mamba-2/Transformer 混合 MoE + C-RADIO 视觉编码器,支持文本、图像、文档与视频输入,最长 1M 上下文,自带 MTP 与 LiLiCorr 投机解码。权重、数据集与训练配方以 OpenMDW-1.1 开放,已上 Hugging Face、OpenRouter、ModelScope 与 NIM。同日放出面向 RTX/DGX Spark 的 Bolt 74B-A9B 24GB(原生 2-bit 量化感知训练),4GB 的 Bolt E4B 将于 10 月 23 日跟进。

NVIDIA 开源 Nemotron 3.5 Super VL:120B-A12B 多模态智能体模型、1M 上下文;同步放出 2-bit 24GB 本地版 Bolt 74B-A9B

核心要点速览

  • 规模:Super VL 120B 总参 / 12B 激活,最长 1M 上下文;BF16 参考部署需 4×H100 或 2×GB200,另有 NVFP4 版(模型卡)
  • 编码与终端(官方口径):SWE-bench Verified 71.10、Terminal-Bench 2.1 66.70、LiveCodeBench v6 88.22;同表 Qwen3.5-122B-A10B 分别为 71.9 / 48.70 / 76.7,GLM-5.3-Flash 为 79.10 / 82.70 / 80.6
  • 智能体评测:Hermes Bench 63.44%(Nemotron 3 Ultra 56.33%),LangChain Evals 87.05%(Ultra 84.3%);NVIDIA 称单卡吞吐最高达同级开源模型 5 倍、Baseten 端点 600+ TPS(技术博客)
  • 本地版 Bolt 74B-A9B 24GB:原生 2-bit(IQ2+QAT)、256K 上下文,Terminal-Bench 2.1 50.98、BrowseComp 66.75,对照 Qwen3.6-35B-A3B 为 44.38 / 48.74;PinchBench 87.82 略低于 Qwen3.6 的 88.07(Bolt 模型卡)
  • 推理工程:LiLiCorr 投机解码在 DGX Spark 上最高提速 2.3 倍;Dynamo 方案在 16×B200、50 tok/s/用户下服务人数提升 8 倍、首 token 延迟降 85%
阅读全文
关联模型 / 智能体 / 厂商:
⚡ nemotron-3.5-super-vl⚡ nemotron-3.5-bolt-74b-a9b⚡ nemotron-3.5-bolt-e4b⚡ Nemotron 3 Ultra🤖 hermes-agent🤖 opencode🤖 OpenHands (All-Hands AI)🤖 Cline (VS Code Agent)🌐 Nvidia (NIM)
g
ggml-org@AICoder·
👀194
🔥84

llama.cpp v0.6.0 稳定版发布:正式纳入 GLM-5.3-Flash(320B)与 Qwen4Exp MTP 投机解码,新 llama_batch_ext API,Apple GPU 小批量矩阵乘最高约 3 倍

ggml-org 于 10 月 5 日发布 llama.cpp v0.6.0 稳定版(上一版 v0.5.0 为 9 月 23 日)。本版把 GLM-5.3-Flash(GLM5-Next,320B 图文混合 MoE)支持带进正式版,Qwen4Exp 加入 MTP 投机解码(DGX Spark 上解码约 1.5 倍),引入支持 token/embedding 混合批次的 llama_batch_ext 与 llama_process() 新 API,并为 Apple GPU 新增小批量 MMA 矩阵乘内核(投机/批量解码场景最高约 3 倍),ggml 升级到 v0.26.0。会话格式版本号同时升级,旧会话文件需注意兼容。

核心要点速览

  • 新模型:GLM-5.3-Flash(GLM5-Next,320B KDA/DSA 混合图文 MoE,#27773)、Clef 图文决策模型、Ling 3.0 VL、LFM2.5-Encoder
  • 提速:Qwen4Exp MTP 投机解码在 DGX Spark 上解码约 1.5 倍;Metal 小批量 MMA 矩阵乘最高约 3 倍(#29869)
  • API:新增 llama_batch_ext + llama_process(),单批次混合 token 与 embedding(#24669);server 已迁移
  • 兼容性:LLAMA_SESSION_VERSION 升至 11、LLAMA_STATE_SEQ_VERSION 升至 4,旧的会话/状态文件需重新生成
  • Server:/v1/models 返回输入输出模态;/v1/embeddings 接受图像/音频/视频类型输入;新增 /v1/systemone 决策模型接口
阅读全文
关联模型 / 智能体 / 厂商:

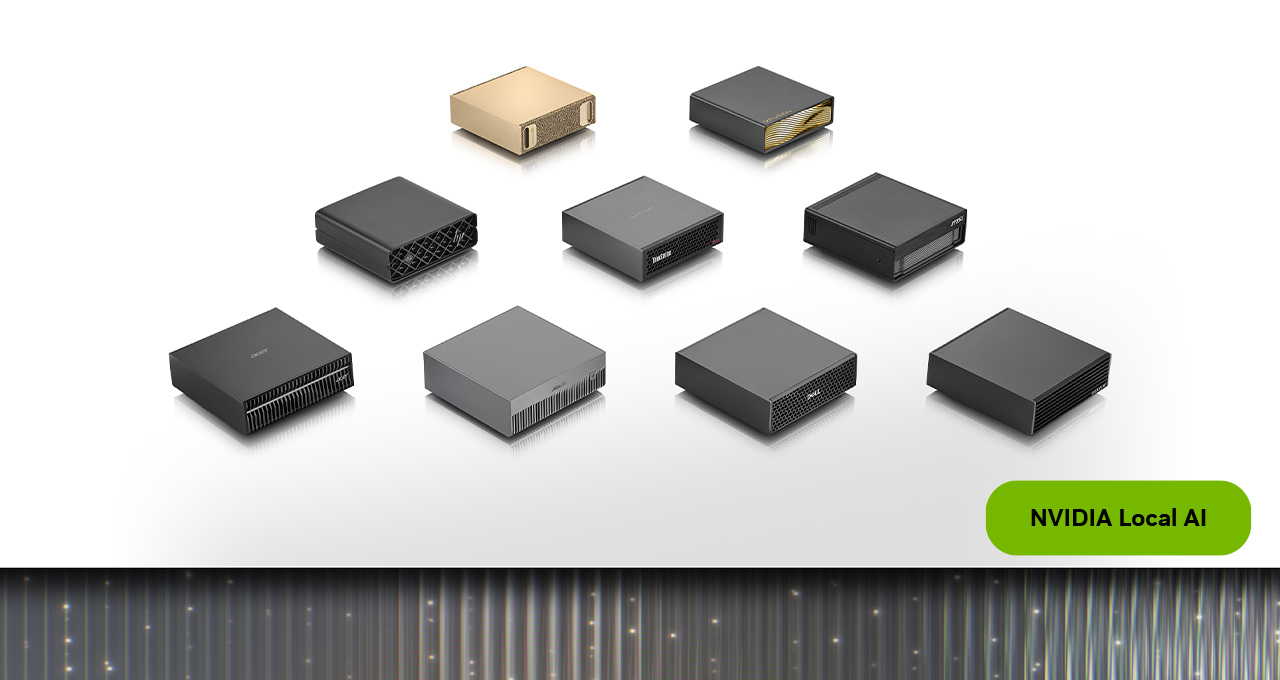
NVIDIA 推出 DGX Spark 64GB:10/23 起 OEM 开卖起价 $4,999;双机集群最高约 1.7×,本地跑至约 100B

NVIDIA 于 2026-10-02 在博客宣布 DGX Spark 64GB:10 月 23 日(周五) 起经 Acer / ASUS / Dell / Gigabyte / HP / MSI 发售,起价 $4,999。同款 GB10 Grace Blackwell、DGX OS 与完整 CUDA AI 栈;单机统一内存 64GB、官方称可本地支撑约 100B 参数模型与 Agent。两台经 ConnectX-7 + QSFP 集群可池化 128GB(约 200B);Qwen 3.8 27B 测试中双 64GB 相对单机最高约 1.7×。

NVIDIA 推出 DGX Spark 64GB:10/23 起 OEM 开卖起价 $4,999;双机集群最高约 1.7×,本地跑至约 100B

核心要点速览

  • 官宣:NVIDIA Blog — DGX Spark 64GB(Allen Bourgoyne,2026-10-02)
  • 渠道与价格:2026-10-23 起 OEM(Acer/ASUS/Dell/Gigabyte/HP/MSI);博客写明 starting at $4,999;64GB 仅经参与 OEM
  • 算力栈:保留 GB10 + DGX OS + CUDA AI;开箱支持 Agent Toolkit、Ollama、vLLM、PyTorch、Nemotron 等
  • 扩展:内置 ConnectX-7;双机 QSFP 直连池化 128GB / 约 200B 参数;Qwen 3.8 27B 实测双机相对单机最高约 1.7×
  • 月底预告:NVIDIA Sync Model Launcher 可一键拉起 Qwen3.8 27B,并配置 OpenCode 走本地模型
阅读全文
AD赞助内容

开发者把 DeepSeek V4 Flash 判断能力蒸馏到 4B:DGX Spark 训练 26 小时,单次约 22ms

开发者 Taro L. Saito(@taroleo)参照 TypeSafe Jev 的思路,放弃完整 text/json 生成、只保留判断头,把约 157GB 权重的 DeepSeek V4 Flash 决策能力在 DGX Spark 上蒸馏约 26 小时迁入 4B 模型。结果体积约缩为教师的 1/20,并在即时回答模式下超过教师,单次判断约 22ms,展示纯本地 LLM 做高速决策引擎的可行性。

核心要点速览

  • 以 Jev 式「只做判断、不做长文本生成」把 DeepSeek V4 Flash 决策蒸馏到 4B。
  • DGX Spark 上约 26 小时完成蒸馏;体积约缩为教师 1/20,单次判断约 22ms。
  • 作者称在即时回答模式下已超过教师,适合本地高速分流/门控场景。
阅读全文
关联模型 / 智能体 / 厂商:

MiaAI:GLM-5.3-Flash EXL3 新增 TP=3 三卡 DGX Spark 路径,解码 +28% 且支持头节点 NFS 共享权重

MiaAI Lab(@MiaAI_lab)为 GLM-5.3-Flash EXL3 增加 TP=3 路径,可在三台 DGX Spark 上运行:相对 TP=2 解码速度 +28%、prefill +9%,并给出 3.2M KV cache 与 1M 上下文;另可选从头节点经 NFS 共享权重(NFS_SHARE=1),释放其余节点磁盘。仓库:github.com/MiaAI-Lab/GLM-5.3-Flash-EXL3-2x-DGX-Sparks。

核心要点速览

  • 新增 TP=3:三台 DGX Spark 跑 GLM-5.3-Flash EXL3。
  • 相对 TP=2:解码 +28%、prefill +9%;3.2M KV / 1M 上下文。
  • 可选 NFS_SHARE=1 从头节点加载权重,释放其余节点空间。
阅读全文
关联模型 / 智能体 / 厂商:

NVIDIA RTX Spark:本地 Agent 加速——RTX 5090 上 llama.cpp 最高 1.9×,Blackwell vLLM 1.2×

NVIDIA RTX Spark 公布本地 Agent 推理优化:GeForce RTX 5090 上 llama.cpp 吞吐最高提升约 1.9 倍;RTX PRO 6000 Blackwell 上 vLLM 约 1.2 倍;双机 DGX Spark 集群最高约 1.4 倍。面向本地部署与边缘 Agent 服务路径的持续加速。

核心要点速览

  • llama.cpp:RTX 5090 吞吐最高约 1.9×,本地 Agent 推理更轻。
  • vLLM:RTX PRO 6000 Blackwell 约 1.2×;双机 DGX Spark 集群最高约 1.4×。
  • 定位:强化本地 / 边缘 Agent 服务栈,而非仅云端推理。
阅读全文
关联模型 / 智能体 / 厂商:

SGLang:DeepSeek-V4-Flash-Vision 与 Flash-0731 食谱上线,支持 2×DGX Spark 与 nvfp4

SGLang 宣布为 DeepSeek-V4-Flash-Vision 与 DeepSeek-V4-Flash-0731 增加在 2×DGX Spark 上的部署食谱。Flash-Vision 带原生视觉;Flash-0731 支持 fp4 与 NVIDIA 官方 nvfp4;两者均跑在 b12x 内核库上,文档见 docs.sglang.io cookbook。

核心要点速览

  • 2×DGX Spark 食谱覆盖 Flash-Vision 与 Flash-0731。
  • Flash-Vision:原生视觉;Flash-0731:fp4 + NVIDIA nvfp4。
  • 两者均基于 b12x 内核库,便于本地/边缘高吞吐推理。
阅读全文

Perplexity Portable Computer 登陆 Linux:支持 24GB+ VRAM 的 NVIDIA RTX 本地运行

Perplexity(@perplexity_ai)宣布 Portable Computer 现可在 Linux 上运行,面向 24GB 及以上显存的 NVIDIA RTX GPU。产品定位为本地优先 AI 助手栈:编排器与子智能体可在设备侧私有运行,必要时再升到云端;此前已覆盖 NVIDIA DGX Spark,此次把本地部署扩展到消费级/工作站 RTX。

核心要点速览

  • Linux 版本要求 NVIDIA RTX 且显存 ≥24GB。
  • 本地优先:编排 LLM、子智能体与 agent harness 可在设备侧运行。
  • 与 DGX Spark 版互补,降低高显存 RTX 工作站的本地部署门槛。
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 推出 Portable Computer:基于 NVIDIA DGX Spark 的全本地化自主智能体栈

Perplexity 面向 Pro 与 Max 订阅用户推出 Portable Computer,基于 NVIDIA DGX Spark 硬件实现编排器、子 Agent 与底层 Harness 100% 本地运行。搭载针对知识工作微调的 PPLX 27B 模型,私密文档默认绝不出设备。

核心要点速览

  • 本地优先商业化落地:所有私有文档与本地代码默认完全留在设备内,仅在用户授权后才调用云端搜索;
  • 为 27B 端侧模型专门优化的轻量级 Harness,采用紧凑 CLI 连接器与沙箱自验证机制替代庞大 MCP;
  • 支持渐进式云端提权:遇复杂难题可单次付费(约 $0.42)调用云端前沿推理,将 Terminal Bench 分数提升至 73.0%。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容