AI 编程实时动态与要闻

Planet AI App 正式 GA:自然语言检索十年卫星影像,地图对话 + Deep Research Agent

2026-11-05,Planet Labs 宣布 Planet AI App 正式 GA:以地图对话界面检索十年以上、3000+ 层日更卫星影像,支持自然语言搜地、时序对比与 Deep Research Agent 分析;入口 ai.planet.com。
Planet AI App 正式 GA:自然语言检索十年卫星影像,地图对话 + Deep Research Agent

核心要点速览

  • 官方:@planet / CEO @Will4Planet 2026-11-05;博客 Introducing the Planet AI App
  • 能力:自然语言搜地、十年时序对比/延时、上传文件与定时报告、Deep Research Agent
  • 数据:厂商口径 10+ 年日更影像、3000+ 图层;结果可回看 Planet 原图核验
  • 入口:ai.planet.com;面向非 GIS 用户的发现阶段,不替代专业 GIS
  • 官方未公布独立模型 Benchmark 或定价明细;beta 百人级用户反馈驱动发现期增强
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic 公布 Claude 助力新药研发早期成果:与 BMS 等 6 家机构深度合作,并收购 Mithril Medicine 自建药物项目

Anthropic 10 月 27 日发布博客,介绍其生命科学团队过去数月与 BigHat、Bristol Myers Squibb、Divergence Labs、Enveda、Generate Biomedicines、The Column Group 六家机构的深度合作,覆盖从苗头分子生成、先导优化到生产文档和临床试验规划等环节,并披露已收购单人公司 Mithril Medicine、自建罕见儿童肌营养不良药物项目。官方强调目前成果大多处于临床前阶段。

Anthropic 公布 Claude 助力新药研发早期成果:与 BMS 等 6 家机构深度合作,并收购 Mithril Medicine 自建药物项目

核心要点速览

  • Divergence Labs:Claude 约一个月内基本自主生成约 35,000 个抗体设计,找到 3 个能结合 IgE、20 个能使其脱离免疫细胞的苗头,其中 3 个脱离效果强于标准药物(官方口径)
  • BigHat:约 10 周内实验室制备测试约 1,010 个变体,最佳版本结合力提升 10 倍以上,抗癌先导耐热提高 18°C,另一先导聚集速度降低 100 倍以上
  • Enveda:在 1,061 页生产文档上,Claude 抓到人工发现的全部 11 个问题并多找出 7 个,人工审阅时间减少 89%(25 小时以上降到 3 小时以内)
  • Generate Biomedicines:用 Claude Code 设计的 CAR-T 组件缩短约 70%,免疫细胞受体表达约提升 10 倍
  • 收购 Mithril Medicine:创始人借助 Claude 协调 11 家外部实验室,不到 18 个月从想法做到小鼠阳性结果,官方预计最早 2028 年底进入人体试验(官方博客)
阅读全文

Google 发布 Gemini API CLI(gemini-api)实验预览:零依赖 Go 二进制,让 Claude Code、Codex、Cursor 等编码 Agent 直接出图、出视频、转写并调度托管 Agent

Google AI Studio 团队发布 Gemini API CLI(命令名 gemini-api)实验预览版。它是一个无状态、零依赖的 Go 单文件,支持 macOS、Linux、Windows,Apache 2.0 开源。任何有 shell 权限的编码 Agent 配好 GEMINI_API_KEY 后,就能用一条命令调用文本推理、图像/视频/音乐/语音生成、文件与 YouTube 分析、音视频转写,以及 Deep Research 等托管 Agent。媒体结果直接写到磁盘、只把文件路径打印到 stdout,避免把 base64 塞进上下文。官方说明它是实验项目,不属于受支持的 Google 产品。

Google 发布 Gemini API CLI(gemini-api)实验预览:零依赖 Go 二进制,让 Claude Code、Codex、Cursor 等编码 Agent 直接出图、出视频、转写并调度托管 Agent

核心要点速览

  • 默认模型(官方 README):generate/analyze/transcribe 用 gemini-3.8-flash,image 用 gemini-nano-banana-2.1,video 用 gemini-omni-1.1-flash,music 用 lyria-3.5,tts 用 gemini-3.8-flash-tts
  • 安装:macOS/Linux 一行 curl 脚本、Windows 用 PowerShell 脚本,或 go install;GitHub 最新版本为 v0.4.3(2026-10-19 发布)
  • 面向 Agent 的机器接口:--usage 输出 KDL 命令树、--schema 输出 JSON Schema、--dry-run 离线校验且隐去凭据、--output-format json/toon、内置 --jq
  • 退出码区分 4 种情况:0 成功、1 运行/API 失败、2 用法或校验错误、3 鉴权失败;--agent-mode 输出结构化 JSON 错误
  • 还能管理托管 Agent 的沙箱环境、服务端凭据、Webhook 和 cron 触发器;Files API 上传文件保留 48 小时
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Gemini 3.8 Flash⚡ Gemini Nano Banana 2.1⚡ Gemini Omni 1.1 Flash⚡ Lyria 3.5⚡ Gemini 3.8 Flash TTS🤖 Gemini API CLI🤖 Claude Code🤖 Codex🤖 Cursor🤖 Antigravity🤖 Deep Research🌐 Google

腾讯混元开源 LifeSearch:首个真实生活与复杂生产力 Deep Research 智能体基准,4500小时人图标注揭示顶尖模型最高仅 63.4%

当前 Deep Research 智能体评测大多局限于学术科研与合成问答,难以反映真实日常决策与复杂工作流。腾讯混元团队推出 LifeSearch 基准,涵盖 7 大生活生产力领域的 203 个中英文真实任务,投入逾 4500 小时专家标注提炼 4000+ 条细粒度评分规则。实测 12 款主流深度研究智能体显示,顶尖模型最高仅获 63.4% 分数,暴露长程网页搜索、多源冲突时间线融合等关键短板。

腾讯混元开源 LifeSearch:首个真实生活与复杂生产力 Deep Research 智能体基准,4500小时人图标注揭示顶尖模型最高仅 63.4%

核心要点速览

  • 首创真实生活与生产力评测集:覆盖旅游规划、医疗消费决策、商业比价等 7 大现实场景,包含 203 项来自真实种子的高难度任务
  • 4500 小时 4000+ 条细粒度规则:融合报告深度与数值、单位、日期、URL 四重硬约束,专家对齐度达 Spearman 0.89
  • 顶尖智能体天花板显现:即便是最强前沿模型综合得分也仅为 63.4%,在多源信息时效核对与长程深潜检索上仍存在巨大提升空间
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

打破搜索与浏览器交互割裂!统一智能体网络接口 Web$hell 发布:Deep Research 交互轮次大降 66%

随着大模型智能体接管开放网络长程端到端任务(如全网深度调研、跨电商比价下单与多标签页复杂导航),现有的网络访问模式正遭遇难以调和的范式割裂:基于搜索 API 的轻量检索模型会粗暴丢弃网页可点击控件;基于无头浏览器的交互模型面临极度臃肿的高昂 Token 负担;而新兴的文件系统与 Shell 缓存模式(如 Fetch-then-Explore)在 selective grep 时极易丢失控件依赖上下文。延世大学(Yonsei University)研究团队在最新研究(arXiv:2610.13416)中正式提出了统一智能体网络接口 Web$hell。Web$hell 构筑于三大核心支柱:通过 WebContract 标准化对象/页面/操作通用契约,利用 WebCompiler 基于确定性 HTML 语义将网页极速编译为可寻址信息对象与操作对象(完全无需模型额外推理),并通过 WebCache 实现多版本有状态持久化回溯。在横跨网络搜索(WideSearch, SealQA)、网页导航(WebArena-Verified, WebWalkerQA)与深度研究(DeepResearchBench, DeepWeb-Bench)的 6 大基准全面评测中,Web$hell 在全部 6 项基准中均摘得最高胜率,将 Deep Research 任务轮次从 52.4 步和 30.9 步腰斩至 17.6 步(降幅高达 43%~66%),即使在人为注入 400 个干扰网页的高噪环境下成本与准确率依然保持高度平稳。

核心要点速览

  • 统一智能体网络接口 Web$hell 发布,打通搜索检索、网页交互与文件缓存三大割裂范式
  • 通过 WebContract、WebCompiler 与 WebCache 构筑确定性对象编译,横扫 6 大国际主流 Web 任务评测基准
  • Deep Research 交互轮次由 52.4/30.9 步腰斩至 17.6 步(大降 66%),即使在 400 个干扰网页压力下成本依然平稳
阅读全文

复旦等开源 OneSearch-VL:统一多模态深度研究智能体,图谱引导跑分大幅超越 Qwen3-VL 20.2 个百分点

自主深度研究智能体(Deep Research Agents)正在从传统的纯文本网页检索,全面迈向针对图像细节、复杂图表与长视频的跨模态研究任务。然而,现有多模态模型在面对单图、多图与长视频输入时,往往无法精确定位细粒度视觉锚点,缺乏从画面线索跨越到外部搜索验证的严密逻辑链条。复旦大学等联合研究团队在最新研究(arXiv:2610.12419)中发布了 OneSearch-VL:业界首个针对图像与长视频全场景的统一多模态深度研究智能体框架。OneSearch-VL 创新性地提出了‘视觉锚定证据图(VGEG)’架构,将视觉定位、外部工具检索、实体关联与事实聚合显式编码为统一的依赖图谱。基于 VGEG,团队构建了包含 110K 样本的 SFT 数据集与 10K 样本的强化学习(RL)数据集,并在后训练中引入了证据感知的视觉对齐奖励函数(EVGR)。在专门针对多图与长视频深度研究的全新评测集 OneSearch-MI-Bench 与 OneSearch-Video-Bench 上,仅 8B 参数的 OneSearch-VL-8B 相比挂载工具的 Qwen3-VL-8B 成功率分别大幅跃升 20.2 和 17.6 个百分点,并在 7 项传统图像基准与 VideoDR 上全线刷新纪录,官方代码已开源。

核心要点速览

  • 复旦等开源 OneSearch-VL,首创基于视觉锚定证据图(VGEG)的统一图像与视频深度研究智能体
  • 在多图与长视频基准上超越挂载工具的 Qwen3-VL-8B 高达 20.2 和 17.6 个百分点,视觉引证可靠率达 91.8%
  • 开源 110K SFT 与 10K RL 数据集及 EVGR 细粒度过程奖励,为多模态 Agent 奠定可追溯工程标准
阅读全文
关联模型 / 智能体 / 厂商:

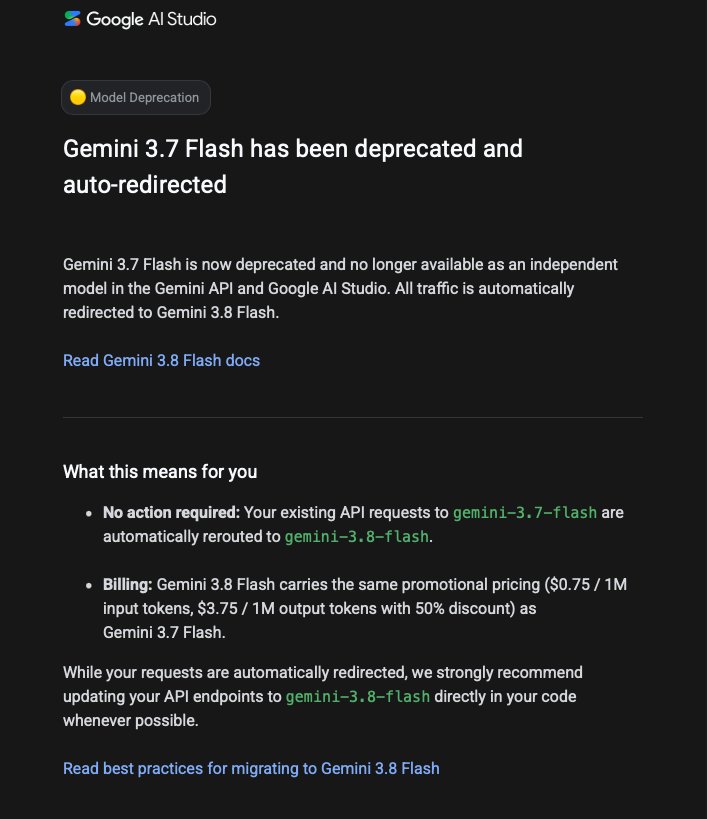
Gemini API 废弃 3.7 Flash:请求自动改路由到 3.8 Flash,3.5 Flash 同步转向 3.6,旧版 Deep Research 代理 10 月 23 日关停

Google 在 Gemini API 发布说明(10 月 8 日条目)中宣布 gemini-3.7-flash 废弃,所有调用自动转发到 gemini-3.8-flash;gemini-3.5-flash 同样自动转发到 gemini-3.6-flash。deep-research-pro-preview-12-2025 代理将于 10 月 23 日关停,需迁移到 04-2026 版本。10 月 10 日起开发者陆续收到邮件通知。

Gemini API 废弃 3.7 Flash:请求自动改路由到 3.8 Flash,3.5 Flash 同步转向 3.6,旧版 Deep Research 代理 10 月 23 日关停

核心要点速览

  • 2 个模型 ID 被静默改路由:gemini-3.7-flash → gemini-3.8-flash,gemini-3.5-flash → gemini-3.6-flash(官方发布说明)
  • 价格不变:3.8 Flash 付费层输入 $0.75 / 输出 $3.75 每百万 token(至 2026-12-31),2027-01-01 起 $1.50 / $7.50(定价页)
  • Deep Research 旧代理 deep-research-pro-preview-12-2025 于 2026-10-23 关停,迁至 deep-research-preview-04-2026 或 -max-preview-04-2026
  • 废弃页显示 3.6 Flash 仍可用且未公布关停日期,3.7 反而先被替换
阅读全文

告别盲目死循环!清华与人大提出增量式深度研究框架 IOEDR:动态图脚手架节省 33% Token 与 61% 搜索调用

以 OpenAI Deep Research、Perplexity Deep Research 为代表的自主深度研究智能体(Deep Research Agents)正在重构人类信息获取与综合分析的范式。然而,面对高度发散、长达数十轮的开放式命题(如行业全景深度报告、复杂技术选型论证),现有智能体普遍采用‘黑盒式单向搜索-汇总’策略,导致三大严重弊端:模型在浩瀚网页中陷入重复无意义搜索、各章节间观点自相矛盾且事实漂移严重、随着探索深入上下文急剧膨胀产生数十万冗余 Token。清华大学与中国人民大学研究团队最新发布重磅成果《Incremental Open-Ended Deep Research with Structured Harness》(arXiv:2610.11566,项目主页:ioedr-project.github.io)。团队提出了增量式深度研究新范式 IOEDR,首次将研究报告生成建模为‘不断进化的层级状态图(Hierarchical State Graph)与全局证据池(Persistent Evidence Pool)’。智能体不再盲目抓取,而是基于结构化脚手架(Structured Harness)驱动探索边界:通过动态大纲增量扩展、证据置信度交叉检验以及目标导向的停机判定,精准填补知识空白。在权威的 DeepResearch Bench 上,IOEDR 不仅将生成报告的事实准确率与多维深度显著提升,更将整体 Token 消耗骤减 33.2%,外部搜索 API 调用次数暴跌 61.4%!

核心要点速览

  • 清华与人大联合提出增量式深度研究框架 IOEDR,将长文研报建模为层级状态图与全局去重证据池
  • 在 DeepResearch Bench 上削减 61.4% 的搜索 API 请求,整体 Token 消耗骤降 33.2%,解决跨章节事实漂移与自相矛盾
  • 结构化脚手架引入信息增益评估与动态停机机制,抗噪过滤率高达 92.4%,为 Deep Research 产品提供高可靠工程范式
阅读全文

Claude Managed Agents「动态工作流」进入公开测试:主 Agent 自己写编排程序,单次最多并发 64 线程、调度 1000 个子 Agent

Anthropic 将 Managed Agents 的 dynamic workflows 扩展为公开测试:在 agent 的 multiagent 配置中开启 workflows 后,Claude 会为任务编写一段“工作流程序”,在后台分阶段扇出大量 Agent 并汇总结果,适合审计、迁移、深度调研和大规模交叉核对。

核心要点速览

  • 开启方式:multiagent.type: "multiagent_20261001" + workflows: {"type": "enabled"},需 managed-agents-2026-04-01 beta 头(文档)
  • 单个 run 同时工作线程上限 64,全生命周期最多启动 1,000 个 Agent,超出以 thread_limit_error 结束(Workflow runs)
  • run 默认寿命 24 小时,单 session 默认最多 10 个 run 同时打开,run 不能嵌套
  • run 本身不单独计价,各线程 Token 按模型价计费并计入 session budget,触达预算自动暂停
阅读全文
关联模型 / 智能体 / 厂商:

测试时自我进化新纪元!AREX-2 框架开源:长程反思任务驱动持续迭代,MLE-bench 狂揽 81.8 分

智能体在推理部署时的自我迭代升级能力(Test-Time Self-Improvement),是当前迈向 AGI 的核心演进方向。这一能力依赖两大互补支柱:能够敏锐识别错误并产出更优解的“反思(Reflection)”,以及能支撑算法经历多轮长时间交互而不发生上下文崩溃的“长程执行(Long-Horizon Execution)”。中国人民大学、微软亚洲研究院与中国科大团队联合推出了 AREX-2 框架:研究团队发现这两种核心能力具备极强的领域无关通用性(Domain-Agnostic),并通过在具备确定性结果校验的机器学习工程(ML Engineering)与算法编程任务中,合成了极具挑战的长程反思训练轨迹。基于 Qwen3.8-27B 打造的 AREX-2 智能体在 MLE-bench Lite 上斩获 81.8 的超高分,并零样本跨域迁移至深度研究(Deep Research)任务,在 BrowseComp 斩获 84.0 分、GAIA 斩获 92.2 分、DeepSearchQA 斩获 93.8 分,展现出随着迭代轮数增加而持续单调提升的强大自进化力。

测试时自我进化新纪元!AREX-2 框架开源:长程反思任务驱动持续迭代,MLE-bench 狂揽 81.8 分

核心要点速览

  • 提出测试时自我进化的两大领域无关支柱:高质量可验证反思与超长程执行连贯性
  • 基于 Qwen3.8-27B 打造的智能体在 MLE-bench Lite 斩获 81.8 分,Frontier-CS 斩获 70.7 分
  • 零样本成功迁移至深度研究任务,GAIA 达 92.2 分,DeepSearchQA 达 93.8 分,BrowseComp 达 84.0 分
阅读全文
AD赞助内容

测试期自主进化突破!中国人民大学等开源 AREX-2:长程反思轨迹赋能,MLE-bench 达到 81.8 高分

赋予大语言模型智能体在测试期(Test-Time)自主迭代完善解题方案的能力,是通往通用自主工程智能体的关键里程碑。来自中国人民大学等研究团队推出全新长程反思智能体框架 AREX-2。该研究发现测试期自演化依赖两大解耦的核心基石:产生优于当前方案的反思能力(Reflection)与支撑跨多轮次持续有效推进的长程执行力(Long-Horizon Execution)。由于这两项能力具备领域通用性,团队在具备严格可验证反馈的机器学习任务与算法编程领域构建了高质量长程反思轨迹合成数据。基于 Qwen3.8-27B 训练的 AREX-2 在 MLE-bench Lite 斩获 81.8 的惊人高分,Frontier-CS 达 70.7;不仅如此,该能力强力迁移至复杂深度研究场景,在 GAIA(92.2)与 DeepSearchQA(93.8)上展现出伴随测试轮次增加而持续自我变强的演进曲线。

测试期自主进化突破!中国人民大学等开源 AREX-2:长程反思轨迹赋能,MLE-bench 达到 81.8 高分

核心要点速览

  • 解耦长程自进化为反思批判(Reflection)与长程执行(Long-Horizon Execution)两大通用能力支柱
  • 在 Qwen3.8-27B 上取得 MLE-bench Lite 81.8 与 Frontier-CS 70.7 的顶尖表现,并在 GAIA 斩获 92.2 高分
  • 突破多轮反思质量退化魔咒,解题质量随分配的反思轮次增加呈现稳健单调上升
阅读全文

CodeGraph 开源首个代码语义知识图谱:基于 Stack-Edu 构建 1.58 亿节点与 10 亿有向边,Wikidata 锚定算法与架构模式

由 Software Heritage 等机构学者联合研发的 CodeGraph 正式发布。面对公有仓库中海量代码仅能进行语法树级解析、无法提取算法范式与工程设计模式的瓶颈,团队利用代码大模型与三阶段实体对齐流水线(SPARQL 确定性链接、Deep Research Agent 长尾消歧与分类向上卷叠),在 Stack-Edu 的 1.67 亿文件中构建出包含 1.58 亿节点与 10 亿类型化边的开放分类代码知识图谱,实现 Wikidata 全局知识锚定。

CodeGraph 开源首个代码语义知识图谱:基于 Stack-Edu 构建 1.58 亿节点与 10 亿有向边,Wikidata 锚定算法与架构模式

核心要点速览

  • 从语法解析跃迁至语义知识网络:突破传统 AST 语法分析局限于 Token 和语法树的困境,首次将代码中蕴含的高阶工程智慧(算法、设计模式、架构范式)显式结构化为语义实体。
  • 1.58 亿节点与 10 亿边超大规模:覆盖 14 种主流编程语言,图谱包含约 1.45 亿源码文件、63,000 个工程概念实体、19,800 个 Wikidata 权威实体,以及约 10 亿条类型化关系边。
  • 三阶段稳健知识对齐协议:采用确定性 SPARQL 链接消歧实体、Deep Research Agent 攻克长尾冷门概念、层级向上聚合闭包建立分类父子关系,结合 LLM-as-a-judge 与人工黄金集校准确保高精度标注。
阅读全文
关联模型 / 智能体 / 厂商:

Grok Bot 新增销售工具集成

Elon Musk 转发并称赞 Grok Bot 适合销售团队。Grok Bot 现可连接 Salesforce、HubSpot、Gong、Clay、Granola 等 GTM 工具,用于跟进客户、完成后续沟通并开展深度调研。

核心要点速览

  • Elon Musk 转发并称赞 Grok Bot 适合销售团队。Grok Bot 现可连接 Salesforce、HubSpot、Gong、Clay、Granola 等 GTM 工具,用于跟进客户、完成后续沟通并开展深度调研。
阅读全文
关联模型 / 智能体 / 厂商: