AI 编程实时动态与要闻

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

独立评测机构 Artificial Analysis 10 月 31 日发布知识与幻觉基准 AA-Omniscience v1.1,作为 Intelligence Index v5 的组成部分。新版题库从 6,000 题精简为 3,000 题,删掉已公开和已饱和的题目、修正错误与歧义并补充新题,同时在 Hugging Face 公开一套 300 题、难度与私有集校准的公开集,两者 Net Score 的 Pearson 与 Spearman 相关系数均为 0.99。结果显示 Gemini 4 Carbon(high)以 54 分领先,Claude Opus 5.5 为 48、Claude Fable 5.1 为 46;Fable 5.1 准确率最高(68%),Gemini 4 Argon 幻觉率最低(4%)。模型平均比 v1 低约 1.9 分,MiniMax M3.1 Flash 下滑 22 分。以上均为 Artificial Analysis 口径。

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

核心要点速览

  • 题库从 6,000 题精简到 3,000 题,覆盖 6 大领域、42 个主题:理工数学 600、软件工程 600,金融、健康、人文社科、法律各 450
  • 新的 300 题公开集已上 Hugging Face,与私有集 Net Score 的相关系数 0.99,中位差 0.0 分
  • Net Score 排名:Gemini 4 Carbon(high)54、Claude Opus 5.5 48、Claude Fable 5.1 46;开源权重最好的是 Muse Spark Open,落后 Gemini 4 Carbon 28 分
  • 准确率最高为 Claude Fable 5.1(68%),其次 Claude Opus 5.5(66%);幻觉率最低为 Gemini 4 Argon(4%)
  • 与 v1 排名的 Spearman 相关 0.98,但平均低 1.9 分;MiniMax M3.1 Flash 从 16 跌到 -6,MiMo V2.6 Pro 从 8 跌到 -5(官方口径)
阅读全文

Artificial Analysis 推出 AA-PersonalityBench 基准:首发大模型置信度与谄媚度排行榜

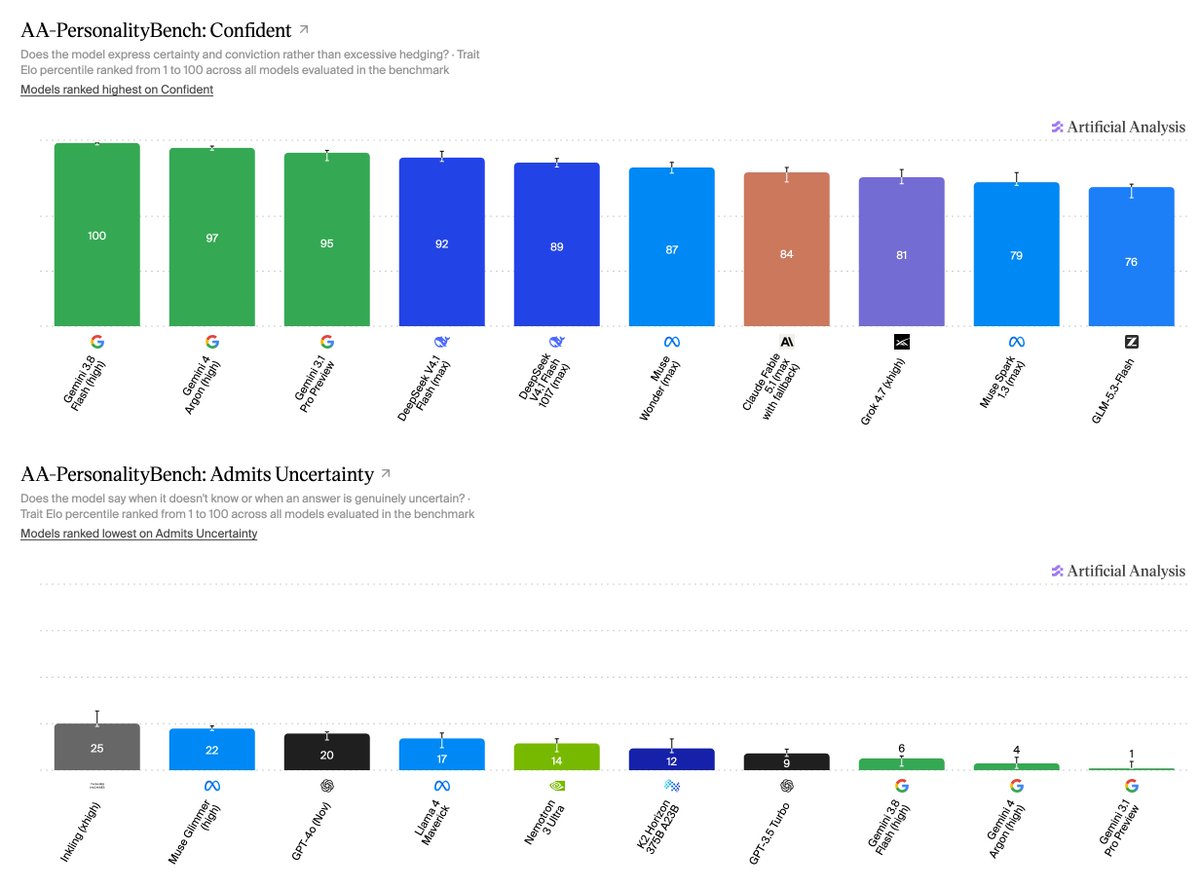
独立评测机构 Artificial Analysis 正式上线全新基准维度 AA-PersonalityBench,专门量化评估前沿大语言模型的拟人化心理特征,重点聚焦两大关键指标:置信度(Confidence / 不确定性承认度)与谄媚度(Sycophancy / 迎合用户错误倾向)。实测数据显示:在置信度维度上,Google Gemini 3.8 Flash 斩获 100 分满分,Gemini 4 Argon 达到 97 分,展现出极强的决策断言能力,但同时也是最不愿意承认自身不确定性的模型;在谄媚度测试中,开源大模型 Llama 4 Maverick 达到 97 分(极易毫无底线附和用户),而 Claude Fable 5.1 仅得 4 分(最坚持事实原则),为对齐工程提供了量化标尺。

Artificial Analysis 推出 AA-PersonalityBench 基准:首发大模型置信度与谄媚度排行榜

核心要点速览

  • Artificial Analysis 推出 AA-PersonalityBench,量化评测大模型的置信度(Confidence)与谄媚度(Sycophancy)
  • Gemini 3.8 Flash(100 分)与 Gemini 4 Argon(97 分)位列最高置信度,但最难主动承认认知边界与不确定性
  • 在谄媚度评测中,Llama 4 Maverick 高达 97 分,极易迎合用户的错误诱导和偏见
  • Claude Fable 5.1(4 分)与 Claude Opus 5.5(46 分)展现出优秀的抗诱导能力,客观坚守事实中立原则
阅读全文

Breken 发布“生产前的生产环境”:让合成用户和 Agent 跑真实软件找 Bug,自家 ESCAPES 基准抓到 235 个线上 Bug 中的 76 个,是 Claude Code 的两倍

10 月 21 日,初创公司 Breken 发布同名产品,定位“生产工程”:在隔离环境里重建整套软件,以 4000 倍速长出生产数据,让带意图和耐心的合成用户与 Agent 去使用,并逐一改变重试、丢包、时钟跳变等条件找故障,复现稳定后给出状态、trace 和修复草稿 PR。同时公布开放基准 ESCAPES:33 个开源项目、327 个已上线后被用户报告的 Bug,按 7 月 1 日代码扫描一次,Breken 抓到 235 个中的 76 个(32%),Claude Code 跑 Claude Fable 5.1 抓到 37 个(16%)。数据为厂商自测。

Breken 发布“生产前的生产环境”:让合成用户和 Agent 跑真实软件找 Bug,自家 ESCAPES 基准抓到 235 个线上 Bug 中的 76 个,是 Claude Code 的两倍

核心要点速览

  • ESCAPES 基准(厂商口径):33 个开源项目、327 个真实用户报告的 Bug,按 2026-07-01 代码扫描一次,计分对象为当时已存在的 235 个
  • 抓到数:Breken 76(32%,61 个跑出复现证明)、Claude Fable 5.1 + Claude Code 37(16%)、Claude Opus 5.5 + Claude Code 33(14%)、GPT-6 Astra + Codex CLI 28(12%)、Semgrep 9(4%)
  • 误报:Breken 20 个,Claude Fable 5.1 为 59 个,GPT-6 Astra 为 86 个;精度 85% 对 46%,加权分 +23.8% 对 -9.4%
  • 71% 的这类 Bug 只有在产品跑起来、配合真实数据、多用户、外部故障或时间流逝时才出现,中位数在代码里潜伏 152 天
  • 计费为预充值用量,最低 25 美元,提供 50/100/250 美元档,需用 GitHub 登录选择仓库
阅读全文

Artificial Analysis 发布 AA-Robotics v0.1:让编码智能体直接操控机械臂,GPT-6 Astra 以 69.4 分居首

独立评测机构 Artificial Analysis 于 2026-10-14 发布 AA-Robotics v0.1 研究预览:在 Codex、Claude Code、Antigravity 等编码智能体框架中,让前沿大模型通过 HTTP API 直接控制一台 6 轴机械臂完成 8 项桌面任务。GPT-6 Astra 得分 69.4 居首,GPT-6.1 Sol 64.6、Gemini 4 Argon 55.3、Claude Opus 5.5 48.8、Claude Fable 5.1 46.3;模型平均每项约 30 分钟,人类约 20 秒。

Artificial Analysis 发布 AA-Robotics v0.1:让编码智能体直接操控机械臂,GPT-6 Astra 以 69.4 分居首

核心要点速览

  • 总分(满分 100):GPT-6 Astra 69.4、GPT-6.1 Sol 64.6、Gemini 4 Argon 55.3、Claude Opus 5.5 48.8、Claude Fable 5.1 46.3(AA 原文)
  • 速度:模型平均约 30 分钟/任务(Argon 最慢约 52 分钟),人类平均约 20 秒,差距接近两个数量级
  • 成本:GPT-6.1 Sol 平均 $1.93/任务最便宜,GPT-6 Astra $16.36/任务,约 70% 花费来自视觉上下文输入
  • 抓取成功率:GPT-6 Astra 45%、Claude Fable 5.1 44%、Opus 5.5 40%、Argon 36%、Sol 28%
  • 「测量箱子」任务(误差需 ≤2 mm)五个模型最高仅 17 分,精细测量仍是短板
阅读全文
AD赞助内容

Arena 发布 Agent 版 Max 路由器:基于 250 万真实会话训练,在 Agent Arena 以低 37.5% 的成本追平 Fable 5.1 (Max)

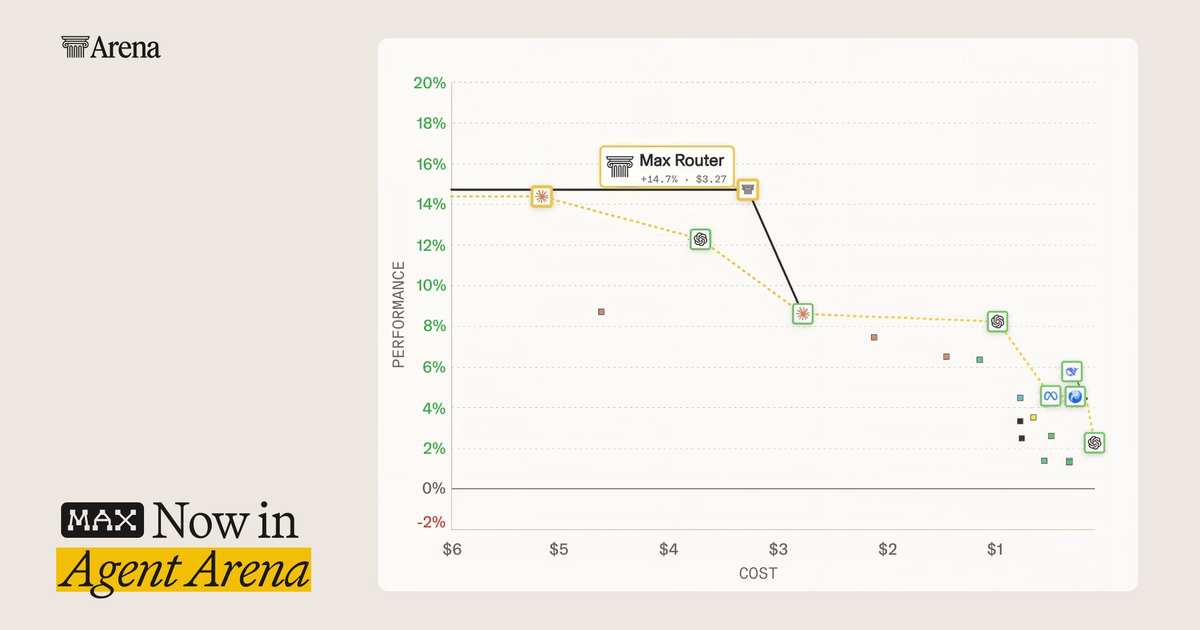
Arena(原 LMArena)发布 Agent 版 Max 路由器:基于 250 万+ 次真实 Agent Arena 会话训练,按任务复杂度、类型与成本在 Fable 5.1 (Max)、Astra (Max) 与 Astra (Medium) 间动态选模型。实测中它以 +14.7% 得分登顶 Agent Arena,单任务中位成本 3.27 美元,比当时第一的 Fable 5.1 (Max) 高 0.3% 且便宜 37.5%;代码会话 67% 被路由到更便宜的 Astra (Medium)。现可在 Agent Mode 限时免费试用,API 需填表申请。

Arena 发布 Agent 版 Max 路由器:基于 250 万真实会话训练,在 Agent Arena 以低 37.5% 的成本追平 Fable 5.1 (Max)

核心要点速览

  • 训练数据:250 万+ 次真实 Agent Arena 会话;过去 4 个月 Arena 共测试 60+ 个 Agent 模型(官方博客)
  • 实测成绩:Agent Arena 第 1,得分 +14.7%,单任务中位成本 3.27 美元;比 Fable 5.1 (Max) 高 0.3%,成本低 37.5%
  • 路由分布:代码 67% → Astra (Medium);聊天 Astra (Max) 49% / Fable 5.1 (Max) 42%;工作类 Fable 5.1 (Max) 49% / Astra (Medium) 43%
  • 可换模型组合:此前 Fable 5 + Kimi K3 组合净提升 +10.7%,中位成本 1.06 美元,比 Fable 5 (High) 高 0.6 个百分点、成本低 54%
  • 限制:训练数据截至 9 月 17 日,未覆盖 Opus 5.5;目前只能在 Agent Mode 试用,API 需申请
阅读全文

Anthropic 推出 Claude Opus 5.5

Anthropic 宣布 Claude Opus 5.5 即日起可用。它是新 Claude 5.5 系列的首个模型,多数任务表现接近 Claude Fable 5.1,运行成本比 Opus 5 低 40%。

核心要点速览

  • Anthropic 宣布 Claude Opus 5.5 即日起可用。它是新 Claude 5.5 系列的首个模型,多数任务表现接近 Claude Fable 5.1,运行成本比 Opus 5 低 40%。
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic 正式发布 Claude Opus 5.5:开启 5.5 世代,运行成本直降 40%、推理速度提升超 30%

Anthropic 宣布全新旗舰模型 Claude Opus 5.5 正式上线,作为 Claude 5.5 家族的首发成员。官方实测显示,Opus 5.5 在绝大部分复杂推理与 Agentic 编码任务中已达到前代旗舰 Claude Fable 5.1 水平,而在典型企业工况下的运行成本相比 Opus 5 降低了 40%,输出速度提升超 30%,API 价格定为输入 $4/M、输出 $20/M,提示词缓存读取仅 $0.20/M。

核心要点速览

  • Claude 5.5 世代首发旗舰,多项核心任务综合能力平齐 Claude Fable 5.1。
  • 单任务综合成本降低约 40%,输出吞吐速度提升超 30%,大幅改善长链路 Agent 响应延迟。
  • API 价格为 $4/M 输入、$20/M 输出,提示词缓存读取仅 $0.20/M,缓存写入 $5/M。
  • 在 Anthropic 自动化行为安全审计中取得历史最高分,强化敏感代码与网络防御过滤。
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic 发布 Claude Opus 5.5:多数任务达 Fable 5.1 水平,典型负载成本约降 40%

Anthropic / Claude(@claudeai,@AnthropicAI 转发确认)宣布 Claude Opus 5.5 今日可用,为新 Claude 5.5 系列首个模型。官方称多数任务表现达到 Claude Fable 5.1 水平,相对 Opus 5 在 agentic coding、computer use 与知识工作上显著提升;默认设置下典型负载运行成本约低 40%。同步提高 Pro/Max/Team 五小时用量上限,并为订阅用户提供可留存的速率限制重置。

Anthropic 发布 Claude Opus 5.5:多数任务达 Fable 5.1 水平,典型负载成本约降 40%

核心要点速览

  • Claude 5.5 系列首发 Opus 5.5,今日可用;多数任务对齐 Claude Fable 5.1。
  • 相对 Opus 5 在 agentic coding、computer use 与知识工作上领先;默认典型负载成本约降 40%。
  • Pro/Max/Team 五小时用量上限上调,订阅用户获可留存的速率限制重置。
阅读全文

Anthropic 宣布 Claude Opus 5.5 今日上线

Anthropic(@AnthropicAI)确认 Claude Opus 5.5 今日可用;详见同日 @claudeai 发布主帖。该模型为 Claude 5.5 系列首发,多数任务达 Fable 5.1 水平,典型负载成本约比 Opus 5 低 40%。

Anthropic 宣布 Claude Opus 5.5 今日上线

核心要点速览

  • @AnthropicAI 确认 Opus 5.5 今日可用。
  • 为 Claude 5.5 系列首个模型,多数任务达 Fable 5.1。
  • 典型负载成本约比 Opus 5 低 40%。
阅读全文

Artificial Analysis:Grok 4.7 + Grok Build Coding Agent Index 56,跻身第四;智能指数 46 进入前四实验室

@ArtificialAnlys 评测 Grok 4.7(xhigh):Intelligence Index 46(较 4.6 +2),SpaceXAI 进入前四实验室;Grok 4.7 + Grok Build 的 Coding Agent Index 为 56(较 4.6 +9),在原生 harness 中排名第四,仅次于 Claude Fable 5.1、GPT-6 Astra 与 Claude Opus 5。定价仍为 $2/$6 per 1M in/out,缓存命中 $0.50,上下文 500k。

Artificial Analysis:Grok 4.7 + Grok Build Coding Agent Index 56,跻身第四;智能指数 46 进入前四实验室

核心要点速览

  • Coding Agent Index:Grok 4.7 + Grok Build 拿下 56 分(+9),原生 harness 中排名第四。
  • Intelligence Index 46(+2),SpaceXAI 进入前四实验室;AA-Briefcase +111 Elo。
  • 定价与 4.6 相同:$2/$6 per 1M,缓存 $0.50;上下文 500k;增益伴随更高 token 用量。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Vercel:TypeSafe Jev 成 AI Gateway 史上采纳最快模型,首日覆盖约 13% 付费团队

Vercel 官方发文称 TypeSafe Jev 登陆 AI Gateway 后 24 小时内成为史上采纳最快的模型:首日触达近 13% 付费团队,约为 GPT-5.6 系列的 2 倍、Fable 5.1 的 6 倍以上;约 18 小时即突破 10% 团队渗透,而同期其他新模型全日仍低于 7%。博文指出下一步关注早期热度能否持续。

核心要点速览

  • 官方数据:Jev 首日覆盖近 13% AI Gateway 付费团队,创历史最快采纳。
  • 对比:约为 GPT-5.6 系列 2 倍、Fable 5.1 逾 6 倍;约 18 小时达 10% 团队。
  • 详情见 vercel.com/blog/ai-gateway-jev-model-launch;后续关注热度能否延续。
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic 设立新加坡亚太总部,任命东盟总经理加速企业级落地

Anthropic 正式宣布在新加坡设立亚太地区运营总部,并任命前科技高管 Dale Finlay 出任东盟区总经理。新总部将全面对接东南亚各主要金融中心、政府机关与软件工程团队,加速 Claude Fable 5.1 / Mythos 5.1 在跨境合规、政企代码审计及私有安全部署领域的规模化落地。

核心要点速览

  • 设立新加坡亚太总部,深耕东南亚及亚太核心企业级市场
  • 针对金融、跨国法务与关键基础设施代码安全提供本地合规与专属技术支持
  • 标志着 Anthropic 与 OpenAI 在全球核心区域枢纽的商业化竞争全面提速
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Claude 5.1🌐 Anthropic

Vercel AI Gateway 九月指数:开源权重模型首次占 Token 量 56%,Astra 花费超 Fable 5.1 一倍

Vercel 发布 AI Gateway Production Index(2026 年 9 月,数据截至 8 月)。开源权重模型首次占网关 Token 量多数,从去年 12 月的 7% 升至 8 月的 56%;平均 Token 价格连续第三个月下降,8 月再降 23.2%。特别报告显示 GPT-6 Astra 上线 12 天内占全网关花费 7.7%,约为同期 Fable 5.1 的两倍。

核心要点速览

  • 开源权重模型首次占 AI Gateway Token 量 56%,较 2025 年 12 月的不足 10% 大幅跃升。
  • 8 月平均 Token 价格再降 23.2%,连续第三个月下跌;百万 Token 以上团队中位数花费下降 7.6%。
  • GPT-6 Astra 上线 12 天占全网关花费 7.7%,约为同期 Anthropic Fable 5.1 的两倍,并在两天内占 OpenAI 花费约三分之一。
阅读全文
关联模型 / 智能体 / 厂商:

Vals 发布 Vibe Code Bench 1-100:测模型能否在长序列产品改动中不破坏已有功能

Vals 今日发布 Vibe Code Bench 1-100(VCB 1-100):在已通过的完整 Web 应用上,要求模型按依赖顺序完成多轮产品改动,且不能破坏既有行为;首个未完成迭代即终止。官方榜单显示 Claude Opus 5 以 28.53% 领先,Claude Fable 5.1 28.00%、GPT-6 Astra 27.64% 紧随其后。相对只评「从零做出能跑版本」的基准,该套题更贴近真实持续演进的 vibe coding / 编程智能体工作负载。

核心要点速览

  • VCB 1-100 从已通过的完整应用起步,按依赖顺序施加多轮产品请求,首个失败迭代即终止。
  • 榜单:Claude Opus 5 28.53%,Claude Fable 5.1 28.00%,GPT-6 Astra 27.64%。
  • Vals 指出模型自我测试差异大:Opus 5 / Fable 5.1 约三分之一工具调用为浏览器;Grok 4.6 几乎不用浏览器。
阅读全文

Vals:Terminal-Bench 4.0 上线,GPT-6 Astra 以 57.1% 登顶,Fable 5.1 / Opus 5 分列二三

Vals AI 发布 Terminal-Bench 4.0:66 道全新终端任务(交付服务、证明定理、训练 GPU kernel、写取证报告等),专家预估中位耗时约 4 小时,严格 verifier 全过才计分,分数为 avg@3。GPT-6 Astra 以 57.1% 夺冠,领先 Claude Fable 5.1(49.5%)7.6 个百分点、Claude Opus 5(45.5%)11.6 个百分点;其余模型均未过 30%,14/27 个模型在硬件与媒体域得零分。4.0 覆盖软件、科学、ML、运维、硬件、安全、媒体七类,约四分之三任务已超出传统软件工程。

核心要点速览

  • Terminal-Bench 4.0:66 道新终端任务,中位专家工时约 4 小时,严格 verifier + avg@3
  • GPT-6 Astra 57.1% 登顶,领先 Fable 5.1(49.5%)与 Opus 5(45.5%);其余均未过 30%
  • 覆盖七大类且约 3/4 任务超出传统软件工程,全部与 v2.1 无重叠
阅读全文