AI 编程实时动态与要闻

Fish Audio 发布全双工语音模型 Live 3:边说边听、会回应「嗯嗯」并判断何时让出话轮,最快 186 毫秒决定回应,语音智能体每分钟 0.035 美元

Fish Audio 于 11 月 10 日(新加坡时间 11 日凌晨 02:02)发布全双工语音模型 Live 3。它在说话的同时持续收听,能用「嗯嗯」「好的」等附和语确认听到,同时把话轮留给用户;能区分附和与真正的插话,用户改口时会等对方说完。官方称这些行为从真实人类对话中学来,而不是靠规则和阈值,最快 186 毫秒即可决定回应。Live 3 目前只支持英语,已上线 Fish Agent 平台和 API,企业可本地部署;语音智能体限时价每分钟 0.035 美元(原价 0.07 美元,优惠至 2026 年 12 月 31 日)。官方未公布标准化 Benchmark。

Fish Audio 发布全双工语音模型 Live 3:边说边听、会回应「嗯嗯」并判断何时让出话轮,最快 186 毫秒决定回应,语音智能体每分钟 0.035 美元

核心要点速览

  • 全双工:Live 3 说话时持续收听,把话轮判断放进语音模型本身,而不是 ASR、LLM、TTS 串联管线里的规则
  • 延迟(官方口径):最快 186 毫秒决定回应,先用「mm-hmm」「okay」等短回应维持对话,完整答案在后台生成
  • 价格:语音智能体每分钟 $0.035(原价 $0.07,5 折优惠至 2026-12-31),语音识别、LLM、语音合成合并计费;电话另加 $0.01/分钟,注册送 $5 额度
  • 限制:目前只支持英语;官方未公布标准化 Benchmark,只放出 3 段真实测试通话录音
  • 部署:Fish Agent 平台、API 和企业本地部署三种方式,支持全双工与级联两种模式
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 宣布 12 月 11 日下线 ChatGPT 的 Advanced 与 Standard 语音:全部切到全双工 GPT-Live,实时视频和屏幕共享暂时仍由 Advanced 支撑

OpenAI Newsroom 11 月 10 日宣布,ChatGPT Voice 中的 Advanced voice 和 Standard voice 将于 2026 年 12 月 11 日退役。官方称自 7 月推出 GPT-Live 以来,语音使用量接近翻倍,几乎所有语音用户都已在用 GPT-Live,下线旧模式是为了简化体验、集中改进 GPT-Live。按官方帮助中心说明,过渡期内仍可继续用旧模式;12 月 11 日起设置里不再能选择两种旧语音,原先选了它们的用户会被默认切到 Live voice。实时视频和屏幕共享在 GPT-Live 具备该能力前仍由 Advanced voice 支撑,自定义 GPT 的语音也沿用 Advanced,直到自定义 GPT 同日退役。

核心要点速览

  • 时间线:11 月 10 日通知用户,过渡期可继续使用旧模式,12 月 11 日起无法在 Settings > Voice 中选择 Advanced 或 Standard,自动切到 Live voice
  • 官方口径:GPT-Live 自 7 月上线以来,ChatGPT 语音使用量接近翻倍,几乎所有语音用户都已在用 GPT-Live(未给出具体人数)
  • 三代架构:Standard 串联 3 个模型(语音转文字、LLM、文字转语音),Advanced 是轮流说话的原生音频模型,GPT-Live 是能边听边说的全双工模型
  • 例外:实时视频和屏幕共享在 GPT-Live 支持前继续由 Advanced 驱动;自定义 GPT 的语音沿用 Advanced,直到自定义 GPT 于 12 月 11 日退役(FedRAMP 及获批延期的企业工作区为 2027 年 2 月 11 日)
  • 历史对话保留在 ChatGPT 记录中,可继续用文字或语音接着聊;本次公告未公布新的跑分,也未提及 API 端点变化
阅读全文
关联模型 / 智能体 / 厂商:

前苹果研究员创办的 Nuance Labs 发布全双工音视频基础模型 Nuplex 1.0 与首个 AI 形象 Emma:边听边用表情回应,官方口径回复时机与真人重合 89%,Beta API 同步开放

西雅图初创公司 Nuance Labs 11 月 9 日发布 Nuplex 1.0(Nuance Full-duplex),一个能同时“听”和“说”的全双工音视频基础模型,以及基于它的第一个 AI 形象 Emma。Emma 在用户说话时就会点头、微笑、用视线示意轮到谁说话,而不是等对方说完才回应。官方在 1,785 个取自真实对话录音的问题上测试:Nuplex 的回复时机与原对话中真人的回复时机重合 89%,第二名系统只有 35%。Emma 免注册即可在浏览器视频聊天,Nuplex Beta API 也已开放,但官方有意做了很多限制:不能克隆真人、视频带水印、仅英语、仅限 18 岁以上,医疗和未成年人场景暂不开放。

前苹果研究员创办的 Nuance Labs 发布全双工音视频基础模型 Nuplex 1.0 与首个 AI 形象 Emma:边听边用表情回应,官方口径回复时机与真人重合 89%,Beta API 同步开放

核心要点速览

  • 官方口径:在 1,785 个真实对话问题上,Nuplex 回复时机与真人重合 89%,第二名系统为 35%;对比对象包括 PersonaPlex、Moshi、GPT-Live、Gemini Live
  • 研发 18 个月;Emma 的脸和声音授权自一名真人演员,由演员参与录制真实的倾听、反应和说话方式,而不是生成“平均脸”
  • Nuplex Beta API 可用自己的 prompt 设定人设,并在通话中把长任务交给开发者的工具在后台执行;Beta 期间语言模型由官方托管
  • 限制:不能上传人脸或声音、不能克隆真人,API 视频带可见水印;仅英语、仅 18 岁以上,医疗和未成年人场景暂不开放
  • 开放地区:美国(科罗拉多、康涅狄格、伊利诺伊、得克萨斯除外)、欧盟、英国、加拿大(魁北克除外)
阅读全文
关联模型 / 智能体 / 厂商:

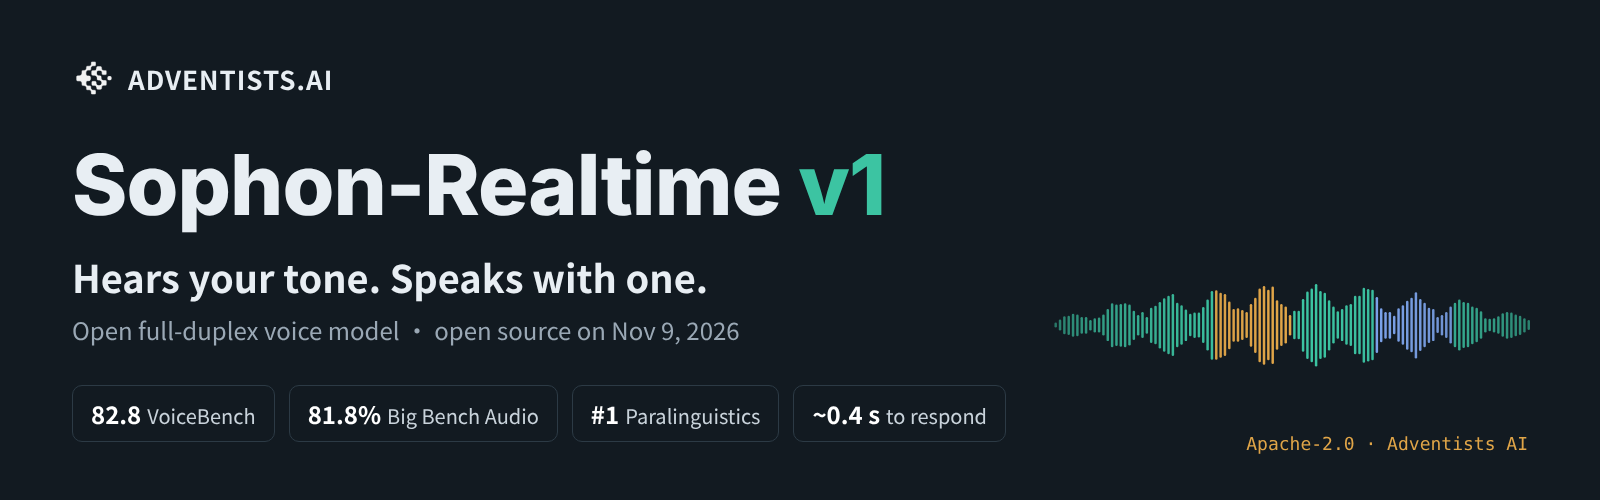
Adventists AI 开源全双工语音模型 Sophon-Realtime v1:32B「大脑」配三种发声版本,VoiceBench 82.8 与 GPT-4o-mini-Audio 持平,单张 80GB GPU 可跑,Apache 2.0

11 月 8 日,团队 Adventists AI 在 GitHub、Hugging Face、ModelScope 和 PyPI 发布 Sophon-Realtime v1 全双工语音模型家族,代码和权重均为 Apache 2.0、可商用。三个版本共用一个 32B「大脑」(基于 Qwen3-VL-32B-Instruct 改造),负责边听边判断轮次并写回复,区别只在发声方式:推荐的 Tag 版表现力最强,Flash 版首包音频 0.31 秒、单卡最多 40 路并发,E2E 版为研究预览、需两张 80GB GPU。厂商口径 VoiceBench 82.8、Big Bench Audio 81.8%,在开源全双工模型中排第一;跑分均为团队自测。

Adventists AI 开源全双工语音模型 Sophon-Realtime v1:32B「大脑」配三种发声版本,VoiceBench 82.8 与 GPT-4o-mini-Audio 持平,单张 80GB GPU 可跑,Apache 2.0

核心要点速览

  • 跑分(厂商口径,团队自测,见 GitHub README):VoiceBench 82.8、Big Bench Audio 81.8%,开源全双工模型第一,VoiceBench 与 GPT-4o-mini-Audio 持平
  • 听语气:副语言理解综合 48.6,高于 Gemini 3.8 Flash(46.9)和 Qwen3-Omni(44.6);Full-Duplex-Bench v3 工具调用 Pass@1 48%,高于 Grok 的 43%
  • 三个版本:Tag 首包约 0.6 秒、单卡 16 路;Flash 首包 0.31 秒、单卡 40 路;E2E 约 1 秒、需 2 张 80GB GPU(H100 实测,厂商口径)
  • 上手:pip install sophon-realtime 后 sophon-realtime serve,首次自动下载约 42GB 的 Tag 权重,在 8000 端口提供 OpenAI Realtime 风格的 WebSocket 接口(见 PyPI)
  • 许可与底座:代码和权重 Apache 2.0;Tag 的思考模型源自 Qwen3-VL-32B-Instruct 并量化为 FP8,发声模型源自 Fun-CosyVoice3-0.5B(见 Hugging Face)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Sophon-Realtime-32B-Tag⚡ Sophon-Realtime-32B-Flash⚡ Sophon-Realtime-32B-E2E⚡ Qwen3-VL-32B-Instruct⚡ GPT-4o-mini-Audio🌐 Adventists AI
AD赞助内容

Boson AI 发布 Higgs Realtime Duplex:45B MoE 全双工多模态交互模型,边听边看边说并在后台调工具,API 候补中

Boson AI(李沐、Alex Smola 团队)于 2026-11-05 发布研究预览 Higgs Realtime Duplex:一个 45B MoE 前台模型,把语音、视频、工具结果都切成 160ms 分块同时收发,可边听边看边说、实时渲染自己的脸,同时思考、调用工具或把难题委派给更大的后端模型而不中断对话。官方口径 Big Bench Audio 98.9、τ-Voice 69.8、Full-Duplex-Bench v1.5 75.5。目前 API 仅开放候补名单,旧版 Higgs Realtime 已可用。

Boson AI 发布 Higgs Realtime Duplex:45B MoE 全双工多模态交互模型,边听边看边说并在后台调工具,API 候补中

核心要点速览

  • 形态:45B MoE 前台模型,在约 2 万亿 token 文本/音频/视频上继续训练;所有流按 160ms 分块,静音也算一块
  • 后台干活:边说话边思考、异步调工具,难题带完整上下文委派给更大的后端模型(官方建议用前沿模型)
  • 官方口径跑分:Big Bench Audio 98.9(表内最高)、IFEval 94.1、τ-Voice 69.8(GPT-Live-1 约 74.5)、Full-Duplex-Bench v1.5 75.5(GPT-Live-1 80.1、TML 77.8)
  • 成本设计:音视频流约 2.6K tokens/分钟,含思考与工具约 2.6–5K;目标是 1 小时对话成本不超过人工 1 小时的 1/10
  • 可用性:Duplex API 仅候补名单;声音与人脸可用参考音频/单张图零样本替换
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Higgs Realtime Duplex⚡ Higgs Realtime⚡ GPT-Live-1⚡ TML Interaction Small🌐 Boson AI

Block 发布 Dessa:只用人类对话语音从零训练的全双工语音模型,可在 MacBook Pro M4 Max 本地实时运行

2026-10-23(UTC 16:53,SGT 10-24 00:53),Block 官方账号 @blocks 发布 Dessa,Jack Dorsey 随后转发称其为「迄今最真实的全双工语音模型」。官方页面 block.xyz/dessa 介绍:Dessa 是真正的语音到语音模型,训练数据只有人类对话录音,不用文本、不用任何预训练模型;全双工,能边听边说,会自然插话和附和(“yeah!”“got it!”),推理快于实时,可在 MacBook Pro M4 Max 或更高配置上本地运行。官方称只用一套 NVIDIA GB200 NVL72 完成训练,学习语言所需的词量比 LLM 少数百倍。目前没有公开 API 或权重,只向一小批 AI 安全研究者开放早期访问。

Block 发布 Dessa:只用人类对话语音从零训练的全双工语音模型,可在 MacBook Pro M4 Max 本地实时运行

核心要点速览

  • 训练数据只有人类对话语音:无文本、无预训练模型,从零训练(官方页面)
  • 全双工语音到语音:边听边说,会插话、附和,能直接听出并表达情绪、讽刺、笑声
  • 推理快于实时,可在 MacBook Pro M4 Max 或更高配置上本地运行
  • 官方称训练只用了一套 NVIDIA GB200 NVL72,学语言所需词量比 LLM 少数百倍
  • 暂无公开 API、权重或第三方跑分;目前只向少量 AI 安全研究者开放早期访问
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Dessa🌐 Block

OpenAI 发布 GPT-Live-1.1 与 GPT-Live-1.1 Quip:ChatGPT、Codex、dots 语音默认模型升级,新增 6 种语言音色,API 即将开放

OpenAI 于 10 月 15 日推出全双工语音模型 GPT-Live-1.1(接替 GPT-Live-1)与小模型 GPT-Live-1.1 Quip(接替 GPT-Live-1 mini),成为 Plus 及以上用户在 ChatGPT Voice、Codex、dots 中的默认语音模型;新增法、德、印地、日、韩、墨西哥西语音色,减少搜索时的「checking...」提示,面向全部用户灰度,API 即将上线。系统卡披露合成安全评测在 4 个类别有统计显著回退。

OpenAI 发布 GPT-Live-1.1 与 GPT-Live-1.1 Quip:ChatGPT、Codex、dots 语音默认模型升级,新增 6 种语言音色,API 即将开放

核心要点速览

  • 两档模型:GPT-Live-1.1 接替 GPT-Live-1,GPT-Live-1.1 Quip 接替 GPT-Live-1 mini;Plus 及以上(含 Codex 与 dots)默认 1.1,其余用户默认 Quip
  • 新增 6 种语言 Live 音色(法/德/印地/日/韩/墨西哥西语)+ 英文新音色 Bubbie,搜索时改用更多样的短句提示
  • 全双工架构:边听边说,可处理停顿、打断与语速变化;系统卡称 GPT-Live 实为「双模型系统」,难题委派给思考模型
  • 官方系统卡:真实生产语音评测与前代持平;合成评测在色情、心理健康、情感依赖、血腥 4 类出现统计显著回退
  • 今日起面向全部用户灰度,API「即将推出」,目前未公布 API 价格、模型 ID 或延迟/WER 指标
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GPT-Live-1.1⚡ GPT-Live-1.1 Quip⚡ GPT-Live-1🤖 Codex🤖 ChatGPT dots🌐 OpenAI

彻底告别单线程阻塞!异步大模型智能体框架开源:协程化推理与重叠状态共享,Qwen 3.x 零微调通吃并发流式交互

当前绝大多数大模型智能体均局限于“读输入 $\to$ 思考 $\to$ 回复/调工具 $\to$ 阻塞等待”的串行周期循环。然而在现实世界中,语音双工通话、具身机器人感知与系统级日志监控等真实场景均是高并发的非串行事件流:智能体在深入思考或执行耗时任务时,外部环境仍在持续产生新输入与中断事件。由独立 AI 研究团队推出的全新异步大模型智能体运行时框架打破了这一阻塞锁死困局:通过将大模型推理泛化为带有重叠内存状态的“推理协程”(Inference Coroutines),赋予智能体真正的非阻塞并发调度与异步事件监听能力。令人振奋的是,研究证实主流的开源 Qwen 3.x 系列模型无需任何任务专有微调,即可在零样本下通过协程机制从容应对长视频流式解析、实时电子游戏交互与系统并发监控等多源复杂任务,为下一代实时全自主 Agent 拓宽了底层边界。

彻底告别单线程阻塞!异步大模型智能体框架开源:协程化推理与重叠状态共享,Qwen 3.x 零微调通吃并发流式交互

核心要点速览

  • 单线程阻塞向非阻塞协程跃迁:首个将现代语言模型执行流抽象为带内存共享状态的异步协程运行时,彻底破除“一次只能做一件事”的串行智能体瓶颈。
  • 开源基座无需微调的原生并发力:实测 Qwen 3.x 系列在未进行任何任务专项微调的前提下,天然具备理解并协调多协程并发状态的能力,零成本解锁流式并发。
  • 覆盖音视频流、实时博弈与系统监控:在流式视频多目标跟踪、高频游戏交互以及高负载系统异常监控等真实非阻塞场景中,展现出毫秒级的中断响应与并发稳态。
阅读全文
关联模型 / 智能体 / 厂商:

Artificial Analysis:GPT-Live-1(Astra)登顶 Speech to Speech Index,得分 81.5

Artificial Analysis(@ArtificialAnlys)公布 Speech to Speech Index:OpenAI GPT-Live-1 在委托后端为 Astra(medium)时以 81.5 分登顶,Sol(low)为 80.1 排第 3,夹在中间的是 Grok Voice Think Fast 2.0 High(81.3)。GPT-Live-1 为全双工语音模型,可在对话中把推理与工具调用委托给后端文本模型;同批评测还覆盖 Speech Agent Arena、Tau Voice、Big Bench Audio 与成本/首音延迟。

核心要点速览

  • GPT-Live-1(Astra medium)Speech to Speech Index 81.5 登顶;Sol low 80.1 排第 3。
  • Tau Voice 智能体榜:Astra medium 67.9%、Sol low 59.3%,分列前两名。
  • 成本约 $5.83/$4.47 每小时输入音频(含后端);首音延迟约 1.34s/1.24s,慢于 Grok Voice 0.70s。
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI:GPT-Live-1 上线 API——全双工语音智能体可边听边说,自选模型与 harness

OpenAI 开发者账号宣布 GPT-Live-1 已在 API 可用:把 ChatGPT 的自然来回对话带进应用,语音智能体可在说话时继续聆听,并搭配你选择的模型与 harness。OpenAI 工程师 Tibo 亦确认可基于同一套已服务约 10 亿 ChatGPT 用户的语音系统做全双工工具调用应用。

核心要点速览

  • GPT-Live-1 已在 OpenAI API 上线,面向可打断的全双工语音智能体。
  • 支持边听边说,并可自选底层模型与 harness。
  • 与 ChatGPT 同款语音栈对齐,适合工具调用型语音应用。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GPT Live 1🌐 OpenAI
AD赞助内容