AI 编程实时动态与要闻

开源 Agent 基础模型 Axion 1.0 发布:2 次 SFT + RL 极简配方,35B(3B 激活)复现权重 Apache 2.0 开放,数据与训练代码全公开

arXiv 论文 2611.03233(Yuqi Jia、Yunjie Tian 等 7 位作者)发布 Axion 1.0,一个“权重之外也开源”的 Agent 基础模型:只用两段轻量 SFT 加强化学习,不做专门的 mid-training、DPO 或在线蒸馏,总共约 1.8 万条 SFT 轨迹。训练代码托管在 GitHub 的 bytedance 组织下,训练数据和 Axion 1.0-35B 复现权重(Qwen3.6-35B-A3B 底座,35B 总参 / 3B 激活,Apache 2.0)已上 Hugging Face;论文中的 122B 版本权重标注为即将发布。

开源 Agent 基础模型 Axion 1.0 发布:2 次 SFT + RL 极简配方,35B(3B 激活)复现权重 Apache 2.0 开放,数据与训练代码全公开

核心要点速览

  • 配方极简:SFT 一阶段练自包含科学推理,二阶段练工具调用和信息检索,再用 RL 打磨长程交互,共约 18,363 条 SFT 轨迹 + 484 条 RL 任务
  • 开源范围包括数据构建、生成、过滤、验证、提示词和训练代码(GitHub),不只是权重
  • 35B 复现权重成绩:HLE 52.8、SEAL-0 60.4、FrontierScience Olympiad 85.0、Research 55.0(HF 模型页)
  • 论文版 122B 在 HLE(限制网站访问)59.0、FrontierScience Research 66.7;122B 权重尚未放出
  • 跑分均为作者自报,HF 页上 Claude Opus 5 的 HLE 为 63.6,Axion 仍落后最强闭源模型
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Axion 1.0-35B⚡ Axion 1.0-122B⚡ Qwen3.6-35B-A3B🌐 ByteDance🌐 Hugging Face

Artificial Analysis 把六大职业能力指数升级到 v2.0:加重“不幻觉”和 Agent 工具调用权重,Claude Opus 5.5 六项全部第一

独立评测机构 Artificial Analysis 11 月 4 日在 X 上宣布,把金融会计、战略运营、法律、医疗、工程、经济六个 Capability Indexes 升级到 v2.0,与 Intelligence Index v5.0 的评测对齐,并更重视 Non-Hallucination(不编造)和 Agentic Tool Use。各指数统一把 HLE 换成 HLE-Diamond、AA-Omniscience 升到 v1.1,并移除 GDPval-AA;工程指数新增 Science 能力项。官方结果:Claude Opus 5.5 (max) 六项全部领先,GPT-6 Astra (max) 在金融会计、法律、工程排第二;开放权重阵营中 Kimi K3.1 Pro(权重尚未发布)六项都领先,排在第 5 到第 8 名。

Artificial Analysis 把六大职业能力指数升级到 v2.0:加重“不幻觉”和 Agent 工具调用权重,Claude Opus 5.5 六项全部第一

核心要点速览

  • 六个指数把 O*NET 职业任务映射到对应 benchmark,按能力在该职业中出现的频率加权(方法论页)
  • 通用改动:HLE 升为 HLE-Diamond,AA-Omniscience 升为 v1.1,各指数的 Agentic Knowledge Work 都去掉 GDPval-AA(改由 AA-Briefcase v1.1 承担)
  • 金融会计与法律指数中 Non-Hallucination 权重升到 15%;战略运营指数 Agentic Tool Use(AutomationBench-AA)升到 35%,为单项最高
  • 工程指数新增 Science(20%,CritPt v2 Hard Subset + Terminal-Bench-Science 0.1),Agentic Coding 加入 FrontierCode 2.0;经济指数用 GDP.pdf 取代 AA-LCR
  • 官方结果:Claude Opus 5.5 (max) 六项第一;开放权重中 Kimi K3.1 Pro 六项领先,MiniMax-M3.1-Flash 在战略运营(#10)、DeepSeek V4.1 Flash 1017 (max) 在医疗(#12)领先
阅读全文

X 热议:Sam Altman 称“人类应始终掌控未来”,不应把未来交给超级智能,这一要求最终应约束 AI 进展

OpenAI CEO Sam Altman(@sama)11 月 4 日 09:40(新加坡时间)在 X 发帖称“人类应始终掌控未来”,表示 OpenAI 反对让人类沦为只做“AI 系统认为值得奖励的事”的角色,并称人类不应把未来的控制权交给超级智能,“这一要求最终应当约束 AI 的进展”。帖子约 25 分钟内获得约 1,360 赞、337 条回复和近 10 万次浏览,François Chollet 等人表态支持,也有不少质疑。这是 Altman 本人的观点表态,不是 OpenAI 发布的新政策或产品。

核心要点速览

  • 互动量:发帖约 25 分钟内约 1,360 赞、337 条回复、89 次转发、74 条引用、约 9.9 万次浏览(X API 口径),回复数占比很高,说明争议大
  • 核心表述三句:人类应始终掌控未来;OpenAI 反对人类沦为做“AI 系统认为值得奖励之事”的角色;不应把未来交给超级智能,这一要求“最终应约束 AI 进展”
  • 支持方:François Chollet(@fchollet)转发称“Co-sign”,认为值得建设的未来是 AI 始终是人类手中的工具;Matthew Berman 称 Altman 上周接受他采访时也讲过同样观点
  • 质疑方:有人反问“由哪些人掌控”,有人认为“AI 系统根本不会思考”,也有人把它和 Altman 近期关于 RAM、算力集中在数据中心的言论对照
  • 帖子没有说明引号里那句话出自哪里,也没有给出任何具体政策或时间表;网上把它和 GPT-6.2 Astra 发布时间挂钩的说法均属猜测
阅读全文
关联模型 / 智能体 / 厂商:

Vercel Security Review 公测:每次 GitHub push 自动做漏洞审查,Vercel Agent 一键修复

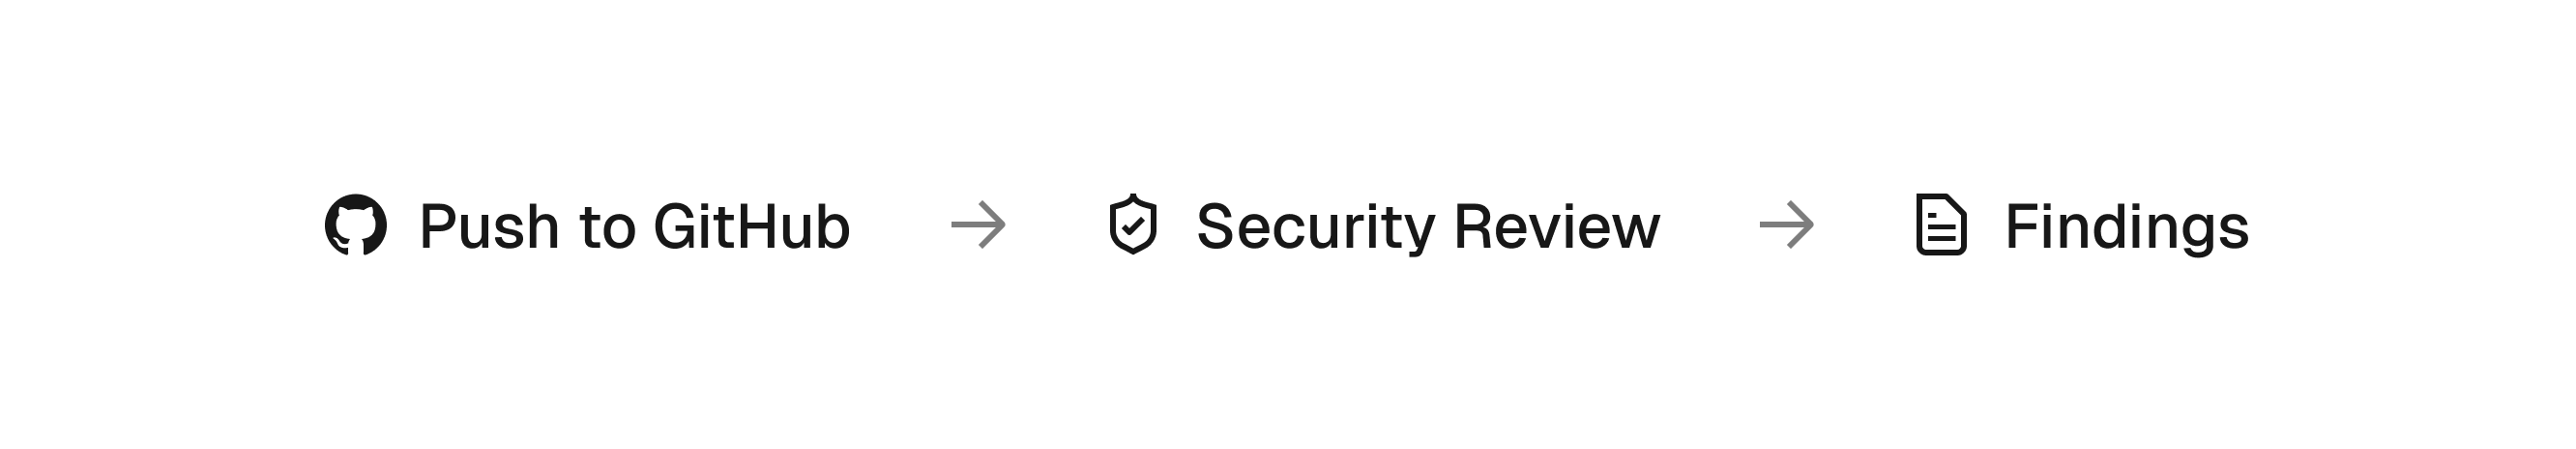
Vercel 于 11 月 3 日(美西时间)宣布 Security Review 公测。它是 Vercel Agent 的新能力,与 Code Review、Investigation 并列:开启后,团队关联的 GitHub 仓库每次 push 都会只针对改动的 diff 做漏洞审查,几秒内完成;发现的问题进入 Security 仪表盘、PR 评论和 CLI,可一键交给 Vercel Agent 修复,或用 vercel security vulnerabilities 拉给自己的编码 Agent。面向 Pro 与 Enterprise,11 月 10 日前审查免费。

Vercel Security Review 公测:每次 GitHub push 自动做漏洞审查,Vercel Agent 一键修复

核心要点速览

  • 触发方式:每次 GitHub push(含直接推生产分支)自动审查,只扫改动 diff,官方称“几秒内完成”,可覆盖每个 preview 与 production 部署
  • 不止模式匹配:Agent 会追踪改动代码的可达路径、检查已有防护并复核每条发现,官方举例可抓到“缺少授权校验”这类逻辑漏洞
  • 团队可用自然语言写安全策略,按项目或全团队生效,也可用 vercel security policy 管理
  • 计费:按 Vercel Agent 费率,模型 token 按供应商原价不加价,另加每百万 token 0.25 美元;审查在 2026 年 11 月 10 日前免费,Agent 修复照常计费
  • 可用范围:Pro 与 Enterprise 团队公测;官方未公布检出率或误报率等跑分
阅读全文
AD赞助内容

X 热议:Grok Bot 工程师 poteto 称让 Agent 做对抗式代码审查「大多是浪费 token」,主张把 token 花在实证加形式化验证上

11 月 3 日,自我介绍为 SpaceXSI 旗下 Grok Bot 工程师、React Compiler 核心团队成员(曾在 Cursor、Meta、Netflix)的 @poteto(lauren)发帖,自称「也许是暴论」:她现在认为对抗式审查大多是在浪费 token,不如把这些 token 用在实证验证结合形式化验证上;她已调整自己的 Agent 技能包 pstack,减少调用 interrogate(多模型对抗审查)技能,以后可能直接移除。她还说抽象层面的代码审查价值很小,Agent 往往陷在吹毛求疵和 YAGNI 式意见里。帖子约 90.6 万浏览、9227 赞、5538 收藏,属个人观点,引发对 AI 代码审查价值的讨论。

核心要点速览

  • 观点(个人看法,非官方结论):对抗式审查「大多是浪费 token」,更值得投入的是实证验证 + 形式化验证
  • 行动:作者称已让 pstack 少用 interrogate 技能,未来可能移除;抓取时 GitHub 上 cursor/plugins 的 pstack 公开目录自 10 月 27 日后尚无新提交,具体改动未见公开
  • interrogate 是什么:按公开 SKILL.md,它为每个配置模型各开一个只读审查者(默认 Claude Opus 5.5 xhigh 与 Grok 4.7 xhigh fast)对 diff 做对抗审查,再分为 Act on / Consider / Noted / Dismissed 四档,不自动改代码
  • 作者身份(据其 X 与 GitHub 简介):Grok Bot @ SpaceXSI 工程师、React Compiler 核心团队,曾在 Cursor、Meta、Netflix
  • 热度:约 90.6 万浏览、9227 赞、5538 收藏、668 回复、356 转发、210 引用
阅读全文

OpenAI 公布 ChatGPT 与 Codex 用于硬件工程的进展:GPT-6 Astra 一周内设计出 Codex 设备,携手 Mazda 做空气动力学研究

11 月 3 日,OpenAI 发布《Accelerating engineering for the physical world》,介绍其模型在机械设计、电子设计和仿真上的进展。两名员工用 GPT-6 Astra 在不到一周内设计出一台用来和 Codex 对话的设备(外壳、PCB、固件和软件),合同制造商不到一个月做出小批量原型,但量产前仍需多轮人工评审。OpenAI 硬件团队的模型 token 用量自 2 月以来增长 23 倍;在 BenchCAD 2.0 上,一个更新的内部模型平均得分 0.875,GPT-6 Astra 最高推理档为 0.594(官方口径)。OpenAI 还扩大与 Chip Ganassi Racing 的合作,并宣布与 Mazda 开展新的研究合作。

OpenAI 公布 ChatGPT 与 Codex 用于硬件工程的进展:GPT-6 Astra 一周内设计出 Codex 设备,携手 Mazda 做空气动力学研究

核心要点速览

  • GPT-6 Astra 在「无人工直接编辑」的测试里完成外观、外壳结构、元器件选型与 PCB 布局、UI 和固件;两名员工业余时间不到一周完成设计,原型不到一个月做出,见 OpenAI 博客。
  • 官方承认短板:Astra 没有稳定考虑制造商的产能限制、公差和装配细节,量产前仍需多轮评审迭代。
  • OpenAI 硬件与基础设施团队用 Codex/ChatGPT 做 CAD 建模、2D 工程图、仿真与 FEA、设计评审,token 用量自 2 月起增长 23 倍(官方口径)。
  • BenchCAD 2.0(重建 3D 零件与装配体、识别电路板连接):更新的内部模型 0.875,GPT-6 Astra 最高推理档 0.594(官方口径,内部模型未命名、未发布)。
  • 合作方:Chip Ganassi Racing 测试把 3D 扫描转成可编辑 CAD 和 2D 图纸;Mazda 与 OpenAI 研究团队用气流和结构仿真探索车型设计,结果「未来几个月」公布。
阅读全文

CrowdStrike 宣布收购 Fiddler 与 Dreadnode,并上线 AI Kill Switch:把智能体可观测、上线前攻防测试和一键终止都收进 Falcon

CrowdStrike 于 11 月 3 日在巴塞罗那 Fal.Con Europe 宣布签署最终协议,收购 AI 智能体可观测公司 Fiddler AI 和自动化 AI 安全测试公司 Dreadnode,同时在 Falcon Guardian 中上线 AI Kill Switch,可在智能体失控时终止进程、阻止重启并切断企业网络访问。两笔收购预计在 FY27 第四季度完成,对应产品同季度 GA。官方未披露价格;据 CyberScoop 转引《华尔街日报》,Fiddler 约 4 亿美元、Dreadnode 约 9500 万美元。

CrowdStrike 宣布收购 Fiddler 与 Dreadnode,并上线 AI Kill Switch:把智能体可观测、上线前攻防测试和一键终止都收进 Falcon

核心要点速览

  • 两笔收购同日宣布,均预计在 CrowdStrike FY27 第四季度完成,支付以现金为主,另含部分附归属条件的股票。
  • 据 CyberScoop 转引《华尔街日报》:Fiddler 约 4 亿美元、Dreadnode 约 9500 万美元,合计约 4.95 亿美元;CrowdStrike 官方未披露金额。
  • Fiddler 将以 Falcon Observe 名义销售:上线前评估、跨智能体层级的决策与工具调用追踪、漂移和幻觉检测,并称用专用模型可把评估成本最多降低 98%。
  • Dreadnode 内置 100 多种已知 AI 攻击策略(越狱、提示注入、多轮及智能体专用攻击),可测试模型、智能体推理循环、应用和 MCP 服务器,结果映射到 OWASP LLM Top 10、OWASP Agentic ASI01-ASI10、MITRE ATLAS 和 NIST AI RMF。
  • AI Kill Switch 今天即可使用:由授权管理员触发,先在网关层终止智能体(端点层即将支持),阻止重启并切断网络,全程写入审计日志。
阅读全文

X 热议:Claude Code 团队的 Addy Osmani 长文谈「认知投降」,提醒开发者在 Agent 干活时别交出批判性思考

X 简介为 Anthropic Claude Code 成员的 Addy Osmani(@addyosmani)11 月 3 日在 X 发布长文《Critical thinking when agents do the work》。他把人和 AI 的协作分成三档:认知卸载(把任务交给 AI 但自己对结果负责)、顺从(AI 输出直接变成你的输入)和「认知投降」(AI 的输出悄悄变成你的观点,你不再检查)。「认知投降」一词出自沃顿商学院的 Steven Shaw 和 Gideon Nave。他给出几条自检问题和验证习惯。发布约 3 小时内收获约 1400 赞、2400 次收藏、7 万多次浏览,并登上 X 热门。以下是作者观点,不是 Anthropic 官方公告。

核心要点速览

  • 三档光谱:认知卸载(委托但仍对结果负责,作者说他整天都这么做)、顺从(输出不再被当作假设)、认知投降(不再检查,直接当成自己的结论)。原文见 X 长文。
  • 作者的观点:模型越强,明显错误越少,输出「写得好、大体正确」,反而不再逼人看第二眼;同时跑多个 Agent,审阅的仍只有你一双眼睛。
  • 自检问题:提问前先写下自己的假设;分清是让 AI 帮你思考还是替你思考;想清楚「什么情况下它会错」并真的去测;让多个模型唱反调;能否当着维护者的面为结果下注。
  • 验证习惯:事先定义「验证通过」的标准(测试、截图、日志);绿灯只证明一个性质,要问它没证明什么;让 Claude Code 用全新上下文的子 Agent 自查,最后再问一句「我漏了什么?」。
  • 低风险的事可以完全交给 AI,代价落在别人身上的决定(要做什么、是否可以上线)要自己保留推理过程。
阅读全文
关联模型 / 智能体 / 厂商:

DeepSeek Harness 上线 Creator Mode:用一句话让 Agent 生成可用插件,官方放出 7 个演示 Prompt

DeepSeek 旗下开源 Agent 应用 DeepSeek Harness(MIT 协议)11 月 2 日在 X 官方账号发布 Creator Mode:用户用自然语言描述想要的插件,Agent 把它做成可直接使用的插件,演示包括 3D 地标馆、Transformer 3D 可视化、视频剪辑台和论文阅读器。官方同时在 cdn.deepseek.com 公开了 7 个中英双语演示 Prompt,并提醒部分插件经过多轮对话打磨,单条 Prompt 未必能完全复现视频效果。原帖约 2 万赞、169 万次浏览。官方未公布任何跑分。

DeepSeek Harness 上线 Creator Mode:用一句话让 Agent 生成可用插件,官方放出 7 个演示 Prompt

核心要点速览

  • Creator Mode:用自然语言描述想要的插件,Agent 生成可直接使用的插件,从设计工作台到沙盒游戏、3D LLM 可视化。
  • 官方公开 7 个演示 Prompt:3D 地标馆、Transformer 3D 演示、5 种界面风格切换、海报工作台、视频剪辑台、论文阅读器、会话 token 统计。
  • 入口已进入 v0.2.1-rc.5(10 月 30 日预发布):插件管理页新增「让 Agent 创建插件」,保留草稿进入创造模式。
  • GitHub 仓库 约 27 万星、MIT 协议;Harness 目前仍处于预览期。
  • 官方未公布任何跑分或成功率数据;原帖约 2 万赞、169 万次浏览。
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:DHH 称 Agent 时代对多数程序员是好事,但「难相处」的人将失去专业技能带来的豁免权

Ruby on Rails 作者、37signals CTO DHH(David Heinemeier Hansson)11 月 2 日在 X 上连发两帖:一是「Agent 的最大馈赠,是让你能绕开软件圈里每一个难缠的守门人」;二是「Agent 时代对大多数程序员会很棒,但对脾气古怪、难合作的人会是艰难时期,专业知识和稀有技能不再能让难相处的人免责,最好学点基本的人际技能」。第二帖约 4 小时内获约 3600 赞、10.6 万浏览、280 多条回复。这是个人观点,不是任何公司的公告。

核心要点速览

  • 这是 DHH 的个人观点帖,不是 37signals 或任何 AI 公司的官方表态,也没有附带数据或研究。
  • 主帖(2026-11-02 13:03 UTC)抓取时约 3609 赞、180 转发、282 回复、60 引用、10.6 万浏览、400 次收藏。
  • 约 1.5 小时前的前置帖「Agent 让你绕开每一个难缠的守门人」(11:41 UTC)约 2831 赞、131 转发、8 万浏览。
  • 支持方:技术分析作者 Ben Dickson(@bendee983)引用称,以前优秀工程师可以「难相处也没事」,AI 正在拉平差距,但仍需要扎实的工程知识。
  • 反方和补充:有人调侃难相处的人反而找到了「永远不会回嘴的同事」;也有人认为 Agent 只会干活,不会让你更好合作,「好合作」的价值反而更高。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

半导体与 AI 研究机构 SemiAnalysis 11 月 2 日发布 GDPx,用来衡量前沿模型在芯片设计、网络安全、生物、金融、法律、量化交易、递归自我改进(RSI)、硬件设计、材料科学、对齐和软件工程 11 个领域的智能体能力,共 206 道任务,由 14 家专业数据公司出题、SemiAnalysis 负责最终质检。官网榜单上 Claude Opus 5.5 以 12.0% 居首,Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6% 紧随其后;金融和法律任务几乎所有模型都是 0 分。SemiAnalysis 称 Opus 5.5 和 GPT-6 Astra 的总分被安全分类器拖低,并计划每 3–6 个月更新一版。以上分数均为 SemiAnalysis 口径。

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

核心要点速览

  • 规模:11 个领域、14 家数据合作方、206 道任务,默认单题时限 8 小时(GDPx 官网)
  • 榜单(SemiAnalysis 口径):Claude Opus 5.5 12.0%、Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6%、Muse Wonder Full 9.0%、Claude Fable 5.1 8.5%、GPT 6.1 Sol 8.4%、Claude Sonnet 5.5 8.2%
  • 开源与低价档:DeepSeek 4.1 Flash 1017 5.4%、GPT-6 Luna 5.1%、Grok 4.7 3.9%、GLM 5.3 2.7%;金融和法律任务几乎全部 0 分
  • 评测方法:优先用各家原生 harness(Opus 用 Claude Code、Astra 用 Codex、Carbon 用 Antigravity),没有的用 OpenCode;报告 3 次尝试的 pass@1,各领域等权(SemiAnalysis 博客)
  • 分领域:Opus 5.5 赢量化、硬件和芯片设计;Gemini 4 Carbon 赢生物和软件工程;GPT-6 Astra 赢 RSI 和材料科学;Muse Wonder Full 是最强网安模型
阅读全文

X 热议:FT 首席数据记者 Burn-Murdoch 称美国生产率上升「不像 AI 带来的」,主要是科技裁员;Gavin Baker 反驳称看到了「AI 回报」

11 月 1 日,《金融时报》专栏作者兼首席数据记者 John Burn-Murdoch 在 X 发布长串推文并附 FT 文章,认为美国 AI 采用行业的生产率上升始于 2020 年、早于 AI 智能体,而且只在美国出现,主要来自科技公司裁员和招聘收缩,而不是 AI。该串首帖约 1,344 赞、306 转发、18.6 万浏览。Atreides Management 管理合伙人兼 CIO Gavin Baker 引用 FT 图表回应,称很难不从中看到「AI 回报」的证据,并引用 a16z 与 EPB Research 的数据,该帖约 793 赞、10.2 万浏览。Burn-Murdoch 随后回复说自己「有点拿不准」,承认数据无法排除 AI 的作用。这是对同一组数据的两种解读,不是定论。

X 热议:FT 首席数据记者 Burn-Murdoch 称美国生产率上升「不像 AI 带来的」,主要是科技裁员;Gavin Baker 反驳称看到了「AI 回报」

核心要点速览

  • 首帖:John Burn-Murdoch 的推文串,发布于 2026-11-01 15:04 UTC,约 1,344 赞、306 转发、18.6 万浏览;他的 X 简介写明是 FT 专栏作者兼首席数据记者
  • Burn-Murdoch 的核心论点:美国 AI 采用行业的生产率上升从 2020 年就开始了,2022 年的再加速也太早,「当时还是聊天机器人,不是智能体」;而且其他高收入国家同样大量用 AI,却没有出现同样的上升
  • 他把生产率拆成产出和人数两部分后认为:2022 年起的美国加速主要是科技公司裁员,产出基本在趋势线上,人数却下降了
  • 反方:Gavin Baker 的回应,约 793 赞、10.2 万浏览;他引用 EPB Research 数据称 AI 采用最深的 3 个行业生产率增速从 2.2% 升到 5%,并说美国贡献了 Anthropic 72% 的收入(均为他引用的第三方或厂商口径,本站未独立核实)
  • Burn-Murdoch 回复 Baker 时说自己「有点拿不准」:「看起来像 AI」的说法被夸大了,但数据也不能排除 AI 的作用
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Scott Alexander 发文《Against SURA》批评「单方面停下 + 唤起关注」路线,AI 安全圈被指越来越像群众政治运动

Scott Alexander 10 月 31 日在 LessWrong 发表长文《Against SURA》,把「公司、员工、国家应单方面停下 AI 并唤起公众关注」的主张统称为 SURA,认为它会让不重视对齐的公司领先、让美国失去与中国谈判的筹码。他引用 AI Futures Project 成员对几种「没有全球暂停」情景的生存概率估计,大多在 25%–50%,以此反驳 90% 以上的末日概率。博主 jessicat 转引后称,AI 安全的部分派别已开始像群众政治运动,认知质量变差(约 359 赞、6.3 万浏览);Bloomberg Odd Lots 主持人 Joe Weisenthal 转发概括为「大家在比谁更悲观」(约 287 赞、3.8 万浏览)。这是观点争论,不是任何机构的政策公告。

X 热议:Scott Alexander 发文《Against SURA》批评「单方面停下 + 唤起关注」路线,AI 安全圈被指越来越像群众政治运动

核心要点速览

  • 原文:Scott Alexander 在 LessWrong 发表的《Against SURA》,发布于 2026-10-31 19:32 UTC;SURA 指 Stop Unilaterally + Raise Awareness(单方面停下 + 唤起关注)
  • 文中引用的 AI Futures Project 成员对三种「无全球暂停」情景(C+ / C / D)的生存概率估计:Daniel Kokotajlo 40%/20%/10%,Ryan Greenblatt 60%/63%/55%,Eli Lifland 50%/45%/32%,Thomas Larsen 45%/35%/20%,Romeo Dean 40%/35%/20%;AI 预测器 FutureSearch 给出 44%
  • 他举例称,若美国单方面通过 Sanders 的《Ban Artificial Superintelligence Act》(MIRI 背书),他用的 AI 预测器估计中国一年内同意暂停的概率只会从 1% 升到 7%
  • jessicat 的转引帖(10-31 23:01 UTC)约 359 赞、28 转发、6.3 万浏览;Joe Weisenthal 的转发(11-01 14:57 UTC)约 287 赞、33 回复、3.8 万浏览
  • 注意:Weisenthal 帖中「10%–40%」是他的概括,原文表格的估计范围是 10%–63%
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Shopify CEO Tobi Lütke 力挺 monorepo,公司工程师称单一代码库对编程智能体「是一大利好」,反方坚持拆仓

Shopify 杰出工程师 Burke Libbey 11 月 1 日发帖称,迁到 monorepo(单一代码库)对 Shopify 内部的智能体「是一大利好」,虽然需要配套工具、也有要花力气缓解的缺点,但他「不会回头」。这条帖子回应的是 Darren Shepherd 前一天的观点:他讨厌「monorepo 适合智能体」的说法。Shopify CEO Tobi Lütke 随后引用并讲述 Mikhail Parakhin 当年的话:每个工程师都讨厌迁 monorepo,但迁完后没人愿意去不用它的公司。Tobi 的帖子约 1,115 赞、454 收藏、8.9 万浏览,引发大量讨论。这是从业者观点,不是官方技术公告。

核心要点速览

  • 原帖:@tobi 11 月 1 日,15:39 UTC 发布,约 1,115 赞、454 收藏、95 条回复、8.9 万浏览(抓取时)
  • Shopify 杰出工程师 Burke Libbey 原话:迁 monorepo 对 Shopify 的智能体是一大利好,需要用心做工具、缺点要花力气缓解,但「不会回头」
  • 反方 Darren Shepherd(Rancher / k3s 背景)10 月 31 日发帖:讨厌「monorepo 适合智能体」的说法,认为最好的扩展方式是避免扩展
  • Mikhail Parakhin 回应 Tobi 的转述:「有了智能体,这话比以往更对」
  • 引用帖中支持方的核心理由是智能体能一次看到所有调用方、做跨栈类型检查和原子改动;也有人质疑在智能体时代是否更该保留独立演化的小仓库
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Flask 作者 Armin Ronacher 称 Opus 5.5 智能体两周内可无人工重写整个 CPython,评论区争论「价值到底在不在测试集」

Flask 作者 Armin Ronacher(@mitsuhiko)11 月 1 日发帖称,他确信现在用一个 Opus 5.5 智能体,只对着测试集、无人工介入,大约两周就能重写整个 CPython,甚至做到 ABI 兼容、去掉 GIL、带 JIT 并在各项指标上更快。帖子约 1,637 赞、9.8 万浏览、162 条回复。随后他补充:重写不一定需要现成测试集,让智能体先自建测试更适合移植。antirez 表示赞同,Mario Zechner 和 Meta 工程师 Kevin Newton 则提出反对。这是个人判断,并无实际重写结果。

核心要点速览

  • 原帖:@mitsuhiko 11 月 1 日,11:52 UTC 发布,约 1,637 赞、269 收藏、162 条回复、9.8 万浏览(抓取时)
  • 他的原话要点:只给测试集、无人工输入,约两周重写 CPython,「可能」做到含 ABI 的完全兼容、无 GIL、带 JIT,并称「完全疯狂」;这是预测,没有给出实验
  • 后续帖(14:07 UTC,约 212 赞):不必依赖现成测试集,很多旧测试不适合「爬坡」优化;他说几周前让智能体重写 Excel 公式引擎时,测试集是它从零自建的
  • antirez(Redis 作者)赞同先让智能体建一套庞大的测试再开始移植;Mario Zechner 反对,认为问题在信任,现成的测试和一致性套件才让他放心
  • Meta 工程师 Kevin Newton 批评:成功的 Python JIT 极少,难在复杂度和兼容性,认为「无需人工就能做出好 JIT」是错误的;也有人指出 PEP 703 下无 GIL 构建本就与标准 ABI 不兼容
阅读全文
关联模型 / 智能体 / 厂商: