AI 编程实时动态与要闻

谷歌云推出 Gemini for healthcare 预览版:把 Gemini agent 接进医院与医保,27 个连接器覆盖 Epic、Oracle Health 等病历系统(只读),支持 HIPAA 合规

谷歌云 CEO Thomas Kurian 11 月 10 日宣布 Gemini for healthcare,即日起在美国以预览版提供。它把 10 月 Gemini at Work 上发布的通用 Gemini agent 扩展到医疗机构和医保方,由医疗技能、系统连接器、合作伙伴生态和统一治理平台四部分组成:可汇总跨院病历、诊前备好病历摘要、按保险政策整理预授权材料并起草申诉,也能帮医保方按医疗政策审核请求、解释自付费用。官方称平台支持 HIPAA 合规,临床数据不会用于训练谷歌的基础模型。
谷歌云推出 Gemini for healthcare 预览版:把 Gemini agent 接进医院与医保,27 个连接器覆盖 Epic、Oracle Health 等病历系统(只读),支持 HIPAA 合规

核心要点速览

  • 上线状态:美国预览版,即日起可用;与已有的法律、金融服务、政府服务行业方案并列(官方博客)
  • 连接器:官方列出 27 个,覆盖病历、资格与理赔、术语编码、医保政策、临床指南、办公协作和安全;Epic、Oracle Health 病历均为只读,不回写病历
  • 痛点数据:官方称临床人员每周约 28 小时花在手工核对分散的信息上(官方口径)
  • MCP 接入:InterSystems 提供 FHIR MCP Server,Keragon 用单个 MCP 集成连接 400+ 款医疗应用
  • 生态:16 家系统集成商(埃森哲、德勤、毕马威、普华永道、TCS 等)参与落地;支持多模型路由,简单行政步骤可交给低成本模型
阅读全文

Meta 三款 Muse 模型上架谷歌云:Muse Wonder、Muse Spark 1.3 与新发布的 Muse Ember 以 Preview 形式进入 Model Garden,走全局 OpenAI 兼容 Responses 接口

Meta CEO 扎克伯格 11 月 10 日(新加坡时间 05:49)宣布 Muse Ember、Muse Spark 1.3 和 Muse Wonder 已上架 Google Cloud,Sundar Pichai 回复「欢迎加入 Model Garden」。谷歌官方文档显示,三款模型以 Preview 合作伙伴模型形式提供,只支持 global 端点和无状态的 OpenAI 兼容 Responses API。谷歌页面未列出单价,Meta 自家价目表仍是参考。

核心要点速览

  • 上架范围:3 款模型,Muse Wonder 1.0、Muse Spark 1.3、Muse Ember 1.0,在谷歌合作伙伴模型列表中均标为 Preview(Google Cloud 文档)
  • 调用方式:只有 global 一个端点,走无状态的 OpenAI 兼容 Responses API,store: true 不支持;model 字段直接填 muse-wonder-1.0 / muse-ember-1.0 / muse-spark-1.3
  • 定价参考(Meta 官方价目,谷歌页面未列单价):Wonder $4 / $20,Spark 1.3 $1.25 / $4.25,Ember $0.10 / $0.50(每百万输入/输出 token)
  • 官方定位:Wonder 做长程编程与 Agent 规划,Ember 负责高频工具调用、路由和抽取,谷歌文档建议 Ember 与 Wonder 或 Spark 1.3 搭配;Spark 1.3 支持 MCP 与 1M 上下文
  • 扎克伯格原帖获 5300+ 赞、约 25 万次浏览;Sundar Pichai 回复「欢迎加入 Model Garden」获 2100+ 赞;LiteLLM 已有 PR #50768 接入
阅读全文
关联模型 / 智能体 / 厂商:

Google AI Studio 接入 Google Maps Platform:一句话生成地图应用,一键开通免信用卡的 Maps Demo Key,每个 API 每天 100 次免费调用

Google 11 月 9 日宣布,开发者可以直接在 Google AI Studio 里用 Google Maps Platform 构建应用。用户描述想法(比如“做一个纽约地标 3D 导览”),AI Studio 检测到地图需求后会弹出“Set up Google Maps Platform”卡片,一键开通 Maps Demo Key 并自动存进应用的密钥设置,预览区直接加载可交互地图。Demo Key 不需要信用卡和计费账号,每个 API 每天 100 次调用;要上线时绑定 Google Cloud 计费账号即可切到正式配额。新用户可用地图、地点、路线、天气、空气质量、3D 航拍等大部分 API,已有 Google Cloud 项目的用户免费原型阶段只开放常用子集。

Google AI Studio 接入 Google Maps Platform:一句话生成地图应用,一键开通免信用卡的 Maps Demo Key,每个 API 每天 100 次免费调用

核心要点速览

  • 免费额度:Maps Demo Key 每个 API 每天 100 次调用,24 小时重置,无需信用卡和 Google Cloud 计费账号
  • 新用户可用除 Route Optimization、Solar、Nav Connect 外的 全部 Maps Platform API,包括 Maps JavaScript、Places、Routes、Geocoding、天气、空气质量、花粉、Aerial View 和 Maps Experience Agent 工具
  • 已有 Google Cloud 用户免费原型阶段只开放 常用子集(Places 不含照片和评论等用户内容),或直接连接已计费项目获得 100% API 和正式配额
  • 密钥自动写入应用 secrets,名为 GOOGLE_MAPS_PLATFORM_KEY;上线时给项目绑定计费账号,原密钥继续可用
  • Google 同时发布 Codelab,演示在 AI Studio Build 模式生成地图应用并部署到 Cloud Run
阅读全文
关联模型 / 智能体 / 厂商:

谷歌发布第八代 TPU 新成员 TPU 8i Max 与 TPU 8tx:8i Max 双芯封装,算力、SRAM 和 HBM 带宽翻倍;8tx 主打机密推理,同步开源 TPU Sync

11 月 9 日,Google Cloud 官方账号和 Google AI 与基础设施 SVP Amin Vahdat 宣布第八代 TPU 新增两套系统。TPU 8i Max 把两颗 TPU 8i 芯片封装在一起,官方称算力、SRAM 和 HBM 带宽都是 TPU 8i 的 2 倍,面向超长上下文和最高机架算力密度。TPU 8tx 与 TPU 8t 同一颗芯片,搭配第 5 代 AMD EPYC 主机,在硬件层保护运行中的数据和模型权重,官方称延迟比 TPU 8t 低最多 2 倍、性能损失接近零。加上 4 月发布的 8t、8i,这是谷歌第一次在一年内推出 4 套 TPU 系统。软件方面,谷歌开源 TPU Sync(官方称 KV 传输延迟和首 token 时间降低 90% 以上),推出 Agent Compute Engine 和预览版 TPU Agent 套件(可接入 Claude Code、Cursor、Antigravity),Cloud Pathways 和 GKE 动态切片正式 GA。官方未公布上市时间和价格。

谷歌发布第八代 TPU 新成员 TPU 8i Max 与 TPU 8tx:8i Max 双芯封装,算力、SRAM 和 HBM 带宽翻倍;8tx 主打机密推理,同步开源 TPU Sync

核心要点速览

  • 产品线:第八代 TPU 现有 4 套系统:8t(训练)、8i(低延迟推理)、8tx(机密计算)、8i Max(超长上下文),谷歌称是首次一年内推出 4 套 TPU 系统
  • TPU 8i Max:两颗 8i 芯片合封,官方口径算力、SRAM、HBM 带宽均为 8i 的 2 倍,同样机架占地放下 2 倍硅片
  • TPU 8tx:与 8t 同芯片,配 第 5 代 AMD EPYC 主机,数据和权重在使用中也受硬件保护;官方称延迟比 8t 最多低 2 倍,性能损失接近零
  • 软件:开源 TPU Sync(官方称 KV 传输延迟与 TTFT 降 90% 以上);GKE 动态切片 GA,作业启动最多快 5 倍、故障恢复最多快 4.5 倍
  • 开发者:预览版开源 TPU Agent 套件可接入 Claude Code、Cursor、Antigravity;TPU 客户已近 100 家;上市时间与价格官方未公布
阅读全文
AD赞助内容

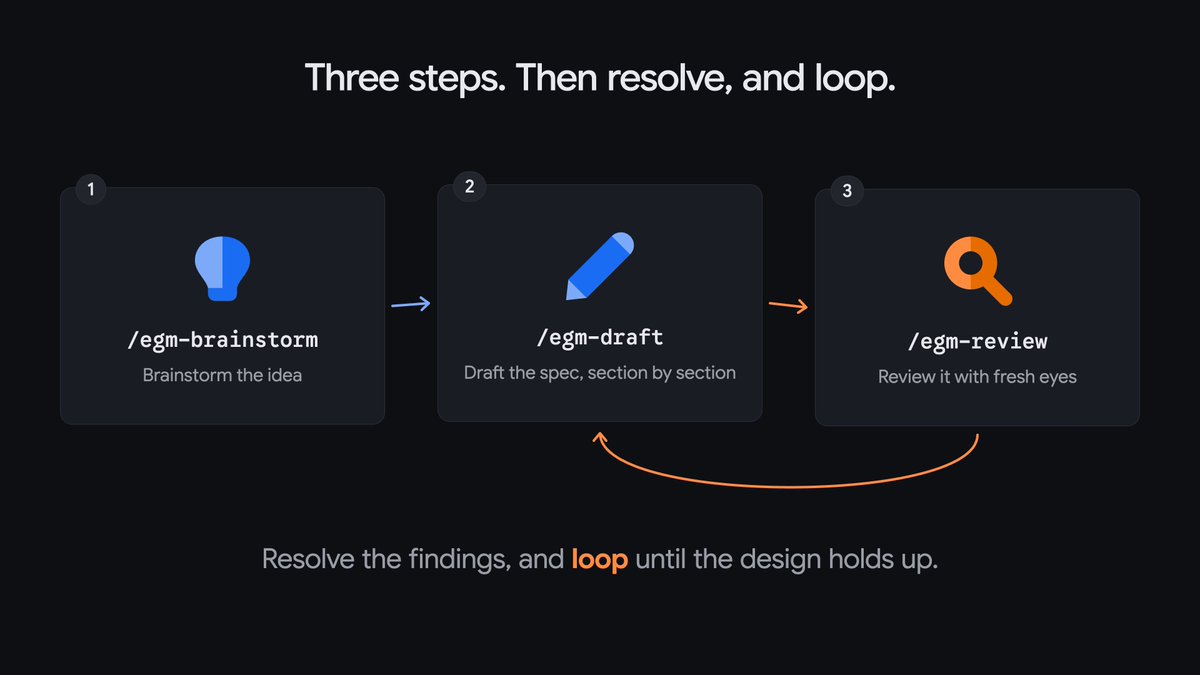
Google 开源 Elephant-Goldfish Model(EGM)插件:先写规格再写代码,用零上下文子代理分五个阶段审设计

Google Cloud Tech 官方账号于 2026-11-07 23:00 UTC(新加坡时间 11 月 8 日 07:00)推介 Google 新开源插件 Elephant-Goldfish Model(EGM)。“大象”带着项目上下文起草设计规格,“金鱼”是不看之前对话的全新子代理,分五个阶段挑出隐含假设和实现风险,由开发者拍板后再写代码。仓库在 google 组织下,Apache-2.0 许可,支持 Claude Code、Codex、Antigravity 和 ChatGPT 桌面端,最新版本 v0.1.1。README 注明它不是 Google 官方支持的产品,官方未公布效果跑分。

Google 开源 Elephant-Goldfish Model(EGM)插件:先写规格再写代码,用零上下文子代理分五个阶段审设计

核心要点速览

  • 仓库 google/elephant-goldfish-model 采用 Apache-2.0 许可;截至写稿时 GitHub 约 1.49 万星、1084 个 fork
  • Google Cloud Tech 官方推文约 1693 赞、188 转发、1707 次收藏、13.7 万次浏览(写稿时数据)
  • egm-review 五个审查阶段:初始全局审视、理解度审查、设计批判、中期全局审视、实现就绪度检查
  • 支持 Claude Code、Codex CLI、Antigravity 和 ChatGPT/Codex 桌面端;v0.1.1(11 月 6 日)新增 Cursor、OpenCode、GitHub Copilot 实验适配器
  • README 注明「不是 Google 官方支持的产品」;官方未公布缺陷检出率等效果数据
阅读全文

X 热议:DeepMind 副总裁、Google Cloud 首席科学家 Pushmeet Kohli 称科研发现节奏出现「真正的相变」,并说未来几周发布会给出一瞥

Google DeepMind 副总裁、Google Cloud 首席科学家 Pushmeet Kohli(@pushmeet,个人简介写明该职务)于 2026-11-08 10:15 UTC 在 X 发帖称,在 DeepMind 的多个项目中,他们正见证科学发现节奏的一次「真正的相变」(genuine phase transition),并说「未来几周的发布里你们会看到一瞥」。他随后跟帖补充:随着这种 AI 驱动的加速展开,重点将是帮助更广泛的科学界负责任地使用这些工具。抓取时原帖约 1,996 赞、149 转发、48 引用、71 回复、272 收藏、约 72,735 展示。帖中未点名具体领域、模型或发现,也不是 Google DeepMind 官方账号公告。

核心要点速览

  • 原帖:Pushmeet Kohli(个人简介「Chief Scientist, Google Cloud. VP DeepMind」)2026-11-08 10:15 UTC 发帖,抓取时约 1,996 赞、149 转发、48 引用、71 回复、272 收藏、约 72,735 展示
  • 原话是:在 DeepMind 的多个项目中,他们正见证科学发现节奏的一次「真正的相变」,「未来几周的发布里你们会看到一瞥」
  • 跟帖(同一分钟发出)只补充:随着这种 AI 驱动的加速展开,重点将是帮助更广泛的科学界负责任地使用这些工具
  • 帖中没有点名学科、模型、产品或任何一项具体发现;回复区有人追问「哪一个发现从几年变成了几周」,作者未在原帖作答
  • 定性:DeepMind 副总裁的个人账号发言引发的讨论,不是 @GoogleDeepMind 官方公告,也没有新的官方数据或可核对的发布清单
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI Codex CLI 0.167.0 发布:Agent 指挥中心未读标记、会话可切换后端且保留草稿,并支持 Vertex AI 登录向导

2026-11-06,OpenAI 在 GitHub 与 ChatGPT/Codex changelog 发布 Codex CLI 0.167.0:可用 codex agents --no-daemon 打开 Agent 指挥中心并标记未读结果;终端会话选择器可切换已连接后端且保留草稿;支持本地图片预览、审批提示中展开补丁,以及可选的 Google Cloud Vertex AI 登录向导。

核心要点速览

  • 官方:GitHub rust-v0.167.0(2026-11-06T01:40Z)与 ChatGPT/Codex changelog 同日条目
  • 指挥中心:codex agents --no-daemon;指挥中心与会话选择器标记未读结果
  • 多后端:终端会话选择器可切换已连接后端,切换时保留草稿
  • 体验:支持终端本地图片预览、审批弹窗内展开补丁详情;网络审批在请求结束后关闭、同端点并发一次只弹一个
  • 接入:开启 gcp_setup_wizard 后可在「Sign in another way」配置 Vertex AI(ADC 或凭证文件);macOS/Windows 系统代理可从 /experimental 选用
阅读全文
关联模型 / 智能体 / 厂商:

Google 将 Agent Substrate / gVisor / OpenRL 捐赠 CNCF,Agent Substrate 1.0 在 GKE 正式 GA

2026-11-05,Google Cloud 宣布把 Agent Substrate、gVisor、OpenRL 捐赠给 CNCF(已入选 Sandbox),并宣布 Agent Substrate 达到 1.0,以 Agent Substrate on GKE 正式 GA。厂商口径:空闲 Agent 快照后可在任意 Worker 上 <500ms 恢复,约 10× 容器密度。

Google 将 Agent Substrate / gVisor / OpenRL 捐赠 CNCF,Agent Substrate 1.0 在 GKE 正式 GA

核心要点速览

  • 官方:@GoogleOSS 2026-11-05 17:05 UTC;Google Cloud 博客;VP Drew Bradstock
  • 捐赠:Agent Substrate、gVisor、OpenRL 进入 CNCF Sandbox;gVisor 规划走向 Incubation
  • GA:Agent Substrate 1.0 / Agent Substrate on GKE;可托管或任意 Kubernetes 自托管
  • 厂商口径:恢复 <500ms、约 10× 密度、>500 挂起恢复/秒;隔离可选 microVM 或 gVisor
  • 入口:ate.dev / gvisor.dev / openrl.dev
阅读全文

Google DeepMind 用 Gemini 做的 PlanAssist 扩到英国 15 个地方政府:试点中规划审查耗时最多降 58%

Google DeepMind 于 10 月 31 日宣布,与英国政府、Google Cloud 和 Faculty 共同开发的规划审查工具 PlanAssist(基于 Gemini)将新增开放给 12 个英格兰地方规划机构,参与总数达到 15 个,进入为期 12 个月的 Beta 阶段并处理真实申请。官方称,在 Barnet、Camden、Dorset 三地的早期试点中,规划官员花在住宅类申请评估上的平均时间下降 58%,超过 70% 的 AI 草拟报告无需修改即获通过;最终决定仍由规划官员作出。

Google DeepMind 用 Gemini 做的 PlanAssist 扩到英国 15 个地方政府:试点中规划审查耗时最多降 58%

核心要点速览

  • 规模:从 3 个试点地方政府扩到 15 个,新增 12 个分三批接入,Beta 期 12 个月(DeepMind 博客)
  • 效率:试点中住宅类申请的官员评估时间平均下降 58%(官方/厂商口径,DeepMind 在 X 上写作「最多 58%」)
  • 质量:超过 70% 的 AI 草拟报告被官员直接批准、无需修改(官方口径)
  • 英国政府称,配合新规,住宅类常规申请处理时间可从 8 周减半到 4 周;计划 2027 年向英格兰所有地方政府开放(GOV.UK)
阅读全文
关联模型 / 智能体 / 厂商:
A
Anthropic (Claude Help Center)support.claude.com·
👀32
🔥82

Anthropic 旧款 Claude 文本水印到位:Mythos 5、Opus 4.7、Sonnet 4.6 第一方与云渠道均已标注,Bedrock 11 月 10 日前完成,Opus 4.6 等仍未覆盖

Anthropic 官方帮助中心「How Claude marks AI-generated content」本周再次更新支持表:8 月 2 日前发布的旧模型中,Claude Mythos 5、Opus 4.7、Sonnet 4.6 已同时勾选「第一方产品文本水印」和「云厂商输出文本水印」(AWS、Google Cloud、Microsoft Foundry),并注明 Amazon Bedrock 上的推送将于 11 月 10 日前完成;Opus 4.6、Opus 4.5、Sonnet 4.5、Haiku 4.5 目前只有 C2PA 文件凭证,文本水印仍未上线。官方还新增限制说明:Sonnet 4.6、Opus 4.6 若把 temperature、top_p 或 top_k 设为非默认值,输出可能无法可靠带上水印。此前媒体据客户邮件称旧模型水印 11 月 3 日起生效。水印基于 SynthID-Text 变体,不加字符、不多耗 token,检测 API 仍为私测。

Anthropic 旧款 Claude 文本水印到位:Mythos 5、Opus 4.7、Sonnet 4.6 第一方与云渠道均已标注,Bedrock 11 月 10 日前完成,Opus 4.6 等仍未覆盖

核心要点速览

  • 最新支持表(帮助中心,本周更新):Mythos 5、Opus 4.7、Sonnet 4.6 已勾选第一方与云厂商两列文本水印;Opus 4.6、Opus 4.5、Sonnet 4.5、Haiku 4.5 只有 C2PA,文本水印尚未上线
  • 时间:官方注明 Amazon Bedrock 推送 11 月 10 日前完成;此前媒体据客户邮件称旧模型 11 月 3 日起生效(MACCUS 报道)
  • 采样参数坑:Sonnet 4.6(以及限制说明中提到的 Opus 4.6)把 temperature、top_p 或 top_k 设为非默认值时,输出可能无法可靠带上水印
  • 成本与质量:官方称水印不加任何字符、不多耗 token、不涨价,方法是 SynthID-Text 的一个变体(见 Anthropic 说明)
  • 检测:检测 API 仍为私测,仅对监管、执法、媒体、事实核查、研究者及有合规义务的企业开放;水印在所有支持的产品上全球统一生效
阅读全文
AD赞助内容

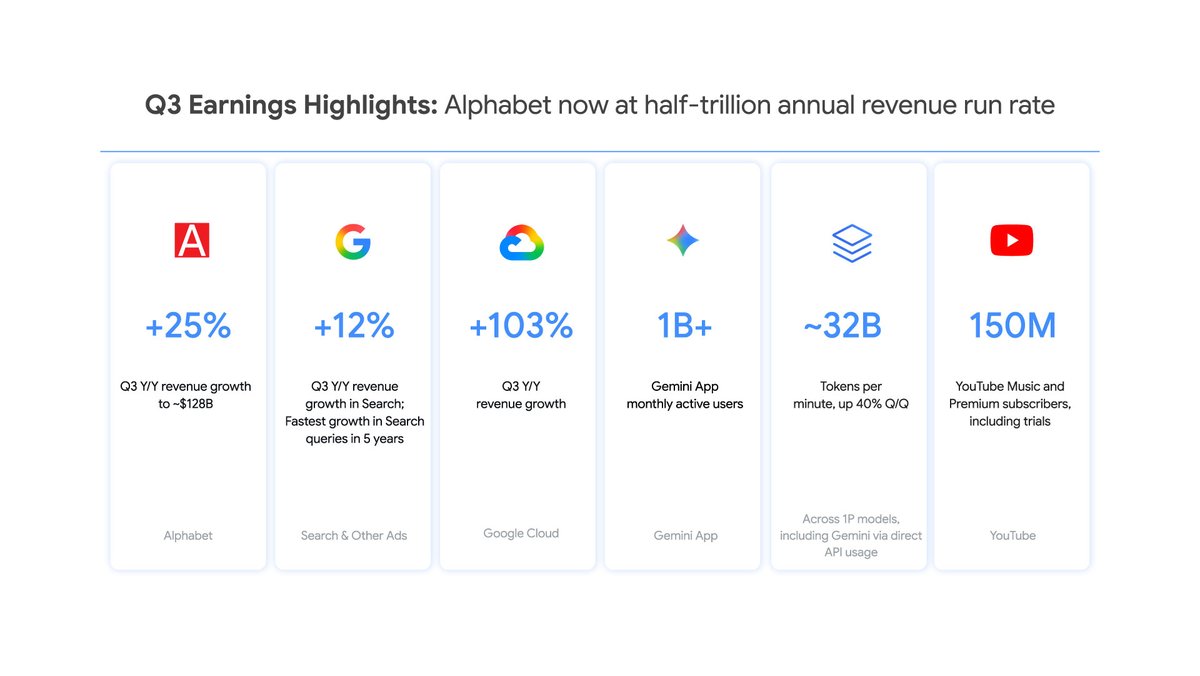
Alphabet 2026 Q3 财报:营收 1276 亿美元增 25%,Google Cloud 翻倍增长 103%,一方模型 API 每分钟处理近 320 亿 token

Alphabet 10 月 28 日美股盘后发布 2026 年第三季度财报:营收 1276 亿美元,同比增长 25%;Google Cloud 营收 307 亿美元,同比增长 103%,官方称由企业 AI 基础设施、AI 解决方案和 TPU 系统销售拉动。Sundar Pichai 在财报和 X 上表示,一方模型 API 每分钟处理近 320 亿 token,是一年前的四倍多,Gemini App 用户达到 10 亿。代价是本季资本开支 514 亿美元,自由现金流为负 91 亿美元。

Alphabet 2026 Q3 财报:营收 1276 亿美元增 25%,Google Cloud 翻倍增长 103%,一方模型 API 每分钟处理近 320 亿 token

核心要点速览

  • 营收 1275.77 亿美元,同比 +25%,连续第 13 个季度两位数增长;Pichai 称年化营收已达 5000 亿美元
  • Google Cloud 营收 307.09 亿美元(去年同期 151.57 亿),同比 +103%;经营利润 111.21 亿美元,去年同期 35.94 亿
  • 一方模型 API 每分钟近 320 亿 token,是一年前的 4 倍多;Pichai 的 X 帖称环比增长 40%
  • Gemini App 用户达 10 亿,官方称是 Google 史上增长最快的产品;Search 查询量同比增速为近 5 年最高
  • 本季资本开支 513.55 亿美元(去年同期 239.53 亿),自由现金流 -90.65 亿美元,连续第二个季度为负
阅读全文

DeepMind 机器人「大脑」Gemini Robotics ER 2 上线 Google Cloud 公开预览:企业可用它编排 VLA 模型和多机器人协作

Google Cloud 10 月 27 日宣布,Google DeepMind 的具身推理模型 Gemini Robotics ER 2 在 Gemini 平台(Model Garden)开放公开预览,模型 ID 为 gemini-robotics-er-2-preview,基于 Gemini 3.5 Flash。它充当机器人的高层「大脑」,能理解视频中的空间和时间信息、规划多步任务、判断动作是否成功,并把 VLA 模型和导航 API 当作工具来调度,支持多台不同形态机器人协作。官方称其定位视频关键帧的准确率为 91.3%。

核心要点速览

  • 模型 ID gemini-robotics-er-2-preview,基于 Gemini 3.5 Flash,输入支持文本、图像、视频、音频,输入上限 131,072 token、输出 65,536 token
  • 核心用法是把 VLA 模型、导航 API 或自定义函数声明为工具,由 ER 2 负责规划和调度,并可用自然语言解释和接受改派
  • 能把任务进度分为二元、离散或连续分数,官方称定位关键帧准确率 91.3%、平均帧误差 0.96 秒
  • 可读取表盘、液位计、数显屏、刻度尺等 10 多类仪表读数
  • 企业版提供 IAM、安全控制和函数调用;Cloud 预览支持 GenerateContent,不支持 Live API;Boston Dynamics、Arm 等已在试用
阅读全文
关联模型 / 智能体 / 厂商:

Google Cloud 开源 TorchTPU:PyTorch 原生直通谷歌 TPU 芯片,vLLM 与 SGLang 宣布首发适配

Google Cloud 官方正式宣布开源 TorchTPU 核心加速框架,首次实现 PyTorch 框架原生、无编译壁垒地直接运行在 Google TPU(TPU v5p 与最新 TPU v6e)芯片之上。传统基于 PyTorch/XLA 的方案因复杂的计算图编译开销和动态形状限制,严重制约了 PyTorch 开发者在 TPU 上的创新步伐。TorchTPU 彻底打通了原生 PyTorch Eager 模式与自定义 Triton/C++ 硬件内核;主流高性能大模型推理引擎 vLLM 与 SGLang 同步官宣提供首发适配。同时,Google Cloud 宣布在其 Model Garden 引入 OpenAI 旗舰模型与 Codex,成为首个集齐全部三大顶级闭源模型的超算云平台。

Google Cloud 开源 TorchTPU:PyTorch 原生直通谷歌 TPU 芯片,vLLM 与 SGLang 宣布首发适配

核心要点速览

  • Google Cloud 官方开源 TorchTPU,支持 PyTorch 原生、免转译直接运行在 TPU v5p 与 TPU v6e 芯片
  • 彻底消除 PyTorch/XLA 传统图编译开销,原生支持 PyTorch Eager 动态模式与自定义 Triton/C++ 算子加速
  • vLLM 与 SGLang 同步发布专为 TorchTPU 深度优化的官方版本,实现高并发大模型推理吞吐量翻倍
  • OpenAI 旗舰模型与 Codex 正式登陆 Google Cloud Model Garden,打造最全面的跨厂商大模型生态
阅读全文

OpenAI 前沿模型与 Codex 登陆 Google Cloud:进入 Model Garden,可经 Marketplace 购买并抵扣 GCP 承诺消费

10 月 21 日,OpenAI 与 Google Cloud 宣布合作,把 OpenAI 前沿模型与 Codex 智能体工作流引入 Google Cloud Model Garden,通过 Google Cloud Marketplace 交易,企业可用既有 GCP 承诺消费抵扣;OpenAI 模型也将很快进入 Google Antigravity 与 Gemini Agent。官方称正式可用(GA)在未来几周,Microsoft 仍是 OpenAI 的主要云合作伙伴。继 AWS 之后,OpenAI 模型将覆盖美国三大云。

OpenAI 前沿模型与 Codex 登陆 Google Cloud:进入 Model Garden,可经 Marketplace 购买并抵扣 GCP 承诺消费

核心要点速览

  • 渠道:OpenAI 前沿模型与 Codex 进入 Google Cloud Model Garden,经 Google Cloud Marketplace 交易(官方口径)
  • 采购:企业可用既有 GCP 承诺消费抵扣,无需单独与 OpenAI 签约开票
  • 生态:OpenAI 模型将很快进入 Google Antigravity 与 Gemini Agent,与 Gemini 并列可选
  • 时间:GA 计划在未来几周,现可通过官方表单申请访问;Microsoft 仍是主要云合作伙伴
  • 格局:继 4 月 Microsoft 独家结束、AWS 上架后,OpenAI 模型覆盖美国三大云(路透/CNBC 报道)
阅读全文

llm-d 1.0 发布:Red Hat、IBM、Google 主导的 Kubernetes 原生开源分布式推理栈进入生产可用,按厂商口径自托管 3,000 个编码 Agent 比商用 API 便宜 5–10 倍

10 月 20 日 PyTorch Conference 北美站上,CNCF 沙箱项目 llm-d 发布 1.0。它把 vLLM、SGLang 等推理引擎组织成一个统一的服务池,1.0 新增多租户优先级与公平调度(flow control)、路由高可用与零停机滚动升级(DisaggregatedSet)、v1 配置 API,以及面向 Agent 的会话感知路由和 Responses API 状态支持。项目由 Red Hat、IBM、Google Cloud、CoreWeave、NVIDIA 于 2025 年创立,现有 500 多名贡献者;JetBrains、DigitalOcean、Mistral 等已在生产中使用。

llm-d 1.0 发布:Red Hat、IBM、Google 主导的 Kubernetes 原生开源分布式推理栈进入生产可用,按厂商口径自托管 3,000 个编码 Agent 比商用 API 便宜 5–10 倍

核心要点速览

  • 规模(Red Hat 新闻稿,厂商口径):在 NVIDIA GPU 上部署约 7,530 亿参数的 GLM 5.2,峰值每分钟输出 660 万 token,同时服务最多 3,000 个编码 Agent 且零抢占,按云租用价算每 token 成本比同等商用 API 低 5–10 倍
  • 缓存复用:IBM 称在 Agent 编码负载中前缀感知路由拿到了 97% 的可复用缓存;IBM Research 量子纠错芯片项目前缀命中约 98%、综合成本约每百万 token 0.11 美元,比全闭源方案低 11.5 倍
  • Google Cloud 口径:Ironwood TPU 上的 Agent 编码负载,前缀感知路由加主机内存卸载让首 token 延迟中位数下降超 85%、吞吐提升 2.4 倍;Gemini 平台前缀缓存命中率从 35% 提到 70%
  • 1.0 新能力:flow control 多租户 QoS、路由热备高可用、DisaggregatedSet 统一管理 prefill/decode 滚动升级、v1 配置 API、Responses API 支持 previous_response_id
  • 生态:500+ 贡献者、25+ 家机构;JetBrains 的免费 Junie Lite、DigitalOcean Serverless Inference、Mistral 商用分级流量已在生产中使用;GitHub v1.0.0 发布说明坦言部分既定目标未完成
阅读全文