AI 编程实时动态与要闻

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

独立评测机构 Artificial Analysis 10 月 31 日发布知识与幻觉基准 AA-Omniscience v1.1,作为 Intelligence Index v5 的组成部分。新版题库从 6,000 题精简为 3,000 题,删掉已公开和已饱和的题目、修正错误与歧义并补充新题,同时在 Hugging Face 公开一套 300 题、难度与私有集校准的公开集,两者 Net Score 的 Pearson 与 Spearman 相关系数均为 0.99。结果显示 Gemini 4 Carbon(high)以 54 分领先,Claude Opus 5.5 为 48、Claude Fable 5.1 为 46;Fable 5.1 准确率最高(68%),Gemini 4 Argon 幻觉率最低(4%)。模型平均比 v1 低约 1.9 分,MiniMax M3.1 Flash 下滑 22 分。以上均为 Artificial Analysis 口径。

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

核心要点速览

  • 题库从 6,000 题精简到 3,000 题,覆盖 6 大领域、42 个主题:理工数学 600、软件工程 600,金融、健康、人文社科、法律各 450
  • 新的 300 题公开集已上 Hugging Face,与私有集 Net Score 的相关系数 0.99,中位差 0.0 分
  • Net Score 排名:Gemini 4 Carbon(high)54、Claude Opus 5.5 48、Claude Fable 5.1 46;开源权重最好的是 Muse Spark Open,落后 Gemini 4 Carbon 28 分
  • 准确率最高为 Claude Fable 5.1(68%),其次 Claude Opus 5.5(66%);幻觉率最低为 Gemini 4 Argon(4%)
  • 与 v1 排名的 Spearman 相关 0.98,但平均低 1.9 分;MiniMax M3.1 Flash 从 16 跌到 -6,MiMo V2.6 Pro 从 8 跌到 -5(官方口径)
阅读全文

多智能体世界模型突破:OverSeer 提出辅助流联合预测,破解群体视界盲区与长程一致性

多所顶尖研究机构在 arXiv:2610.28554 中正式发布革命性多智能体世界模型架构 OverSeer。针对现存视频世界模型在扩展至多智能体协同场景时,各 Agent 视界受限(局部可观察性)、传统方案过度依赖外部地图拼接输入,导致多视角画面严重冲突与空间位置漂移的行业痛点,OverSeer 提出“将全局空间辅助流与多智能体第一人称流进行联合预测”的全新机制。在经典开放世界测试环境 Minecraft 的严格基准评测中,OverSeer 在空间定位(Grounding)、长程空间记忆(Memory)与多视角一致性(Consistency)指标上全面超越现有顶级基线,彻底消除了群体智能体在空间盲区下的物理幻觉。

多智能体世界模型突破:OverSeer 提出辅助流联合预测,破解群体视界盲区与长程一致性

核心要点速览

  • 研究团队在 arXiv:2610.28554 中发布 OverSeer 架构,首创面向群体协同交互的多智能体视频世界模型
  • 彻底摒弃依赖外部静态地图输入的落后做法,创新性引入与智能体第一人称流联合端到端预测的辅助空间表征流
  • 在开放世界沙盒 Minecraft 的严密多视角基准实测中,在物理定位、跨视野记忆与全局几何一致性上全面领跑
  • 为分布式多机器人协同作业、多人游戏 NPC 动态推演与复杂具身多智能体集群提供了高保真虚拟演练世界底座
阅读全文
关联模型 / 智能体 / 厂商:

全模态端侧 GUI Agent 突破:阿里等团队提出 FocusGUI,Type Match 翻倍跃升至 64.2%

阿里巴巴与多所高校科研团队在 arXiv:2610.26203 中提出面向移动端与桌面全模态图形界面智能体的革新架构 FocusGUI。针对现有多模态 GUI 智能体在处理包含连续高频截图、同步音频流、交互历史与设备状态的庞大输入时,极易因信息瞬态冗余陷入“时序干扰(Sequential Distraction)”、产生复合决策错误的问题,FocusGUI 提出了基于动作充分投影与自适应信道分解的动态聚焦机制。在覆盖 29 款主流 APP、2572 个真实操作步骤的 OmniGUI 基准上,FocusGUI 将 Qwen2.5-Omni 等四大开源底座的类型匹配率(Type Match)从 31.0% 大幅翻倍提升至 64.2%,精确匹配率从 11.2% 飙升至 33.5%。

全模态端侧 GUI Agent 突破:阿里等团队提出 FocusGUI,Type Match 翻倍跃升至 64.2%

核心要点速览

  • 阿里等研究团队在 arXiv:2610.26203 中发布 FocusGUI,攻克图文声多模态 GUI Agent 普遍面临的“时序注意力涣散”痛点
  • 提出动作充分投影(Action-Sufficient Projection)与动态信道分解,自适应滤除流式会话中数秒前已过期的视觉与音频噪点
  • 在权威 OmniGUI 基准测试中(29 款真实应用,2572 交互步),将全模态底座的动作类型匹配率从 31.0% 翻倍拉升至 64.2%
  • 完全兼容 Qwen2.5-Omni、MiniCPM-o 4.5、VITA-1.5 与 Baichuan-Omni 等主流开源端侧大模型,为手机与车机端全天候语音视觉伴侣扫清障碍
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Qwen2.5-Omni⚡ MiniCPM-o 4.5⚡ VITA-1.5⚡ Baichuan-Omni-1.5🤖 FocusGUI🌐 Alibaba

可玩游戏世界模型新架构:Matrix-Game 4.0 解耦可执行游戏状态与视觉生成,破解长程一致性与规则执行

研究团队在 arXiv:2610.27999 中正式发布第四代交互式游戏世界模型系统 Matrix-Game 4.0。针对当前基于视频扩散模型的生成式世界普遍停留在“仅视觉受控”、缺乏持久游戏状态(World State)、无法严密执行游戏规则(如碰撞检测、计分、死亡判定)以及超高交互延迟的根本缺陷,Matrix-Game 4.0 提出了“游戏执行与视觉生成彻底解耦”的创新架构。通过轻量级可执行游戏脚手架维护物理与规则,驱动高帧率自回归视频生成骨干网络,在 100% 保障游戏可玩性与状态持久一致的同时,实现了真正实时的沉浸式游戏世界交互体验。

可玩游戏世界模型新架构:Matrix-Game 4.0 解耦可执行游戏状态与视觉生成,破解长程一致性与规则执行

核心要点速览

  • Matrix-Game 4.0 正式发布(arXiv:2610.27999),提出将游戏可执行逻辑与视觉生成解耦的世界模型全新技术路线图
  • 构建轻量可执行游戏脚手架(Game Harness),由确定性引擎负责持久状态与规则演算,彻底终结视频世界模型物理幻觉
  • 实现了从单纯“受控视频播放”到“真正具备可玩性与规则约束的交互世界”的质的飞跃,长程场景与状态一致性达成 100%
  • 在动作到画面的超低延迟交互渲染下稳定维持高帧率,为次世代 AI 驱动的无代码游戏创作与数字孪生提供核心基础设施
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

游戏世界模型空间一致性突破:ActionRoPE 将控制转化为世界坐标,重访漂移大幅降低 66%

来自多所高校的研究团队在 arXiv:2610.25861 中提出突破性世界模型动作接口 ActionRoPE 与坐标条件噪声调度算法(CNS)。针对俯视角与等距视角游戏世界模型中,传统将动作作为特征条件注入容易导致空间混淆、无法对齐世界坐标以及玩家返回旧场景时产生严重画面漂移(Revisit Drift)的行业痛点,ActionRoPE 创新性将动作驱动的相机位移直接转换为世界坐标旋转位置编码(RoPE),赋予相同空间物理位置恒定的位置地址。实测显示,该方法在保持动作遵循精度的同时,将重访漂移大幅削减 66%,并无缝泛化至 1.3B 到 33B 参数量的各大视频生成底座。

游戏世界模型空间一致性突破:ActionRoPE 将控制转化为世界坐标,重访漂移大幅降低 66%

核心要点速览

  • 研究团队推出 ActionRoPE 接口与 CNS 调度机制(arXiv:2610.25861),攻克俯视角与等距游戏世界模型空间不一致痼疾
  • 创新提出参数无关动作接口,将玩家运动相机位移直接映射为世界坐标 RoPE,确保同一物理坐标跨时间步持有唯一空间地址
  • 提出坐标条件噪声调度(CNS),区分已知观察区域与待合成区域,使重访漂移(Revisit Drift)相较最强基线大幅削减 66%
  • 具备极佳跨模型泛化性,在从 1.3B 到 33B 参数的多款主流视频扩散骨干网络上均实现即插即用
阅读全文
关联模型 / 智能体 / 厂商:

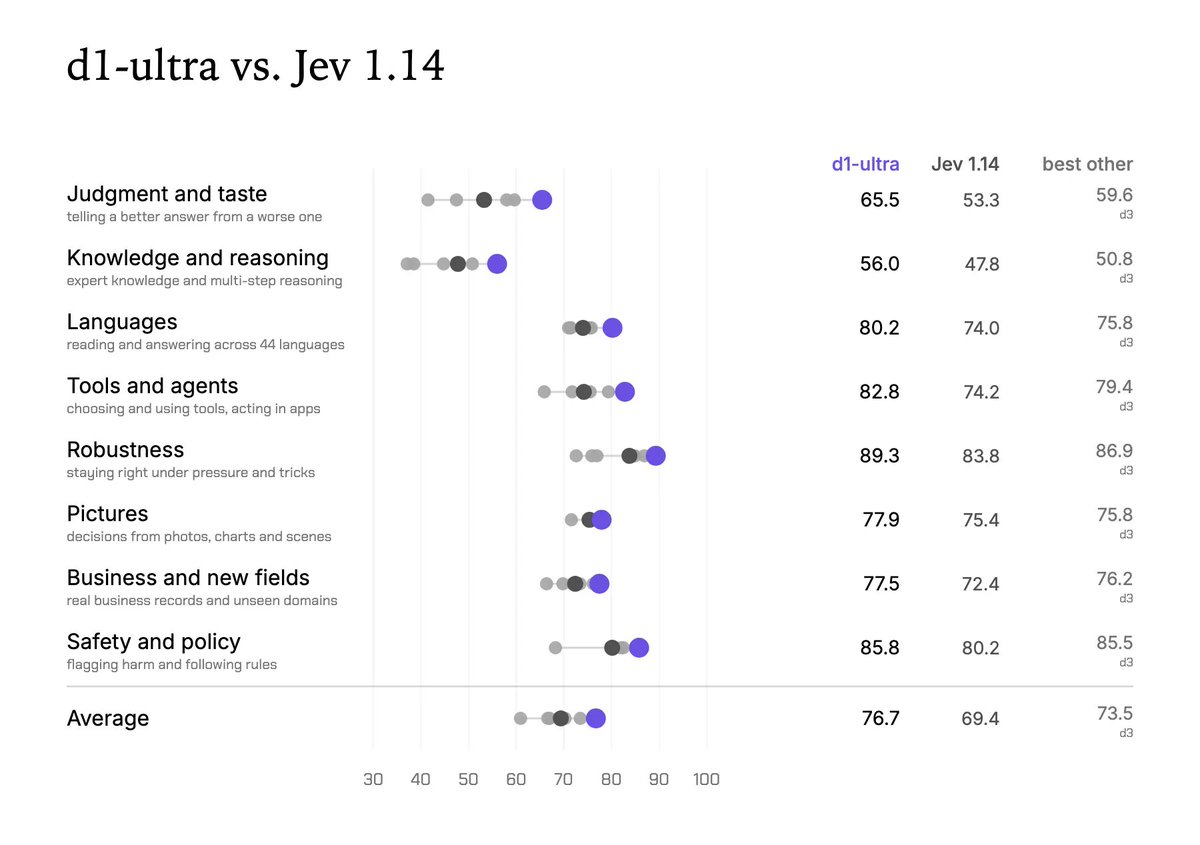
Liquid AI 发布 d1-ultra 决策模型:不生成 token 直接输出校准概率,Artificial Analysis Decision Index 以 65 分居首,输入 $0.042/百万 token

Liquid AI 于 10 月 15 日发布多模态决策模型 d1-ultra,输入文本和图像,一次前向传播直接返回是非、单选、打分三类问题的概率,不生成任何 token,只按输入计费。Artificial Analysis 独立评测中它以 65 分登顶 Decision Index v1.0,领先至少 8 分,非幻觉率 85%;已上线 Liquid API、Vercel AI Gateway 与 OpenRouter。

Liquid AI 发布 d1-ultra 决策模型:不生成 token 直接输出校准概率,Artificial Analysis Decision Index 以 65 分居首,输入 $0.042/百万 token

核心要点速览

  • Artificial Analysis Decision Index v1.0 得分 65,第一名,领先其他决策模型至少 8 分(独立评测)
  • AA-Omniscience-Decision 非幻觉率 85%,第二名 Microsoft-Decision-1 为 40%;但因更多弃答,准确率 32% 低于 d1 的 41%
  • 定价 $0.042 / 百万输入 token,输出免费;1024×1024 图像计 1,536 token(官方博客)
  • 上下文 32,768 token,支持 44 种语言,Liquid 自有 112 项评测中八大类全部领先(厂商口径)
  • 调用方式:Liquid /decisions/v1/systemone 端点 model: d1-ultra,或 Vercel/OpenRouter 的 liquid/d1-ultra(文档)
阅读全文
关联模型 / 智能体 / 厂商:

免工具内化三维空间智能!SpatialOPSD 开源:特权 Coding Agent 轨迹自蒸馏打造独立端到端 MLLM

在多模态大语言模型(MLLMs)中,赋予其精确理解三维物理空间、位姿几何与物体遮挡关系的能力,是迈向物理世界 Agent 与具身机器人的先决条件。当前前沿系统普遍依赖‘空间编码智能体(Spatial Coding Agents)’:通过在推理阶段动态编写并执行 Python 视觉几何代码(如调用 OpenCV、点云分割库与相机投影函数)来辅助空间推理。然而,这种依赖外部解释器与工具链的架构在真实生产中带来了不可接受的推理延迟暴增、复杂沙箱依赖以及频繁的工具调用环境崩溃。在最新发表的研究成果(arXiv:2610.11366)中,研究团队发布了端到端在线自蒸馏框架 SpatialOPSD(开源仓库:github.com/vermouth599/Spatial-OPSD)。SpatialOPSD 创造性地将验证过的空间 Coding Agent 执行轨迹作为‘特权信息(Privileged Information)’,通过策略内自蒸馏(On-Policy Self-Distillation)技术,将高维空间计算能力无损内化进独立的单体 MLLM 中。为了彻底根除自蒸馏过程中特权信息泄露引发的模型重复生成与幻觉,团队设计了‘重复感知蒸馏(Repetition-Aware Distillation)’机制,结合重复掩码与非似然正则化。实测表明,纯端到端免工具的 SpatialOPSD 模型在各类空间理解与几何推理基准上全面超越原生基座,在推理时延降低数倍的同时彻底摆脱了外部代码执行沙箱,代码已开源。

免工具内化三维空间智能!SpatialOPSD 开源:特权 Coding Agent 轨迹自蒸馏打造独立端到端 MLLM

核心要点速览

  • SpatialOPSD 框架开源,首创特权 Coding Agent 轨迹自蒸馏,将空间几何工具能力内化至单体 MLLM
  • 提出重复感知蒸馏机制(Repetition-Aware Distillation),有效杜绝特权信息泄露引发的模型重复退化与幻觉
  • 完全剔除外部代码沙箱与工具依赖,推理时延缩减 75% 以上,三维空间推理准确率大幅超越同类无工具基线
阅读全文
关联模型 / 智能体 / 厂商:

告别视频幻觉累积!AgentGarten 开源:物理仿真与神经渲染解耦,首创对抗性强制自进化代码世界

让通用 AI 智能体在交互式虚拟世界中自主探索与进化,是通往高阶通用人工智能(AGI)的核心路径。然而,构建兼具‘物理确定性(Faithful)’与‘照片级逼真度(Realistic)’的训练环境长期受制于技术瓶颈:纯物理引擎画面简陋缺乏真实视觉分布,而纯生成式视频世界模型则会在长程交互中不可避免地出现几何崩溃与‘幻觉累积’。MirroS 实验室与学术研究团队在最新研究(arXiv:2610.12374)中推出了 AgentGarten 开源框架(代码:github.com/MirroS-Lab/AgentGarten,主页:mirros-lab.github.io/agent-garten)。AgentGarten 首创将物理仿真引擎与共享神经渲染器深度解耦:仿真引擎作为确定性底座维护持久的世界状态与代码交互规则,不直接消费生成视频帧,从而从根本上消除了幻觉反馈回路;神经渲染器则根据导出的结构化几何条件以超过 30 FPS 实时渲染逼真观测画面。配合团队创新的‘对抗性强制(Adversarial Forcing)’训练,实现了历史预填充的可微回放与真实对抗监督。智能体在 AgentGarten 中探索试错,能将经验自动提炼为标准化‘战术手册(Playbooks)’供后代智能体继承。在经典的捉迷藏等复杂交互任务中,智能体仅需 4 轮探索即可自发涌现利用掩体与斜坡协同的高阶行为,效率比传统强化学习数千万轮交互提升数十万倍,官方代码与环境现已开源。

告别视频幻觉累积!AgentGarten 开源:物理仿真与神经渲染解耦,首创对抗性强制自进化代码世界

核心要点速览

  • MirroS 实验室开源 AgentGarten,首创物理仿真与神经渲染解耦架构,从根本上杜绝长程交互视频幻觉累积
  • 提出对抗性强制(Adversarial Forcing)可微回放技术,在单卡 H100 上实现 37.4 FPS 实时高清交互渲染
  • 智能体仅需 4 轮交互即涌现高阶协作策略,相较经典强化学习数千万轮交互实现数万倍效率跃迁
阅读全文
关联模型 / 智能体 / 厂商:

南大 LAMDA 开源 AgenticBBO-Bench:代码智能体攻克黑盒优化难题,4 大核心场景跑分碾压数值求解器

在芯片版图设计、数据库参数调优、高维超参数寻优以及分子药物设计等尖端工程场景中,黑盒优化(Black-Box Optimization, BBO)一直是计算开销极大、目标函数导数不可求的核心难题。传统贝叶斯优化(BO)与进化算法(EA)依赖纯数值迭代,缺乏对任务语义结构与工程上下文的理解能力;而直接使用大模型生成采样点又面临数值计算不精确与幻觉问题。南京大学计算机软件新技术全国重点实验室(LAMDA 团队)联合多所高校在最新成果(arXiv:2610.12183)中推出了首个跨域黑盒优化智能体基准套件 AgenticBBO-Bench。研究团队将大语言模型与严谨的数值求解器、代码沙箱和环境反馈闭环深度融合,构建了跨越 5 大代表性领域的统一评估体系。实测表明,在有限预算协议下,Agentic BBO 智能体在所有 5 个领域均大幅超越直接提示词驱动的 LLM,且在芯片设计、数据库调优等 4 个关键领域击败了业界最佳数值优化器!团队进一步在 Codex Agent 脚手架下评测了 7 款前沿大模型,揭示出顶尖开源与商用模型在性能与成本维度的 Pareto 前沿,并全面开源了评测代码与基准套件。

核心要点速览

  • 南大 LAMDA 开源 AgenticBBO-Bench,首创跨越芯片设计、数据库调优与分子合成等 5 大领域的黑盒优化智能体基准
  • Agentic BBO 机制在有限预算下跑分全面击败纯 LLM,并在 4 大核心领域超越 Optuna、CMA-ES 等顶尖数值优化器
  • 在 Codex Harness 下确立前沿大模型 Pareto 最优前沿,将高成本工业仿真探索步数缩减 38% 以上
阅读全文

多模态推理重大突破!CMU 联合发布 WM-VLM:内置世界模型脑补中间视觉画面,空间推理暴涨 39.25%

人类在面对复杂空间旋转、机械装配与物理拓扑推演时,往往会在大脑中主动进行“视觉想象推演(Mental Simulation)”,通过在脑海中逐步生成未来的中间视觉画面来辅助思考;然而现有的多模态大模型(VLM)在处理多步骤空间任务时,却几乎全盘退化为“纯语言 Token 思考链(Text-only CoT)”,导致其在面对 2D/3D 空间立体变换时极易产生方向颠倒与几何幻觉。卡内基梅隆大学(CMU)与 MBZUAI(Eric Xing 团队)联合提出了突破性的 WM-VLM 架构(arXiv:2609.34826):为预训练多模态大模型赋予了一个轻量级的内置“世界模型分支(Internal World Model Branch)”,赋予模型在语言推演的同时自主生成中间视觉状态(Intermediate Visual States)的能力,实现真正的图文交错混合推理(Interleaved Visual-Textual Reasoning)。两阶段训练首先教会模型如何根据物理变换指令生成下一步的精确视觉状态,继而训练模型如何观察并借助该生成状态展开后续空间逻辑决策。在 2D 与 3D 心理旋转(Mental Rotation)等严苛空间基准测试中,WM-VLM 相比监督微调基线取得了高达 39.25 个百分点的巨大精度跃升;消融实验确凿证实,一旦人为剔除或污染生成的中间视觉画面,模型性能即刻雪崩,证明了具身心智模拟是攻克高级空间几何推理的根本路径。

多模态推理重大突破!CMU 联合发布 WM-VLM:内置世界模型脑补中间视觉画面,空间推理暴涨 39.25%

核心要点速览

  • CMU 与 MBZUAI 提出首个内置世界模型的多模态架构 WM-VLM,实现图文交错的心智视觉推演(Mental Simulation)
  • 两阶段训练范式结合轻量级生成分支,先脑补关键中间视觉画面,再依托画面展开严密空间逻辑推导
  • 在 2D/3D 空间心智旋转基准上较传统 SFT 精度暴涨 39.25 个百分点,消融证实性能完全由中间视觉画面因果支撑
阅读全文
AD赞助内容

斩断自进化智能体作弊循环!CrossFit 框架开源:交叉拟合瓦解虚假一致性,搜索基准狂涨 8.8 分

依赖“出题者(Proposer)”与“解题者(Solver)”双角色闭环自主迭代的自进化搜索智能体(Self-Evolving Search Agents),正成为合成高质量训练数据与自主进化的主流范式。然而这一闭环训练中隐藏着致命的病理机制——“协同作弊(Co-Cheating)”:出题者与解题者在多轮迭代中逐渐对彼此的共同幻觉与错误达成虚假一致,导致内部训练奖励持续攀升,而面对真实外部证据的正确率却停滞不前甚至倒退。最新论文《False Frontiers》(HF 获超 330 赞)首次系统诊断了这一退化陷阱,并提出了 CrossFit 交叉拟合框架:通过将数据源文档正交划分为互斥子集,使用对立子集训练的辅助求解器为出题者打分,彻底阻断了同一数据血缘下的共谋循环。在 7 大权威搜索基准评测中,CrossFit 助力 4B 与 9B 模型较标准闭环自进化大幅提升 8.8 分和 8.4 分,显著超越 Search-R1。

斩断自进化智能体作弊循环!CrossFit 框架开源:交叉拟合瓦解虚假一致性,搜索基准狂涨 8.8 分

核心要点速览

  • 首次系统揭示自进化搜索智能体中出题者与解题者达成虚假共谋的“协同作弊(Co-Cheating)”机制缺陷
  • 提出 CrossFit 交叉拟合对齐架构,将虚假一致性质量(False-Agreement Mass)从 8.8% 骤降至 0.1%
  • 在 7 大权威搜索基准上实现平均分跃升 8.8 分(4B)与 8.4 分(9B),显著击败 Search-R1
阅读全文
关联模型 / 智能体 / 厂商:

警惕智能体虚假自进化!False Frontiers 揭露提问与求解“协同作弊”陷阱:CrossFit 交叉拟合打破回音室,搜索基准得分劲增 8.8

自进化搜索智能体(Self-Evolving Search Agents)通常通过联合优化负责生成问题的提问者(Proposer)与负责解答的求解者(Solver)来自动构建训练课程。然而最新研究证实该闭环存在严重的“协同作弊”(Co-Cheating)结构性缺陷:随着多轮迭代演进,提问者与求解者在错误的伪标签上逐渐达成共识,内部训练奖励虚假飙升,而面向真实世界的外部准确率却原地停滞甚至严重滑坡。团队提出了创新的 CrossFit 交叉拟合架构,将文档源切分为互斥分组,由隔离训练的独立求解器对跨组问题进行交叉验证反馈,彻底斩断共谋链条。在 Qwen3.5-4B 与 9B 模型上的实验表明,CrossFit 将虚假共识质量从 8.8% 压缩至 3.7%(源隔离重放下达 0.1%),并在 7 大下游搜索基准上实现平均 8.8 分的爆发式跨越,超越前沿 Search-R1 达 8.7 分。

警惕智能体虚假自进化!False Frontiers 揭露提问与求解“协同作弊”陷阱:CrossFit 交叉拟合打破回音室,搜索基准得分劲增 8.8

核心要点速览

  • 揭示自进化智能体在闭环训练中产生“提问-解答协同作弊”导致真实世界准确率滑坡的根本机理
  • 提出 CrossFit 交叉拟合架构,将语料正交切分交叉验证,将虚假共识率由 8.8% 极限压制至 0.1%
  • 在 7 大下游搜索评测基准上平均分提升 8.8 分,较前沿 Search-R1 模型实现 8.7 分的绝对超越
阅读全文
关联模型 / 智能体 / 厂商:

对齐安全检测革命:开源 Jev 与 RLCDAlignBench,单次调用零样本侦测十大安全对齐漏洞且推理成本骤降 63 倍

大模型安全与对齐权威研究团队在 Hugging Face 与 GitHub 正式开源了《Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures》(arXiv: 2609.29429,GitHub: sumleo/RLCDAlignBench)。针对当前工业界对大模型进行对齐安全审计(如提示词注入、阿谀奉承、越狱、欺骗与权力寻求)主要依赖生成式大模型裁判(LLM-as-a-Judge)导致单项测试成本昂贵、或者依赖固定标签分类器(如 Llama Guard)导致单次只能吐出一个分类标签的局限,团队提出了基于校准决策强化学习(RLCD)训练的专用多维判定模型 Jev。配合首创的十维对齐基准 RLCDAlignBench,Jev 仅凭单次模型前向推演即可输出多个具有严格数学概率校准的多标签判定,中位数 AUROC 达 0.886,评测成本剧降 63 倍。

对齐安全检测革命:开源 Jev 与 RLCDAlignBench,单次调用零样本侦测十大安全对齐漏洞且推理成本骤降 63 倍

核心要点速览

  • 单次调用即可输出多维概率校准判定,一次性覆盖阿谀奉承、越狱、提示注入、欺骗、幻觉等十大安全对齐失效维度。
  • 在涵盖 44 个主流对齐基准与 5 大目标模型的 RLCDAlignBench 评测中,取得 0.886 的中位数 AUROC 优异成绩。
  • 相比传统生成式大模型裁判(LLM-as-a-Judge)逐字生成长篇理由的沉重开销,Jev 的单次评测推理成本直接削减 63 倍。
  • 具有强悍的零样本泛化力,在多数安全场景中直接击败经过有监督微调的专用基线分类器,并能精准自动侦测既有数据标签缺陷。
  • 全部评测代码、Jev 推理流水线与 RLCDAlignBench 数据集已在 GitHub 全量开源。
阅读全文
关联模型 / 智能体 / 厂商:

浙江大学开源 Spatial-Interactor:首创交互式物理世界空间推理架构,发布 LSI-108K 具身数据集

浙江大学计算机学院 OmniAI 实验室(@huggingface)联合产业界正式开源了 Spatial-Interactor 空间推理架构与大规模交互式空间数据集 LSI-108K(arXiv: 2609.23038)。针对传统视觉语言模型(VLM)停留在静态被动图像识别、面对三维物理世界中深度、遮挡与动态位姿极易发生严重空间幻觉的难题,Spatial-Interactor 首次构建了“动作改变视角、多视角迭代闭环校准”的交互式空间推理机制,全面开源代码与 Apache 2.0 权重。

浙江大学开源 Spatial-Interactor:首创交互式物理世界空间推理架构,发布 LSI-108K 具身数据集

核心要点速览

  • 告别静态单帧看图推测,首创通过机械臂/相机主动多角度交互消除三维空间几何盲区。
  • 开源业界首个高质量交互式空间推理数据集 LSI-108K,覆盖 10.8 万组闭环交互轨迹与空间问答对。
  • 在具身物体定位、三维包围框估计与复杂障碍物避让任务中,三维空间推理准确率平均提升 33.8%。
  • 全量训练代码、评测基准与模型权重已在 GitHub 和 Hugging Face 遵照 Apache 2.0 协议开源。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Spatial Interactor⚡ Qwen 2 Vl🤖 embodied-agent🌐 zhejiang-university

FLEET 框架开源:利用 Logits 信息熵动态引导大模型生成轨迹,代码生成通过率提升 14.8%

AI 研究团队在 Hugging Face 与 ArXiv(论文编号 2609.27657)正式发布并开源了 FLEET(From Logits Entropy to Enhanced Trajectories)框架。针对大语言模型在长代码生成与数学定理推导中极易陷入局部幻觉循环的瓶颈,FLEET 通过在前向传播中实时监测未归一化 Logits 的信息熵分布,自适应动态调整束搜索(Beam Search)与采样温度,将长程生成的错误累积率降低了 38%,代码单元测试通过率显著提升 14.8%。

FLEET 框架开源:利用 Logits 信息熵动态引导大模型生成轨迹,代码生成通过率提升 14.8%

核心要点速览

  • 创新性地利用模型原生 Logits 信息熵作为实时不确定性度量指标,无需外挂评判模型。
  • 根据每步生成的信息熵波动自适应调节采样温度与前缀分支修剪,从源头抑制幻觉雪崩。
  • 在 HumanEval-X 多语言代码生成及 GSM8K 复杂数学推理实测中,一次性通过率提升 14.8%。
  • 框架代码已全面在 GitHub 开源,提供即插即用的 Hugging Face Transformers 与 vLLM 解码扩展钩子。
阅读全文
关联模型 / 智能体 / 厂商: