AI 编程实时动态与要闻

MiniMax 正式发布 M3.1 Flash 并于 10 月 23 日开放权重:428B 总参 / 23B 激活,每百万 token 输入 $0.15、输出 $0.60,DeepSWE 73.7%

MiniMax 官方确认,此前在 OpenRouter 等榜单上用量领先的匿名模型 Space Bunny 就是 M3.1 Flash 的早期版本,并于 10 月 19 日正式上线 API。按量计费为输入 $0.15、输出 $0.60、缓存读 $0.015(每百万 token),1M 上下文,支持文本、图片和视频输入,可用 effort 调节思考深度。官方口径:成本是 M3 的 1/3、速度 3 倍,DeepSWE 73.7%、Automation-Bench 62.2%;10 月 23 日权重已按期在 Hugging Face 开放(MiniMax Community 许可,MXFP8),Together、Inferact(vLLM)、LightSeek TokenSpeed 首日支持。

MiniMax 正式发布 M3.1 Flash 并于 10 月 23 日开放权重:428B 总参 / 23B 激活,每百万 token 输入 $0.15、输出 $0.60,DeepSWE 73.7%

核心要点速览

  • 官方定价(按量):输入 $0.15 / 输出 $0.60 / 缓存读 $0.015 每百万 token;按单价是 M3($0.30/$1.20)的一半,官方「1/3 成本」未说明计算口径。
  • 官方跑分:DeepSWE v1.1 73.7%(Opus 5 为 74.0%)、Automation-Bench 62.2%、BabyVision(带工具)91.0%、Terminal Bench 4.0 38.1%(Opus 5 为 51.8%)。
  • 1M 上下文,文本/图片/视频输入,effort 五档 low 到 max,默认 max,思考不能关闭。
  • 10 月 23 日权重已开放:Hugging Face MiniMaxAI/MiniMax-M3.1-Flash,非 gated,MiniMax Community 许可(非 MIT/Apache),MXFP8 量化,原生多模态 MoE,总参约 428B、每 token 激活 23B,自带 DSpark 投机解码草稿头。
  • 迁移提醒:M2.5/M2.7 自 10 月 19 日起不再对新用户开放,11 月 18 日下线;M Plan 与 Token Plan 的请求已自动路由到 M3.1 Flash。
  • 首日部署:Together AI 托管上线,MiniMax 与 Inferact 合作把生产推理改进回馈 vLLM,LightSeek 的 TokenSpeed 也提供首日支持。
阅读全文

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

半导体分析机构 SemiAnalysis 发布最新评测:Inferact(vLLM 核心团队)联合 Google 正式提交了首份基于 Google TPUv7 的 Kimi K3 2.8T 巨型 MoE 模型推理基准。在单芯片时租仅 1.21 美元(相比 GB300 2.31 美元、B300 2.26 美元、GB200 1.86 美元)下,借助 TorchTPU vLLM 大核与 TPU-Sync KVCache 卸载库,TPUv7 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X。

SemiAnalysis 披露 Google 与 Inferact 首份 TPUv7 评测:TorchTPU vLLM 大核驱动 2.8T Kimi K3,高交互吞吐力压 GB200 NVL72 与 B300

核心要点速览

  • Inferact(vLLM 核心团队)联合 Google 提交首份 Google TPUv7 Kimi K3 2.8T 巨型 MoE 推理基准
  • TPUv7 单芯片时租仅 1.21 美元,显著低于 GB300(2.31 美元)、B300(2.26 美元)与 GB200(1.86 美元)
  • 在 390 tok/s 超高交互区实现每美元 220 万 Token 吞吐,TCO 表现越级反超 NVIDIA GB200 NVL72、B300 与 AMD MI355X
  • 基于 TorchTPU vLLM 大核与 TPU-Sync KVCache 库,标志着 vLLM 在 Google TPU 架构上取得生产级重大突破
阅读全文
关联模型 / 智能体 / 厂商:

SemiAnalysis 拆解 AgentX 13 亿 Token/$ 纪录:vLLM 联合 Inferact 分离式架构较 B300 聚合模式飙升 4 倍,Cline 揭秘多 Harness 强化学习红利

权威半导体与 AI 算力研究机构 SemiAnalysis 披露了 AgentX 基准实现每美元 TCO 产出 13 亿 Token 的底层架构细节:vLLM 联合 Inferact 采用预填充/解码分离式推理(Disaggregated Serving),在超大规模云商批量计价下单位成本性能达到 NVIDIA B300 聚合式(Aggregated)部署的 4 倍;与此同时,开源编程智能体 Cline 公布实测,指出 DeepSeek-V4.1-Flash-1017 仅靠在多套异构 Coding Agent Harness 上扩展强化学习,便以低 17 倍的成本在 Terminal-Bench 上击败 GPT-5.6-Sol、较前代提分 35%。

SemiAnalysis 拆解 AgentX 13 亿 Token/$ 纪录:vLLM 联合 Inferact 分离式架构较 B300 聚合模式飙升 4 倍,Cline 揭秘多 Harness 强化学习红利

核心要点速览

  • SemiAnalysis 实测确认:vLLM 联合 Inferact 采用预填充/解码分离式架构,在 AgentX 上实现每美元 TCO 产出 13 亿 Token,性价比达 NVIDIA B300 聚合式配置的 4 倍
  • Cline 官方实测指出 DeepSeek-V4.1-Flash-1017 在 Terminal-Bench 上较前代跃升 35%,以低约 17 倍的成本击败 GPT-5.6-Sol
  • 这一 35% 的性能跃升在“零算法创新”下完成,核心归功于在多套真实 Coding Agent Harness 上直接进行强化学习后训练
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

vLLM 团队联合 Inferact、Red Hat 与 NVIDIA 于 10 月 9 日发布 Rubin 早期支持:基于 CUDA 13.4 的每日镜像已可在 Vera Rubin NVL72 上服务 DeepSeek、Kimi、GLM、MiniMax。官方口径下,SemiAnalysis AgentX 上 MiniMax M3 同等交互性单卡吞吐最高为 GB200 的 7.84 倍;MLPerf Inference v6.1 的 VLM 项上 Qwen3-VL-235B-A22B 相对 GB300 NVL72 最高 3.7 倍。

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

核心要点速览

  • 硬件对比 GB200 NVL72:NVFP4 算力 5 倍、HBM4 带宽约 2.4 倍、NVLink 双向带宽 1.7 倍,softmax 指数运算快 2–4 倍(vLLM 博文)
  • AgentX + MiniMax M3:同等交互性单卡吞吐最高 7.84 倍,150 TPS 约束下 5.18 倍(官方口径,早期结果)
  • MLPerf Inference v6.1:Qwen3-VL-235B-A22B 经 vLLM + Dynamo,相对 GB300 NVL72 最高 3.7 倍
  • CUDA 13.4 locality domain 拆分 MoE 权重,小 token decode 场景 MoE 层平均提速约 1.2 倍
  • 开箱镜像:vllm/vllm-openai:cu134-nightly(CUDA 13.4 + PyTorch 2.15)
阅读全文
AD赞助内容

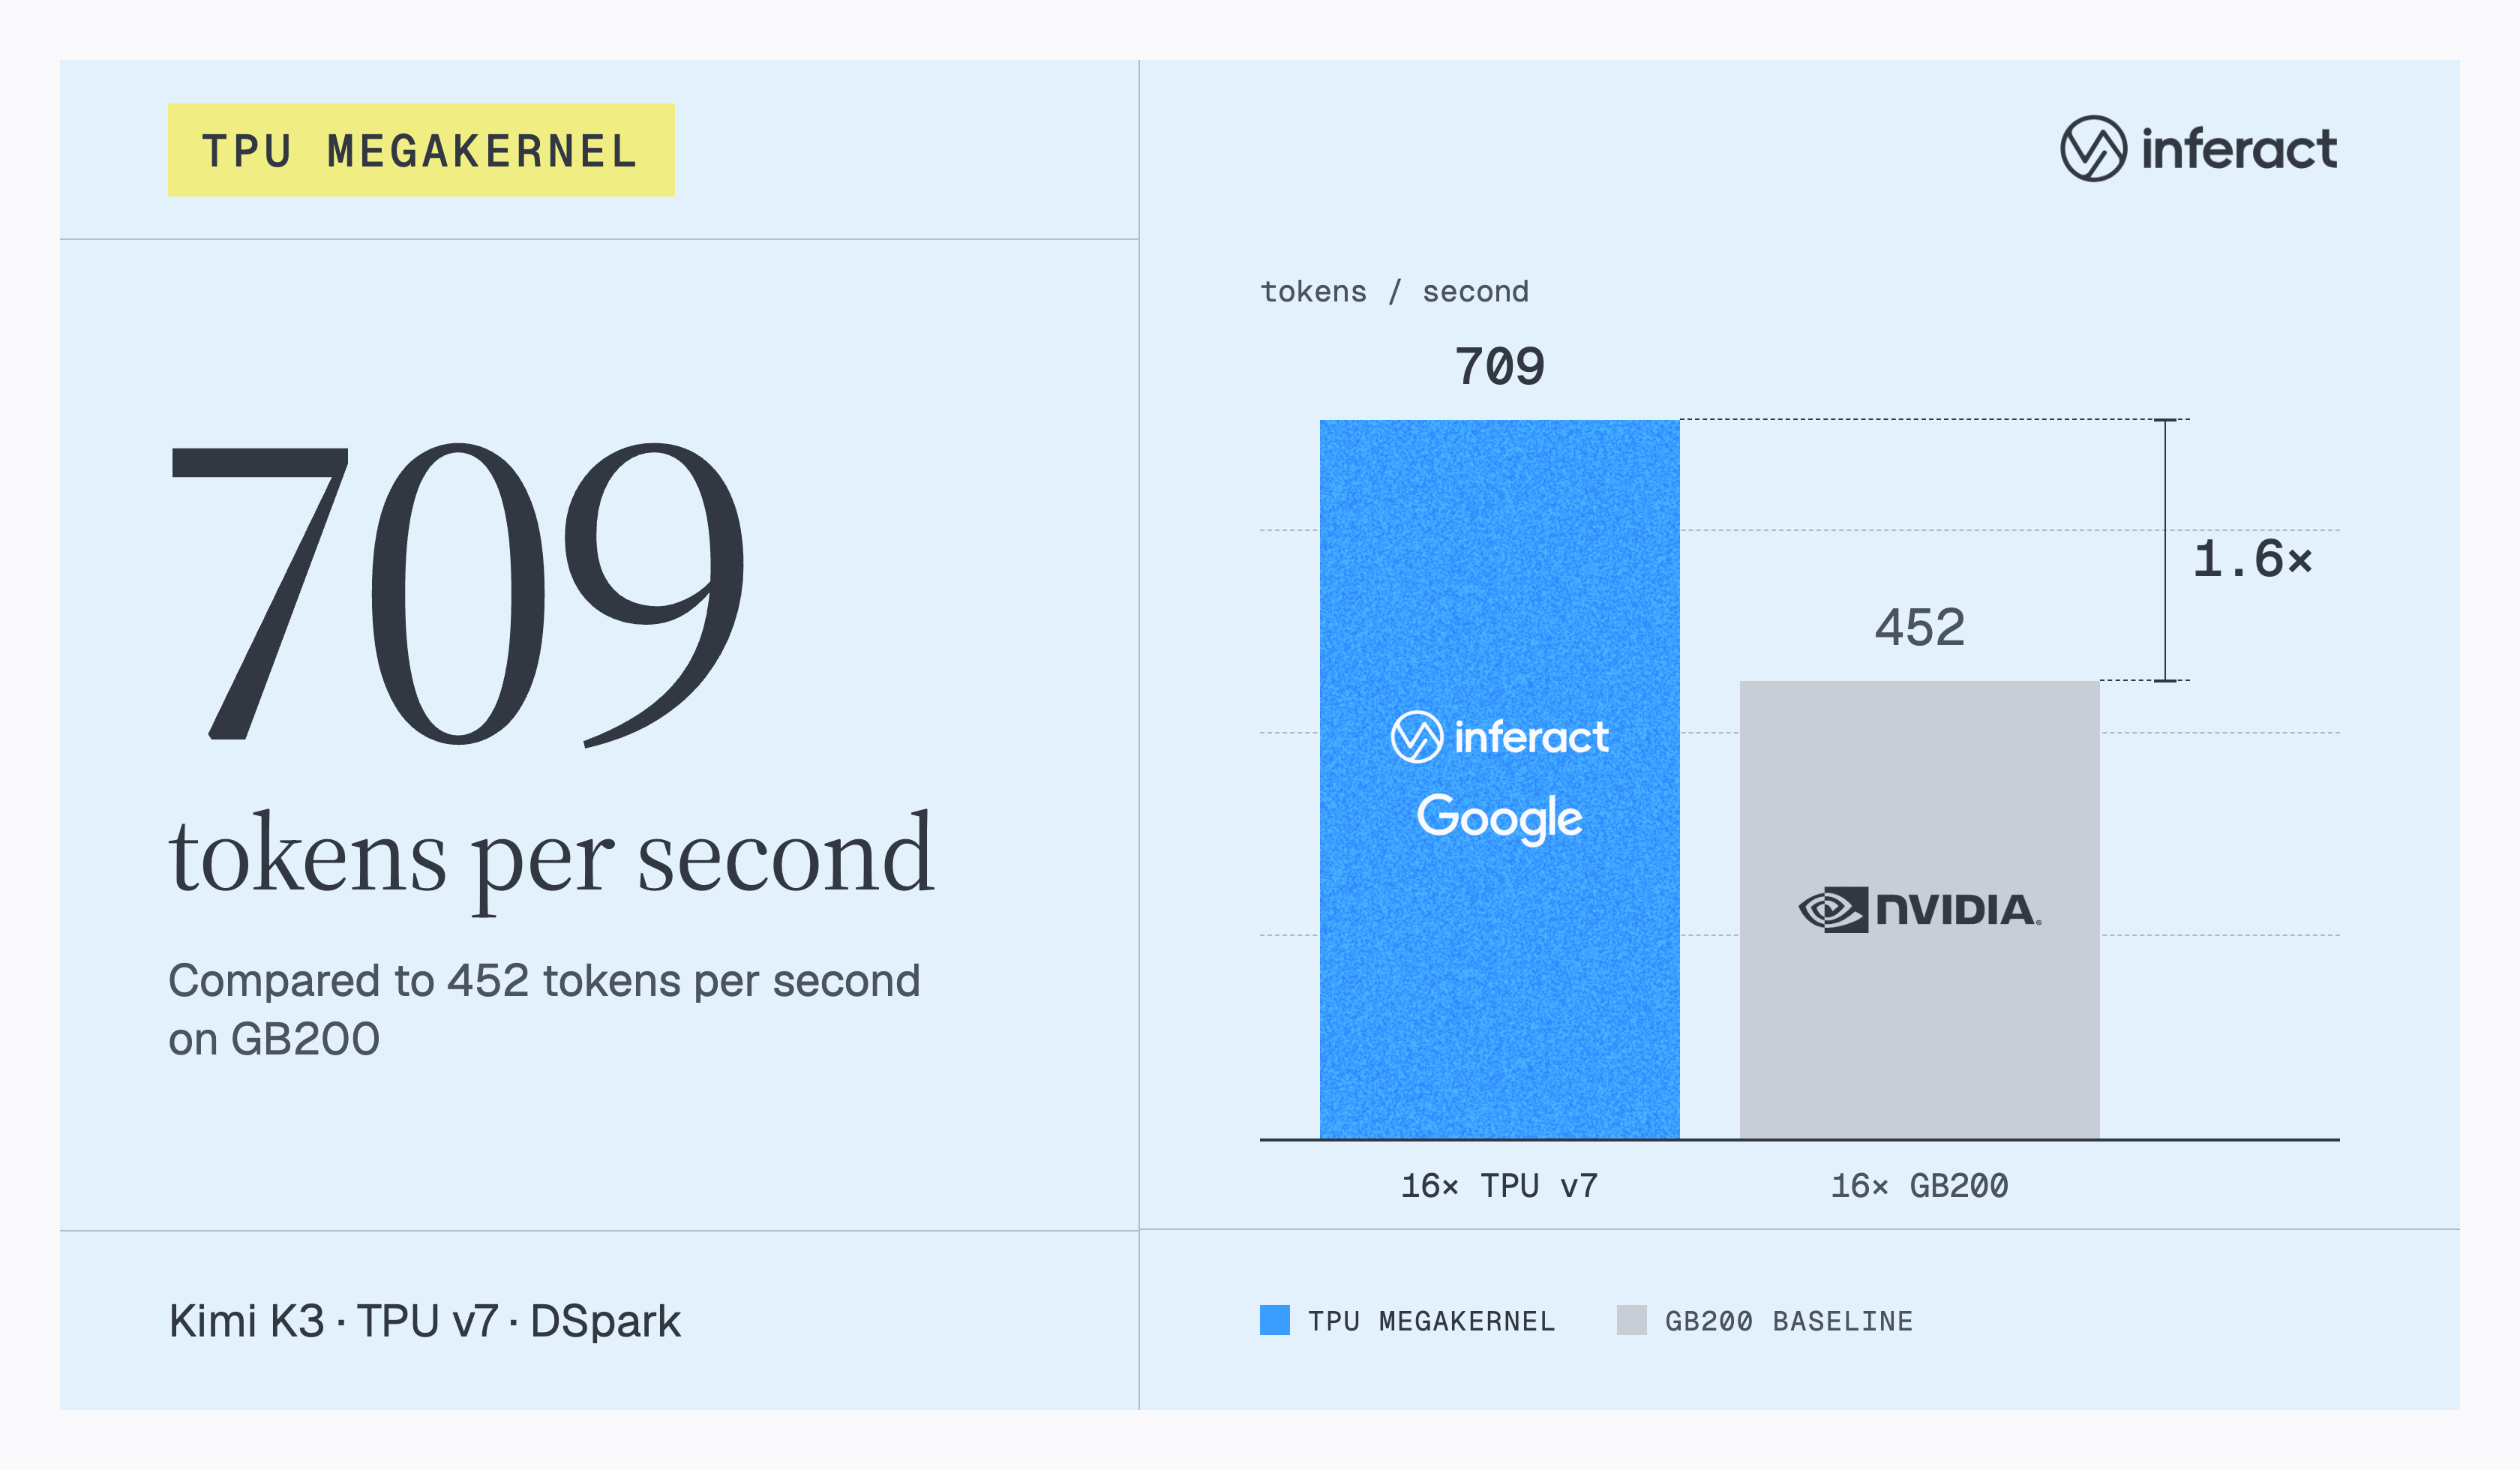
Inferact 开源 TPU Megakernel:Kimi K3 在 16×TPU v7 上跑出 709 tok/s,低并发反超 GB200

Inferact(vLLM 核心团队衍生公司)于 2026-09-23 发布并开源面向 TPU v7 的推理巨内核仓库 inferact/tpu-megakernels。官方博客显示,在 DSpark 推测解码(acceptance length=6)的低并发设定下,Kimi K3 在 16×TPU v7 Ironwood 上达到 709 tok/s,对照 16×GB200 基线 452 tok/s;关闭推测解码时,batch 1–8 约为 GB200 基线的 1.4–2×。整套 Kimi K3 的 92 层 MoE 解码被收敛进单一 Pallas 内核。

Inferact 开源 TPU Megakernel:Kimi K3 在 16×TPU v7 上跑出 709 tok/s,低并发反超 GB200

核心要点速览

  • 官方数字(Inferact 自测,非第三方复现):Kimi K3 + DSpark 在 16×TPU v7 上 709 tok/s,对照 16×GB200 452 tok/s(acceptance length=6)
  • 关闭推测解码时,batch 1–8 约为 GB200 基线的 1.4–2×;Qwen 3.8 27B 在 4×TPU v7 上报 1,515 tok/s vs 4×GB200 695 tok/s(含推测解码)
  • 架构要点:92 层 MoE 装进 单一 Pallas 巨核,跨层 weight prefetch,吃满 TPU 大容量 VMEM
  • 开源仓库:Inferact/tpu-megakernels(Apache-2.0),配套深度文:700 TPS on Kimi K3
阅读全文
关联模型 / 智能体 / 厂商:

Google Cloud 与 Inferact 合作:把 TPU 做成 vLLM 一等公民,并开源生产级服务路径

Inferact(@inferact)宣布与 Google Cloud 共同推进 TPU 在 vLLM 中的一等支持:统一工程路线覆盖生产服务与优化内核、经 TorchTPU 的原生 PyTorch 路径,以及前沿模型 Day-0 支持;并启动社区计划提供共享 TPU 容量与核心维护者评审,产出全部开源。

核心要点速览

  • Google Cloud + Inferact:把 TPU 做成 vLLM 一等公民。
  • 路线含生产服务/内核、TorchTPU 与前沿模型 Day-0 支持。
  • 社区共享 TPU 容量;协作产出全部开源。
阅读全文
关联模型 / 智能体 / 厂商: