AI 编程实时动态与要闻

微软研究院与 UC Berkeley 开源 TokenEconomizer:不改 Agent,让 Claude Code、Codex 在 SWE-Bench 上成本降 18.4%–30.9%

微软研究院、微软安全团队与 UC Berkeley 在 GitHub 开源 TokenEconomizer(Apache 2.0,v0.1.0 于 10 月 26 日发布),它是 Claude Code、Codex、GitHub Copilot CLI 和 Pi 的插件,opencode 为实验支持。插件从同一仓库的历史会话中学习,用「微技能」记住仓库事实、裁掉长期不用的工具定义、在 Agent 原地打转时提醒换路。论文称在 277 个 SWE-Bench 任务上,五种 Agent 与模型组合的平均成本降低 18.4%–30.9%(论文口径)。

微软研究院与 UC Berkeley 开源 TokenEconomizer:不改 Agent,让 Claude Code、Codex 在 SWE-Bench 上成本降 18.4%–30.9%

核心要点速览

  • 成本:277 个 SWE-Bench 任务、6 个仓库、5 种 Agent 与模型组合,平均成本降 18.4%–30.9%,30 个「仓库×组合」格子全部更便宜(论文口径,含插件自身调用费用)
  • 成功率:Pass@1 在 5 个组合中 4 个上升,例如 Copilot CLI + Sonnet 5 成本降 18.4%、Pass@1 +2.6;Claude Code + Opus 4.8 成本降 30.9%、Pass@1 −1.0
  • 三个机制:微技能(三次会话确认后才写入的仓库事实)、工具裁剪(默认 10 次提示且跨 2 次会话未用即移除)、死循环干预(判定置信度 ≥0.7 时提醒一次,不会自动中止)
  • 泛化:Web-Bench 上成本降 16%–21%,两个安全审计基准(每题都是新仓库)降 6%–20%
  • 部署:Apache 2.0,Python 3.10+,无需额外 API key,学到的经验只存本机 ~/.tokeneconomizer
阅读全文

微软亚研院开源 WildAWM:野外环境通用智能体世界模型,重构 GUI 与网页端到端仿真底座

微软亚洲研究院(MSRA)研究团队在 arXiv:2610.26828 正式发布并开源通用智能体世界模型 WildAWM(MSR-Orchard/WildAWM)。针对当前跨平台 GUI 与网页浏览智能体(Computer-Use Agents)在训练和评测中高度依赖昂贵、慢速且不可撤销的真实物理沙盒环境的痛点,WildAWM 首创可适应野外复杂异构环境的多模态自回归世界模型架构。模型能够在接收任意智能体动作(点击、输入、滚动)后,极其逼真地预测网页与桌面操作系统下一帧的高保真视觉状态演化与 DOM 结构变化,成功替代物理沙盒,为大规模自主智能体的离线强化学习与安全预演树立了全新基座。

微软亚研院开源 WildAWM:野外环境通用智能体世界模型,重构 GUI 与网页端到端仿真底座

核心要点速览

  • 微软亚研院在 arXiv:2610.26828 开源 WildAWM,首创面向真实野外复杂环境(桌面/Web)的智能体世界模型
  • 彻底破解 GUI 智能体训练依赖真实物理服务器与网页环境造成的昂贵算力开销和状态破坏风险
  • 基于动作条件(Action-Conditioned)的多模态自回归架构,精准仿真点击、键盘输入与长页面滚动后的视觉响应
  • 在跨电商、CRM 与操作系统多项仿真一致性评测中大幅超越传统离散状态转移模型,全面开源代码与权重
阅读全文

阿里淘天公布日产百万级多智能体生成架构 CommerceGen-Studio:6B SKU-DiT 击败 20B 开源模型与 Nano Banana Pro,微软提出测试时多样性对齐 MSR

阿里巴巴淘天集团发表生产级多智能体商业视觉生成系统 CommerceGen-Studio(arXiv:2610.20603,HF 52 赞),通过 PERL-Agent 闭环自进化与 6B 参数 SKU-DiT(RDR 三阶段强化蒸馏),支撑日均数百万张秒级生成,并在真实流量基准 CommerceGen-Bench 上以 9.43/9.45 分击败 20B Qwen-Image-Edit 及闭源 Nano Banana Pro;同期微软研究院提出 Mine, Sample, Render(MSR,arXiv:2610.21185),在测试时外置统计采样彻底解决大模型生成同质化(Mode Collapse)。

阿里淘天公布日产百万级多智能体生成架构 CommerceGen-Studio:6B SKU-DiT 击败 20B 开源模型与 Nano Banana Pro,微软提出测试时多样性对齐 MSR

核心要点速览

  • 阿里淘天 CommerceGen-Studio(arXiv:2610.20603)在生产环境支撑日均数百万张商品视觉生成、单图延迟仅数秒
  • 通过 Reinforce-Distill-Reinforce(RDR)训练的 6B 参数 SKU-DiT 在 CommerceGen-Bench 单图/多图任务上斩获 9.43 / 9.45 分,越级击败 20B Qwen-Image-Edit(8.67 / 7.48)与闭源 Nano Banana Pro(9.39 / 9.33)
  • 配合 PERL-Agent(Prompt-Eval-Refine-Loop)自进化闭环与 Layout Thinker Optimization 后,综合得分进一步提升至 9.62 / 9.48
  • 微软研究院提出 Mine, Sample, Render(MSR,arXiv:2610.21185),通过从真实语料挖掘分类属性并在测试时显式采样,无需训练即可消除网页 UI 设计、智能体 3D 资产合成等五大场景的模式坍塌
阅读全文
关联模型 / 智能体 / 厂商:

微软与斯坦福发布 AutoEnvScaling:终端 Agent 自动构建 RL 环境,效率狂飙 25 倍迈向 RSI 自进化

微软研究院(MSR)与斯坦福大学联合发布 AutoEnvScaling,首次将强化学习交互环境的设计本身转化为终端任务,利用提案智能体(Proposer)与求解智能体(Solver)的协同构建自动化数据飞轮。相比纯 Prompt 生成,环境有效率暴增高达 25 倍,单环境构建成本降低 75%。更关键的是,让单一模型(Qwen3.6-35B-A3B)同时扮演设计者与求解者,实现递归自我提升(RSI),在 Terminal-Bench 2.1 提升 12.2 分,Terminal-Bench 4.0 跑分翻倍。

微软与斯坦福发布 AutoEnvScaling:终端 Agent 自动构建 RL 环境,效率狂飙 25 倍迈向 RSI 自进化

核心要点速览

  • 环境设计终端化:首次将强化学习环境的合成从人工编写转化为终端自动化任务,有效环境生成率提升 25 倍且单环境成本降低 75%
  • 解锁真正的递归自我提升(RSI):单一模型同时扮演环境提出者与任务求解者角色,自驱动共同进化,无需人工干预即可打破数据瓶颈
  • 跨领域通用泛化:在 Qwen3.6-35B-A3B 上实现 Terminal-Bench 2.1 大涨 12.2 分、Terminal-Bench 4.0 翻倍,并广泛扩展至 GPU 内核编程与系统运维
阅读全文
AD赞助内容

微软开源 CABRA 基准:代码理解是 Coding Agent 核心瓶颈,深层语义比代码修改行数更具决定性

随着 Coding Agent 在 SWE-bench、HumanEval 等基准上的跑分屡破新高,工业界普遍陷入一种误区:认为只要给智能体挂载终端工具与代码搜索器(如 grep、ripgrep),代码解决能力就仅取决于修改规模的大小。然而,真实工业软件交付中,Agent 常常在微小的代码改动上遭遇溃败。微软研究院(Microsoft Research)在最新重磅研究(arXiv:2610.10610)中发布了严苛的评测蓝图基准 CABRA(开源代码:github.com/microsoft/CABRA)。CABRA 彻底剥离了传统基准中任务难度与代码修改行数的混乱交织,将程序建模为有向无环图(DAG),并沿四大正交维度(函数跨度遍历、噪声函数搜索、运行时依赖解算、复杂指令遵循)以参数 n 进行精确复杂度缩放。评测揭示了颠覆性的核心真相:智能体在处理简单语法修改时极为熟练,但在需要深度代码理解(Code Understanding)的复杂依赖追踪时表现断崖式暴跌;且统计证明,Agent 在‘代码理解类工具(READ、ANALYZE)’上消耗的 Token 数量和调用频次,比修改的代码行数更能精准预测其在 SWE-bench Verified 真实场景下的表现,官方代码与评测集现已开源。

微软开源 CABRA 基准:代码理解是 Coding Agent 核心瓶颈,深层语义比代码修改行数更具决定性

核心要点速览

  • 微软开源 CABRA 基准,基于有向无环图(DAG)合成代码库,首次精确解耦代码理解与编辑行数
  • 实测证实代码理解是 Coding Agent 核心瓶颈,深层函数遍历使现有前沿模型通过率断崖式暴跌 50%~78%
  • 智能体在理解类工具(READ/ANALYZE)上的消耗对 SWE-bench Verified 表现的预测力显著超越代码编辑量
阅读全文
关联模型 / 智能体 / 厂商:

测试时自我进化新纪元!AREX-2 框架开源:长程反思任务驱动持续迭代,MLE-bench 狂揽 81.8 分

智能体在推理部署时的自我迭代升级能力(Test-Time Self-Improvement),是当前迈向 AGI 的核心演进方向。这一能力依赖两大互补支柱:能够敏锐识别错误并产出更优解的“反思(Reflection)”,以及能支撑算法经历多轮长时间交互而不发生上下文崩溃的“长程执行(Long-Horizon Execution)”。中国人民大学、微软亚洲研究院与中国科大团队联合推出了 AREX-2 框架:研究团队发现这两种核心能力具备极强的领域无关通用性(Domain-Agnostic),并通过在具备确定性结果校验的机器学习工程(ML Engineering)与算法编程任务中,合成了极具挑战的长程反思训练轨迹。基于 Qwen3.8-27B 打造的 AREX-2 智能体在 MLE-bench Lite 上斩获 81.8 的超高分,并零样本跨域迁移至深度研究(Deep Research)任务,在 BrowseComp 斩获 84.0 分、GAIA 斩获 92.2 分、DeepSearchQA 斩获 93.8 分,展现出随着迭代轮数增加而持续单调提升的强大自进化力。

测试时自我进化新纪元!AREX-2 框架开源:长程反思任务驱动持续迭代,MLE-bench 狂揽 81.8 分

核心要点速览

  • 提出测试时自我进化的两大领域无关支柱:高质量可验证反思与超长程执行连贯性
  • 基于 Qwen3.8-27B 打造的智能体在 MLE-bench Lite 斩获 81.8 分,Frontier-CS 斩获 70.7 分
  • 零样本成功迁移至深度研究任务,GAIA 达 92.2 分,DeepSearchQA 达 93.8 分,BrowseComp 达 84.0 分
阅读全文

告别扁平化文档盲目搜寻!KAIST 推出 CorpusMap 实体图谱导航层:为智能体检索锚定全局实体,多跳证据召回开销大幅缩减

在大规模企业私有知识库与多文档代码工程中,回答复杂多跳问题通常需要将分散在不同文件中的碎片化证据严密串联(如将立项审批、需求设计与最新上线状态三者关联)。当代大模型检索智能体(Search Agent)在面对扁平化的海量文档时,只能盲目发起多轮关键词或向量检索,由于单个文档无法提供与其他文件的关联脉络,智能体在每次遇到新问题时都被迫重新穷举探索,不仅频繁遗漏关键互补证据,更在冗余交互中烧毁海量 Token。韩国科学技术院(KAIST)联合微软研究院团队推出 CorpusMap 实体图谱导航层:在离线阶段自动抽取并对齐整个文档集中反复出现的核心实体(Entity),为每个实体构建聚合页面(Entity Page)并双向链接所有提及它的原始文档。在检索时,智能体只需沿着实体图谱进行拓扑漫游,即可一站式捞取分散在全库的关联事实。实测表明,CorpusMap 在显著减少 Token 消耗的同时大幅提高证据召回完整度,全面击败包含纯扁平检索在内的 4 种替代导航架构。

告别扁平化文档盲目搜寻!KAIST 推出 CorpusMap 实体图谱导航层:为智能体检索锚定全局实体,多跳证据召回开销大幅缩减

核心要点速览

  • 离线实体图谱终结在线盲目探索:通过离线实体消歧与对齐构建跨文档 Entity Page,将扁平死板的文件库升维为带拓扑连接的导航图谱,避免智能体每轮查询时重复探索关系。
  • 显著压降检索 Token 消耗:智能体无需多次调用大模型进行漫无目的的宽表盲搜,沿着实体聚合页直接获取精准互补证据,大幅降低单次复杂多跳问答的端到端 Token 开销。
  • 7 大主流模型一致验证:在 3 个多文档硬核基准上实测,CorpusMap 全面超越原始文档检索并击败 4 种主流导航层基线,证实实体是连接异构知识孤岛最坚固的语义锚点。
阅读全文

攻克超长时序智能体“语义抖动”!VideoLoop 提出双循环工作记忆架构:Gemini 3.1 Pro 跑分跃升至 88.3%

在长达数小时的长视频理解与长程时序智能体决策中,模型必须通过数十步推理连续收集跨片段证据。然而现有方法普遍采用“仅追加”(Append-Only)的工作记忆模式,随着上下文不断塞入新观测,核心证据的注意力迅速坍缩,智能体无法有效调取先前已发现的关键事实——这种系统性记忆失调现象被正式命名为“语义抖动”(Semantic Thrashing)。罗切斯特大学与微软研究院团队推出 VideoLoop 双循环工作记忆智能体:设计了外层全局推理循环与内层工作记忆重写循环。内层循环在每一步后从无边界文件系统中按需检索历史观测与中间分析,并在有限大小的工作记忆中动态执行提炼与覆写。VideoLoop 作为即插即用框架覆盖四大主流大模型底座,在 VideoMME(长视频)基准上平均提升 4.2 个百分点,配合 Gemini 3.1 Pro 达到 88.3% 历史新高,彻底根治了超长时序智能体的上下文注意力崩溃难题。

攻克超长时序智能体“语义抖动”!VideoLoop 提出双循环工作记忆架构:Gemini 3.1 Pro 跑分跃升至 88.3%

核心要点速览

  • 首次形式化定义“语义抖动”(Semantic Thrashing):严格证明了仅追加式(Append-Only)线性记忆架构在没有显式重写算子(Rewrite Operator)的情况下,无法从根本上消除噪声累积与注意力分散。
  • 内外双循环工作记忆系统:外层负责宏观时序推理,内层在每步结束后从无限制外部文件系统索引历史切片,并将当前上下文覆写精炼为一个有界(Bounded)的高信噪比工作记忆。
  • VideoMME 斩获 88.3% 破纪录得分:在 VideoMME 长视频最难的 25% 题目上,仅读工作记忆的盲审模型准确率从 60.9% 暴涨至 81.1%;结合 Gemini 3.1 Pro 斩获 88.3%,并在 VideoMMMU 达 88.8%。
阅读全文

微软与 ServiceNow 推出 FrogNano:仅 4B 参数的高能代码 Agent,纯 RL 动态任务合成实现端侧落地

微软研究院与 ServiceNow Research 联合团队正式发布专为端侧低资源环境打造的轻量级代码智能体 FrogNano(arXiv:2609.07925)。不同于传统依赖千亿大模型蒸馏(Distillation)小模型的做法,FrogNano 仅含 40 亿(4B)参数,且完全仅通过强化学习(RL)在约 1,500 个复杂的软件工程沙箱环境中后训练完成。其核心技术突破在于构建了一套自适应在线任务合成流水线(Online Task Synthesis),能够根据当前 Checkpoint 的学习能力边界动态生成难度恰到好处的合成代码任务。实验证明,小型模型完全无需依赖大模型输出即可自主进化出极高水平的软件工程代码调试与工具调用能力。

微软与 ServiceNow 推出 FrogNano:仅 4B 参数的高能代码 Agent,纯 RL 动态任务合成实现端侧落地

核心要点速览

  • 极致轻量化 4B 规模:以仅 40 亿参数的小巧体量具备完整的终端交互、环境探索与代码重构能力,可在单张消费级显卡或 Mac 上本地运行
  • 抛弃传统知识蒸馏:摆脱对 GPT-4 等千亿闭源前沿模型伪代码轨迹的依赖,纯粹依靠强化学习自我博弈与环境执行反馈进化
  • 动态可学习性边界合成:任务生成器根据模型当前阶段动态调整题目难度,杜绝任务过难导致梯度弥散或过易导致过拟合
  • 1500+ 真实工程沙箱:覆盖 Python、多语言包管理与测试框架,强化模型面对真实报错时的鲁棒恢复与多轮调试韧性
  • 端侧高性价比工程范本:为企业级私有化本地代码辅助、离线敏感内网研发提供了不妥协代码质量的超轻量解决方案
阅读全文
关联模型 / 智能体 / 厂商:

微软研究院发布 CASD:让 Coding Agent 作为提示词自优化器,单次离线分析提速 22 倍且成本仅 1.6 美元

微软研究院(Microsoft Research)Sumit Gulwani 团队联合发表提示词自动化工程突破 CASD(Coding-Agent Skill Distillation,arXiv:2609.26261)。针对现存基于搜索的 Prompt 优化器(如 GEPA、DSPy 等)依赖昂贵在线采样回放(Rollout)、验证数据反复调优以及庞大 API 账单的痛点,CASD 提出了颠覆性范式:仅凭借已有的静态 Agent 执行轨迹库,开箱即用的 Coding Agent 即可自动编写并运行数据分析代码,全局统计失败模式并提炼出高阶行为准则。在 ALFWorld、tau2-bench 与 SpreadsheetBench 等四大基准评测中,单次 CASD 离线优化平均超越未优化基线 16.6 个百分点(大幅领先 GEPA 的 10.9 和 SkillOpt 的 5.3),生成最优 Prompt 成本仅需 1.6 美元,比验证搜索提速节约超 22 倍。

微软研究院发布 CASD:让 Coding Agent 作为提示词自优化器,单次离线分析提速 22 倍且成本仅 1.6 美元

核心要点速览

  • 零在线交互与环境访问:仅凭离线静态轨迹日志即可完成高精度提示词优化,无需挂载模拟沙箱环境与在线 Rollout 采样
  • 单次优化成本仅 1.6 美元:相比传统验证驱动搜索动辄 35~50 美元的巨额 API 消耗,CASD 单次分析将成本暴降超 22 倍
  • 性能全面压制 SOTA:平均准确率提升 16.6 个百分点,显著超越前沿优化器 GEPA(+10.9%)与 SkillOpt(+5.3%)
  • 全局统计代码反思机制:Agent 自行编写 Python 脚本对全库轨迹进行聚类与频次分析,克服小 Batch 观察的局部短视偏差
  • 四大基准跨域泛化验证:在 ALFWorld 具身环境、tau2 零售/电信双场景及 SpreadsheetBench 表格推理中均取得显著增益
阅读全文
AD赞助内容

微软研究院开源 Agensh:无中心调度的多智能体编码框架,最多 1,024 个 Agent 协作

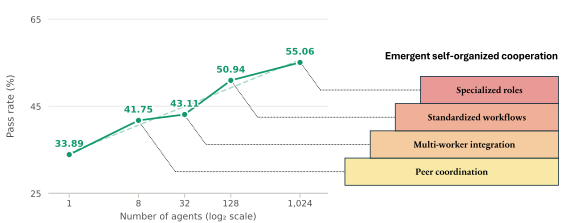
微软亚洲研究院(MSRA)研究员、论文共同一作 Zhihao Zhan 于 10 月 24 日在 X 上宣布开源 Agensh(MIT 协议)。它是一套没有中心调度 Agent 的多智能体编码框架,各 Worker 自行认领子任务、验证并异步合并进度;官方口径下,在 pandoc 任务上从 1 个扩到 1,024 个 Agent,最终测试通过率由 33.89% 升至 55.06%。

微软研究院开源 Agensh:无中心调度的多智能体编码框架,最多 1,024 个 Agent 协作

核心要点速览

  • 10 月 24 日开源 harness、实验启动脚本与复现指南,MIT 协议,代码见 microsoft/Agensh。
  • 官方口径:ProgramBench 最难 5 题、GPT-5.6-sol(high)、6 小时预算、断网条件下,平均最终测试通过率由 1 个 Agent 的 19.31% 升到 128 个的 28.78%,相对提升约 49%。
  • 官方口径:pandoc 任务 1 → 128 → 1,024 个 Agent,通过率 33.89% → 50.94% → 55.06%。
  • 协作基础设施:Gitea 做共享工作区、Mattermost 做消息、共享上下文机制改编自 DeLM;每个 Agent 的单体循环基于 Copilot harness。
  • 本次发布包含 Docker Compose 单节点团队环境和单 Agent 基线,均使用原生 Copilot ACP 会话。
阅读全文