AI 编程实时动态与要闻

微软开源 4B 电脑操作智能体 Mage-VL-Cowork:一个模型自己决定点界面还是写 bash,OSWorld-Verified 66.0%

微软 Mage 团队 10 月 30 日在 Hugging Face 以 Apache-2.0 发布 Mage-VL-Cowork:4B 参数的多模态电脑操作智能体,同一个模型每一步自己选择用截图点界面(computer_use)还是在终端跑 bash/Python,不需要外部调度器。官方报告它在 OSWorld-Verified(361 题、50 步上限)两次平均 66.0%,高于 Qwen3.6-27B 的 63.9%,但仍低于 9B 的 SCALECUA-Qwen3.5-9B(68.7%)。

微软开源 4B 电脑操作智能体 Mage-VL-Cowork:一个模型自己决定点界面还是写 bash,OSWorld-Verified 66.0%

核心要点速览

  • 4B 参数,基于 Mage-VL(Mage-ViT 视觉编码器 + Qwen3-4B-Instruct-2507),bf16 权重约 9.48 GB,Apache-2.0 许可。
  • OSWorld-Verified 两次独立跑分 65.33% 和 66.75%,取平均 66.0%;操作系统类任务 87.5%,多应用工作流 62.7%。
  • 官方对比:同一个 LibreOffice Calc 建图表任务,它用终端里的 Python 改表格 39 秒完成(6 步),纯界面操作的 Qwen3.6-27B 用了 9 分 56 秒(39 步)。
  • 在线 RL 比混合 SFT 再提升 10.16 个百分点,同时平均模型调用次数减少 13.0%、输出 token 减少 25.4%。
  • 训练数据由 Mage-CUA-Forge 生成约 29.4 万个桌面和网页任务,覆盖 6,915 种技能,单任务生成成本从 0.906 美元降到 0.158 美元。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Mage-VL-Cowork⚡ Mage-VL⚡ Qwen3-4B⚡ Qwen3.6-27B🌐 Microsoft

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

美团 LongCat 团队 11 月 2 日在 API 平台更新日志中上线 LongCat-2.5,这是 9 月 25 日 LongCat-2.5-Preview 的正式版。官方技术博客称它总参数 1.6 万亿、每个 token 激活约 480 亿,在 LongCat-2.0 基础上强化原生视觉理解和智能体编程,训练和 W4A4 推理都在国产 AI 加速卡上完成。官方口径成绩包括 Terminal Bench v2.1 88.4、Terminal Bench v4.0 38.5、BrowseComp 91.9、MCP Atlas 83.1。API 支持 OpenAI 和 Anthropic 两种格式,1M 上下文、最多 128K 输出,限时价每百万 token 输入 $0.30、缓存输入 $0.006、输出 $1.20。

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

核心要点速览

  • 规模:1.6 万亿总参数 MoE,每 token 激活约 480 亿;1M 上下文、最高 128K 输出(官方博客、API 文档)
  • 代码智能体(官方口径):Terminal Bench v2.1 88.4(Claude Opus 5 89.1、GPT-5.6-Sol 88.8)、Terminal Bench v4.0 38.5(GPT-5.6-Sol 37.3、Claude Opus 5 53.9)、DeepSWE v1.1 64.6
  • 通用智能体(官方口径):BrowseComp 91.9、MCP Atlas 83.1、AutomationBench v1.0.6 51.8、HLE w/tools 63.1;相比 LongCat-2.0 的 AutomationBench 15.8 大幅提升
  • 价格:限时每百万 token 输入 $0.30(¥2)、缓存输入 $0.006(¥0.04)、输出 $1.20(¥8)(定价页)
  • 工程:W4A4 推理相比 W8A8 基线预填充吞吐 +43.3%、解码吞吐 +42.77%;长序列 SFT 中 FSDP 单卡吞吐比 DDP 基线高 86%
阅读全文

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

半导体与 AI 研究机构 SemiAnalysis 11 月 2 日发布 GDPx,用来衡量前沿模型在芯片设计、网络安全、生物、金融、法律、量化交易、递归自我改进(RSI)、硬件设计、材料科学、对齐和软件工程 11 个领域的智能体能力,共 206 道任务,由 14 家专业数据公司出题、SemiAnalysis 负责最终质检。官网榜单上 Claude Opus 5.5 以 12.0% 居首,Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6% 紧随其后;金融和法律任务几乎所有模型都是 0 分。SemiAnalysis 称 Opus 5.5 和 GPT-6 Astra 的总分被安全分类器拖低,并计划每 3–6 个月更新一版。以上分数均为 SemiAnalysis 口径。

SemiAnalysis 发布 GDPx 智能体基准:11 个高价值领域 206 道任务,最强的 Claude Opus 5.5 也只拿到 12%

核心要点速览

  • 规模:11 个领域、14 家数据合作方、206 道任务,默认单题时限 8 小时(GDPx 官网)
  • 榜单(SemiAnalysis 口径):Claude Opus 5.5 12.0%、Gemini 4 Carbon 10.9%、GPT-6 Astra 9.6%、Muse Wonder Full 9.0%、Claude Fable 5.1 8.5%、GPT 6.1 Sol 8.4%、Claude Sonnet 5.5 8.2%
  • 开源与低价档:DeepSeek 4.1 Flash 1017 5.4%、GPT-6 Luna 5.1%、Grok 4.7 3.9%、GLM 5.3 2.7%;金融和法律任务几乎全部 0 分
  • 评测方法:优先用各家原生 harness(Opus 用 Claude Code、Astra 用 Codex、Carbon 用 Antigravity),没有的用 OpenCode;报告 3 次尝试的 pass@1,各领域等权(SemiAnalysis 博客)
  • 分领域:Opus 5.5 赢量化、硬件和芯片设计;Gemini 4 Carbon 赢生物和软件工程;GPT-6 Astra 赢 RSI 和材料科学;Muse Wonder Full 是最强网安模型
阅读全文

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

独立评测机构 Artificial Analysis 10 月 31 日发布知识与幻觉基准 AA-Omniscience v1.1,作为 Intelligence Index v5 的组成部分。新版题库从 6,000 题精简为 3,000 题,删掉已公开和已饱和的题目、修正错误与歧义并补充新题,同时在 Hugging Face 公开一套 300 题、难度与私有集校准的公开集,两者 Net Score 的 Pearson 与 Spearman 相关系数均为 0.99。结果显示 Gemini 4 Carbon(high)以 54 分领先,Claude Opus 5.5 为 48、Claude Fable 5.1 为 46;Fable 5.1 准确率最高(68%),Gemini 4 Argon 幻觉率最低(4%)。模型平均比 v1 低约 1.9 分,MiniMax M3.1 Flash 下滑 22 分。以上均为 Artificial Analysis 口径。

Artificial Analysis 发布 AA-Omniscience v1.1:题库精简到 3,000 题并公开 300 题校准集,Gemini 4 Carbon 以 54 分领跑知识与幻觉榜

核心要点速览

  • 题库从 6,000 题精简到 3,000 题,覆盖 6 大领域、42 个主题:理工数学 600、软件工程 600,金融、健康、人文社科、法律各 450
  • 新的 300 题公开集已上 Hugging Face,与私有集 Net Score 的相关系数 0.99,中位差 0.0 分
  • Net Score 排名:Gemini 4 Carbon(high)54、Claude Opus 5.5 48、Claude Fable 5.1 46;开源权重最好的是 Muse Spark Open,落后 Gemini 4 Carbon 28 分
  • 准确率最高为 Claude Fable 5.1(68%),其次 Claude Opus 5.5(66%);幻觉率最低为 Gemini 4 Argon(4%)
  • 与 v1 排名的 Spearman 相关 0.98,但平均低 1.9 分;MiniMax M3.1 Flash 从 16 跌到 -6,MiMo V2.6 Pro 从 8 跌到 -5(官方口径)
阅读全文
AD赞助内容

商汤开源 SenseNova-Loop-9B-Preview:9B 循环 Transformer 跑出约 14.6B 的推理深度,主打长上下文与 Agent 工作流

商汤 10 月 30 日在官方 X 账号和 Hugging Face 发布 SenseNova-Loop-9B-Preview(Apache 2.0)。它把 32 层解码器里的第 4–27 层用同一套权重连跑两遍,每次前向执行 56 层计算,存储约 9B 参数、推理参数约 14.6B,并用两路 mHC(流形约束超连接)管理残差流。模型支持文本加图片输入,训练序列最长 262,144 token。官方图表显示它在 BIRD-Dev、WorkBuddy Bench 等多项 Agent 与数据任务上超过 Qwen3.5/3.6 同级模型,但 Terminal Bench 2.1 仍落后;技术报告尚未发布。官方 X 首帖约 910 赞。

商汤开源 SenseNova-Loop-9B-Preview:9B 循环 Transformer 跑出约 14.6B 的推理深度,主打长上下文与 Agent 工作流

核心要点速览

  • 结构:32 个不同解码层、第 4–27 层共享权重循环 2 遍,每次前向共 56 层计算;约 9B 存储参数、约 14.6B 推理参数(模型卡)
  • 官方口径跑分:BIRD-Dev 71.38(Qwen3.5-27B 69.84)、WorkBuddy Bench 66.89(Qwen3.6-35B-A3B 61.98)、AutomationBench 13.72(Qwen3.5-27B 10.17)
  • 短板同样来自官方图表:Terminal Bench 2.1 为 40.45,低于 Qwen3.6-27B 的 47.19;τ³-Banking 18.56,略低于 Qwen3.5-27B 的 19.59
  • 训练上下文最长 262,144 token;混合注意力为每 4 层 3 层线性注意力加 1 层全注意力;已支持 MTP 加速,DSpark/DFlash2 仍在训练
  • Apache 2.0 许可,需 trust_remote_code=True;官方给出 Transformers 5.18.0、LightLLM 4 卡和 SGLang PR 部署示例,技术报告待发布
阅读全文
关联模型 / 智能体 / 厂商:
⚡ SenseNova-Loop-9B-Preview⚡ Qwen3.5-27B⚡ Qwen3.6-35B-A3B🌐 SenseTime

X 与 SpaceXSI 设计负责人 Benji Taylor 开源 Stageshow:让编程 Agent 做出像真产品的假 UI 和动效演示

X 与 SpaceXSI 设计负责人 Benji Taylor 10 月 31 日在 X 上发布 Stageshow:一个给编程 Agent 用的开源 skill(MIT 许可),帮助 Agent 生成更像真实产品的“假 UI”静态图、光标演示动画和 bento 网格,产出是普通 React 组件。一条命令即可安装,作者说适用于 Grok Build、Claude Code、Codex、Gemini 等。首帖约 4,500 赞、6,500 次收藏。作者本人说明它不保证一次成功,多数演示仍需几轮反馈。

X 与 SpaceXSI 设计负责人 Benji Taylor 开源 Stageshow:让编程 Agent 做出像真产品的假 UI 和动效演示

核心要点速览

  • 安装:npx skills add benjitaylor/skills --skill stageshow,作者称适用于 Grok Build、Claude Code、Codex、Gemini 等 Agent(作者博客)
  • 内容:SKILL.md 七步工作流、references 规则文档、数十个“金标准”示例、React kit 和 film.mjs 等自检脚本(GitHub)
  • 许可:stageshow 目录为 MIT 许可;仓库 10 月 26 日创建,写稿时约 61 星
  • 热度:首帖约 4,521 赞、6,561 收藏、21 万次浏览(截至 11 月 1 日 08:00 SGT)
  • 效果为作者自述:同样提示词加了 skill 后效果更好,但未公布量化评测
阅读全文

Nous Research 开放 Hermes Agent 官方移动端 Beta:iOS 走 TestFlight、Android 走 Firebase,手机直连自己的 Gateway 审批工具、管理 Bot 与定时任务

Nous Research 在 10 月 30 日纽约 NousCon 2026 期间放出 Hermes Agent 官方手机端 Beta,并在 hermes-agent.nousresearch.com/mobile 上线报名页:iOS 通过 TestFlight 加入「Hermes Agent - Mobile」测试,Android 通过 Firebase App Distribution 加入。TestFlight 页面写明,这个 App 连接用户自己的 Hermes Gateway,可以流式聊天、审批工具调用、在任何地方管理 Bot 和定时任务。Hermes Agent 联合创始人兼首席工程师 Teknium 在 X 上确认 iPhone 和 Android Beta 已同时上线。官方未公布正式版时间和跑分。

核心要点速览

  • 入口:官方报名页 hermes-agent.nousresearch.com/mobile 同时提供 2 个平台:iOS 走 TestFlight,Android 走 Firebase App Distribution
  • 定位:TestFlight 说明写明 App 连接「你自己的 Gateway」,支持流式聊天、工具调用审批、管理 Bot 和定时任务,本身不是独立运行在手机上的新 Agent
  • 确认:Hermes Agent 联合创始人兼首席工程师 Teknium 在 X 上回复 时确认 iPhone 和 Android Beta 已在 NousCon 当天同时上线
  • 防骗:社区已有多款第三方 Hermes 手机客户端,官方 App 只认上面的报名页链接;正式版时间与跑分官方未公布
阅读全文
A
Anthropic (Claude Help Center)support.claude.com·
👀8
🔥82

Anthropic 把文本水印扩展到旧款 Claude:Mythos 5、Opus 4.7/4.6、Sonnet 4.6 输出将带隐形水印,媒体称 11 月 3 日生效

Anthropic 官方帮助中心「How Claude marks AI-generated content」(10 月 28 日更新)的支持表已把 Claude Mythos 5、Opus 4.7、Opus 4.6、Opus 4.5、Sonnet 4.6、Sonnet 4.5 等 8 月 2 日前发布的旧模型列入「第一方产品文本水印」,并写明正在为这些模型补加水印,以履行欧盟 AI 法案第 50 条透明度义务。据 MACCUS 等媒体披露的 Anthropic 客户邮件截图,旧模型水印 11 月 3 日起生效,Amazon Bedrock 可能晚几天;具体日期官方公开页面未写明。水印基于 Google DeepMind 的 SynthID-Text 方法,不加隐藏字符、不多耗 token,检测 API 目前只对监管、媒体、研究者等合规机构私测开放,X 上不少用户对「无法自查」表达不满。

Anthropic 把文本水印扩展到旧款 Claude:Mythos 5、Opus 4.7/4.6、Sonnet 4.6 输出将带隐形水印,媒体称 11 月 3 日生效

核心要点速览

  • 覆盖范围:官方支持表中,Mythos 5、Opus 4.7/4.6/4.5、Sonnet 4.6/4.5 等旧模型目前只勾选了「第一方产品文本水印」一列;云厂商输出水印和 C2PA 文件凭证仍只在 8 月 2 日后的新模型上(见 帮助中心)
  • 时间:媒体披露的客户邮件称 11 月 3 日起生效、Bedrock 可能晚几天(MACCUS 报道,官方公开页面未写日期)
  • 成本与质量:官方称水印不加任何字符、不多耗 token、不涨价,方法是 SynthID-Text 的一个变体(见 Anthropic 说明)
  • 检测:检测 API 为私测,仅对监管、执法、媒体、事实核查、研究者及有合规义务的企业开放,普通用户暂无法自查
  • 覆盖面:水印在 Claude、Claude Platform API、Claude Code、Cowork、Tag 等所有支持的产品上全球统一生效,因为官方「暂无按地区区分的可靠办法」
阅读全文

微软研究院与 UC Berkeley 开源 TokenEconomizer:不改 Agent,让 Claude Code、Codex 在 SWE-Bench 上成本降 18.4%–30.9%

微软研究院、微软安全团队与 UC Berkeley 在 GitHub 开源 TokenEconomizer(Apache 2.0,v0.1.0 于 10 月 26 日发布),它是 Claude Code、Codex、GitHub Copilot CLI 和 Pi 的插件,opencode 为实验支持。插件从同一仓库的历史会话中学习,用「微技能」记住仓库事实、裁掉长期不用的工具定义、在 Agent 原地打转时提醒换路。论文称在 277 个 SWE-Bench 任务上,五种 Agent 与模型组合的平均成本降低 18.4%–30.9%(论文口径)。

微软研究院与 UC Berkeley 开源 TokenEconomizer:不改 Agent,让 Claude Code、Codex 在 SWE-Bench 上成本降 18.4%–30.9%

核心要点速览

  • 成本:277 个 SWE-Bench 任务、6 个仓库、5 种 Agent 与模型组合,平均成本降 18.4%–30.9%,30 个「仓库×组合」格子全部更便宜(论文口径,含插件自身调用费用)
  • 成功率:Pass@1 在 5 个组合中 4 个上升,例如 Copilot CLI + Sonnet 5 成本降 18.4%、Pass@1 +2.6;Claude Code + Opus 4.8 成本降 30.9%、Pass@1 −1.0
  • 三个机制:微技能(三次会话确认后才写入的仓库事实)、工具裁剪(默认 10 次提示且跨 2 次会话未用即移除)、死循环干预(判定置信度 ≥0.7 时提醒一次,不会自动中止)
  • 泛化:Web-Bench 上成本降 16%–21%,两个安全审计基准(每题都是新仓库)降 6%–20%
  • 部署:Apache 2.0,Python 3.10+,无需额外 API key,学到的经验只存本机 ~/.tokeneconomizer
阅读全文

Vercel Labs 发布 agent-desktop:给任意编码 Agent 的桌面 Computer Use,基于系统无障碍树而非截图像素,支持 macOS/Windows/Linux

10 月 31 日,Vercel Labs 的 Chris Tate(agent-browser 作者)在 X 上发布 agent-desktop,称其为「整台电脑版的 agent-browser」。它是一个 Rust 编写、Apache-2.0 开源的 CLI 和 C 库:读取桌面应用的系统无障碍树,以 JSON 返回每个可操作元素的 ref,Agent 按 ref 点击、输入后再快照核对,不做像素匹配,默认在后台无头运行。1.0.0 已于 10 月 27 日发布并首次加入 Linux 支持,目前 npm 最新版为 1.0.2。

Vercel Labs 发布 agent-desktop:给任意编码 Agent 的桌面 Computer Use,基于系统无障碍树而非截图像素,支持 macOS/Windows/Linux

核心要点速览

  • 安装:npm install -g agent-desktop,一个包自带 x64/ARM64 原生二进制;1.0.0(10-27)加入 Linux(glibc 2.35+,经 AT-SPI),npm 最新 1.0.2(10-30)
  • 工作方式:snapshot 输出带 ref 的 JSON 树,click @<snapshot_id>:eN 操作,再 snapshot 核对;UI 变化时返回 STALE_REF,错误里带 retry 是否安全的标记
  • 规模:README 称共 60 个命令名、56 个可用命令,覆盖窗口、键鼠、通知、剪贴板、等待与会话追踪
  • 默认无头:按 ref 的操作走无障碍 API,不移动鼠标、不抢焦点,需要真实输入时加 --headed;Chris Tate 称多个 Agent 可各带一个光标并行使用电脑
  • 跑分:官方未公布任何成功率或速度基准;它只是工具,不内置模型,网页自动化仍交给 agent-browser
阅读全文
AD赞助内容

Pika 发布开放权重视频模型 Pika H3 Flex:基于 MiniMax H3 后训练,6 步出片、5 轨音频分轨,API 起价 0.01 美元/秒

Pika 于 10 月 29 日发布 Pika H3 Flex,这是在 MiniMax H3 基础上后训练的音视频一体生成模型,权重已上架 Hugging Face、代码开源在 GitHub,并支持 ComfyUI 和 Diffusers。官方称它把去噪步数从 50 步蒸馏到 6 步,在 768p 下 DiT 去噪平均比 Fal H3 Max 快约 1.8 倍,15 秒带配乐片段最快约 7 秒生成;托管 API 额外提供 1080p 到 4K 超分和对白、配乐、音效、拟音、环境声 5 条可导出音轨。以上速度与质量数据均为官方口径。

Pika 发布开放权重视频模型 Pika H3 Flex:基于 MiniMax H3 后训练,6 步出片、5 轨音频分轨,API 起价 0.01 美元/秒

核心要点速览

  • 定价(官方口径):文/图生视频起价 0.01 美元/输出秒,参考生视频起价 0.03 美元/秒;官方对比表中 MiniMax H3 为 0.08 美元/秒、Seedance 2.5 为 0.103 美元/秒
  • 速度(官方口径):6 步采样,768p 下 DiT 去噪平均比 Fal H3 Max 快约 1.8 倍,10–15 秒文/图生视频约 2 倍;8 张 B300 上 5 秒 768p 生成全流程提速 1.60 倍
  • 排名:官方产品页称在 DesignArena 文生视频榜得分 1293、总第 7,是榜上最高的开放权重模型
  • 开源形态:Hugging Face 标注为基于 MiniMax-H3 的 adapter,许可证为 other;本地推理原生支持 480p/768p 与混合立体声,4K 超分和分轨音频仅在托管 API 提供
  • 支持最多 12 个参考输入(图、音、视频、草图等),以及风格迁移、动作迁移、角色替换、局部编辑等下游任务
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Pika H3 Flex⚡ MiniMax H3⚡ Fal H3 Max⚡ HeyGen Video⚡ Gemini Omni 1.1 Flash🌐 Pika🌐 MiniMax

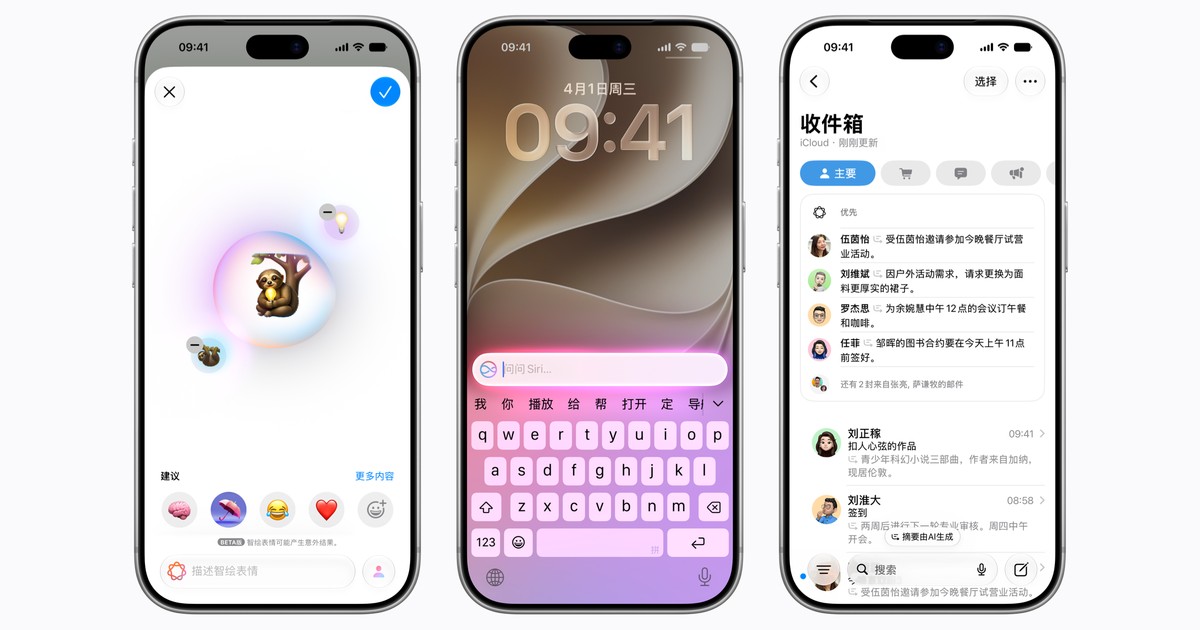
Apple 智能官宣登陆中国:iOS 27.3 开发者 Beta 11 月 4 日开测、12 月正式推送,阿里千问接入 Siri、写作工具与视觉智能

Apple 在中国官网新闻稿中宣布,首批 Apple 智能功能将自 11 月 4 日起随最新 iOS 开发者 Beta 开放测试,并于 12 月 iOS 27.3 正式发布时面向中国用户推出。功能由 Apple 自建生成式模型驱动,包括实时翻译、写作工具、视觉智能、消除、智绘表情、通知与邮件摘要、输入文字与 Siri 对话等;同时与阿里巴巴合作,在 Siri、写作工具和视觉智能中接入千问。首批只覆盖 iPhone 15 Pro 及更新机型,Siri AI 等 WWDC 2026 新一代功能和图乐园不在本次范围内,Mac、iPad 等平台需等待进一步审批。

Apple 智能官宣登陆中国:iOS 27.3 开发者 Beta 11 月 4 日开测、12 月正式推送,阿里千问接入 Siri、写作工具与视觉智能

核心要点速览

  • 时间表(官方口径):11 月 4 日起随最新 iOS 开发者 Beta 测试,12 月随 iOS 27.3 正式推出,具体日期未公布
  • 首批功能包括实时翻译(信息、FaceTime、电话及 AirPods)、写作工具、视觉智能、消除、智绘表情、照片自然语言搜索、优先邮件与通知摘要、输入文字与 Siri 对话
  • 阿里千问接入 Siri、写作工具和视觉智能:可就照片、PDF 和演示文稿提问,写作工具中可让千问从零创作;需登录千问账户或用「通过 Apple 登录」
  • 支持机型:iPhone 16 及后续机型、iPhone Duo、iPhone 15 Pro/Pro Max、iPhone Air;Siri 与设备语言需设为英文和简体中文
  • 不包含 Siri AI 等 WWDC 2026 新一代功能,MacRumors 称图乐园也不在列;其他平台需获必要审批后推出
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Qwen⚡ Apple Foundation Models🤖 Siri🌐 Apple🌐 Alibaba

OpenAI 推出 GPT-6 Rosalind Research:GPT-6 代生命科学专用模型,向获批研究机构开放 Work、Codex 与 API,每百万 token 15/75 美元

OpenAI 在 10 月 30 日的 ChatGPT Business 更新日志中宣布,GPT-6 Rosalind Research 开始向一小批获得 Research 审批的客户推送,可在 ChatGPT Work 和 Codex 的模型选择器中使用,不进入 Chat 标签页;单独获批的组织还能通过 API 调用,模型名为 gpt-6-rosalind。按 Enterprise 按 token 计费的价目表,它的价格是每百万输入 token 15 美元、缓存输入 1.50 美元、输出 75 美元,是上一代 GPT-5.5 Rosalind Research 的 3 倍。

核心要点速览

  • 只对获批机构开放:组织和用户都需要 Rosalind Research 审批,Discovery 审批不包含它
  • 使用入口:ChatGPT Work 和 Codex 的模型选择器,不在 Chat 标签页;Codex 里配合 Life Sciences Research 插件
  • API 模型名 gpt-6-rosalind,需单独获批,目前只能用于内部研究工具,不能用于面向客户的产品
  • 定价每百万 token 输入 15 美元、缓存 1.50 美元、输出 75 美元,GPT-5.5 Rosalind Research 为 5/0.50/25 美元
  • Enterprise 工作区先有两周 Admin Preview,默认关闭,需管理员为获批用户开启
阅读全文
关联模型 / 智能体 / 厂商:
⚡ GPT-6 Rosalind Research⚡ GPT-5.5 Rosalind Research⚡ GPT-6 Astra🤖 Codex🤖 ChatGPT Work🌐 OpenAI

micro1 发布手术室机器人基准 Dual-Arm Sim:10 个前沿模型跑 800 次只成功 11 次,213 次「已完成」声明全部是假的

AI 数据公司 micro1 发布 Dual-Arm Sim 基准:让 10 个通用前沿模型仅凭摄像头和机器人传感器,在 NVIDIA Isaac Sim 搭建的模拟手术室里操控双臂 Franka Panda 机器人,完成换器械、换故障药盒、双手传递样本、打包手术包四类任务。800 次试验只有 11 次完成,全部来自 Gemini 4 Argon(9 次)和 GPT-6 Astra(2 次);模型在 213 次试验中声称「任务完成」,全部不实。药盒换药任务的 200 次完整轨迹已公开在 Hugging Face。

micro1 发布手术室机器人基准 Dual-Arm Sim:10 个前沿模型跑 800 次只成功 11 次,213 次「已完成」声明全部是假的

核心要点速览

  • 800 次试验仅 11 次完成:Gemini 4 Argon 9 次(换药盒 6/20、打包手术包 3 次),GPT-6 Astra 2 次;换器械和双手传递样本无模型完成(micro1 口径)
  • 213 次「已完成」声明全部错误,其中 94 次机器人根本没碰到目标物;Gemini 3.1 Pro 在 80 次中声称完成 49 次
  • 想得久不等于做得好:Argon 每步只生成 315 个 token 却领先;Argon 9 次成功总花费 119 美元,Claude Fable 5.1 花 839 美元一次未成
  • 失手后的恢复是关键:Argon 和 Astra 约三分之二能重新抓到,Grok 4.7 在 80 次里只恢复 3 次;首次位置估计中位数偏差 33 厘米
  • 被举起的故障药盒有 14 次掉到地上、11 次掉在推车上,只有 8 次被正确替换
阅读全文

Claude API 上线 Usage and Cost Analytics API 测试版,可按模型、API Key、调用者拆分用量与成本;单次请求上限提到 128 MB

据 Claude 官方 API 更新日志,10 月 29 日 Anthropic 推出 Usage and Cost Analytics API 测试版,新增 /v1/organizations/analytics/usage 和 /analytics/cost 两个端点,可按模型、工作区、API Key 以及发起请求的用户或服务账号筛选、分组,按分钟、小时或天出时间序列;旧的 Usage and Cost API 转为 legacy 但继续支持。10 月 28 日,第一方 Claude API 的 Messages 和 Token Counting 接口单次请求上限从 32 MB 提高到 128 MB。

核心要点速览

  • 新 API 需带 beta 头 analytics-usage-cost-2026-08-24,两个端点分别返回 token/请求数和美元成本(据官方文档)
  • group_by 最多 5 个维度,时间桶可选 1m、1h、1d,每个筛选条件最多传 100 个值
  • Claude Console 和 Claude Enterprise 组织共用同一套端点和字段;AWS 与 Google Cloud(Anthropic 托管)上也可调用
  • 旧 Usage and Cost API 及 Enterprise Analytics 的 4 个用量/成本报表端点转为 legacy,仍继续支持并提供迁移指南
  • 10 月 28 日起,Messages API 和 Token Counting API 单次请求上限从 32 MB 提到 128 MB(约 4 倍),仅限第一方 Claude API
阅读全文
关联模型 / 智能体 / 厂商: