AI 编程实时动态与要闻

Flower Labs 发布 Endeavor 1.1:新增多模态与欧盟境内推理,可私有部署并开放思维链,自称比肩 OpenAI、Anthropic

联邦学习框架 Flower 背后的 Flower Labs 于 11 月 3 日发布 Endeavor 1.1,这是其今年第三个模型(继 4 月的英国主权 7B 模型 Lizzy、9 月的 Endeavor 1.0 之后)。新版本新增图像输入、可选欧盟境内 GPU 推理,支持 Flower 托管、私有云或本地部署,并承诺用户可查看完整思维链、拥有推理输出并用于训练自有模型。官方口径 GPQA 94.4、HumanEval 99.9、AIME 2026 99.9、MMMU-Pro 81.1,但对比对象是 GPT-5.6 Sol 与 Claude Fable 5 而非两家最新模型,且目前仅开放申请试用。

Flower Labs 发布 Endeavor 1.1:新增多模态与欧盟境内推理,可私有部署并开放思维链,自称比肩 OpenAI、Anthropic

核心要点速览

  • 官方口径:GPQA 从 1.0 的 92.0 升到 94.4(约少 30% 错误),HumanEval 从 98.2 升到 99.9,IFEval 94.5,MMMU-Pro 81.1。
  • 官方对比表中 GPT-5.6 Sol 为 GPQA 94.1、IFEval 95.9、MMMU-Pro 83.0,Claude Fable 5 为 GPQA 92.6;Endeavor 在 IFEval 和 MMMU-Pro 上并未领先。
  • 新增欧盟境内 GPU 推理并附 SLA,计划后续推出英国、中东、亚洲、非洲区域推理。
  • 卖点是可控:读取原始思维链、保留推理输出与轨迹,并可用来微调或训练自有模型。
  • 官方称模型基于成熟开源权重模型,经持续预训练、定向后训练与模型融合构建,未公开基座与参数规模;目前需申请访问。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Endeavor 1.1⚡ Endeavor 1.0⚡ GPT-5.6 Sol⚡ Claude Fable 5⚡ Kimi K3⚡ Nemotron 3 Ultra🌐 Flower Labs
g
guregodevo (Memdoor author)github.com·
👀24
🔥81

Memdoor 复现 GVS5H:5 个 Qwen3.8-27B 组队在 LiveCodeBench Hard 前 10 题均分 9.8/10,高于 Fable 5 单次调用的 8.0

开源编码 Agent 工具 Memdoor(GitHub guregodevo/memdoor,Apache 2.0)10 月 31 日公布 team-solve 工作流:用 GVS5H 论文作者的原版提示词和循环,让 5 个 Qwen3.8-27B 实例分别担任规划、两路构思、求解和管理,只通过磁盘文件沟通,由脚本跑测试判定成败。在 GVS5H 列表的前 10 道 LiveCodeBench Hard 题上各跑 5 轮,平均 9.8/10,作者原版 harness 为 9.6,Fable 5 单次调用为 8.0;50 次运行 49 次解出,总花费 35.79 美元,全部请求和回复都已公开。该帖在 Hacker News 约 200 分。这是社区复现,仅 10 题,作者自己也提示不能排除训练数据污染。

核心要点速览

  • 成绩:5 轮平均 9.8/10(逐轮 10、10、10、10、9),GVS5H 作者原版 harness 9.6,Fable 5 单次调用 8.0(team-solve README,项目方口径)
  • 成本:50 次运行 49 次解出,共 35.79 美元、1,530 万输出 token;单次中位耗时约 40 分钟模型时间、0.39 美元,最长 4 小时
  • 方法:规划、两路构思、求解、管理 5 个角色加修复 worker,各自从全新上下文开始,只经磁盘文件交流,测试由 shell 脚本判定,不让模型自评
  • 局限:只测了 10 题而非论文的 100 题;题目来自 2025 年 3–4 月的比赛,可能已进训练数据;Fable 5 的分数取自 GVS5H 作者的结果文件,没有在这个 harness 里重跑
  • 热度:HN 帖子约 200 分(截至 11 月 1 日 16:10 SGT);GVS5H 原论文为 arXiv 2608.26480,10 月 25 日曾登 HN 第一
阅读全文
x
xAIdocs.x.ai·
👀61
🔥82

xAI 宣布 11 月 7 日起 Grok API 文本默认加隐形水印:覆盖 grok-4.7 等 7 个模型,团队管理员可按模型退出

xAI(文档署名 SpaceXSI)10 月 31 日在 API 文档新增《Output Watermarking》页面:从 2026 年 11 月 7 日起,grok-4.7、grok-4.6、grok-4.5、grok-4.3 以及 grok-4.20 的推理、非推理和多 Agent 三个版本,生成的文本默认带隐形水印,理由是遵守欧盟 AI 法案。水印覆盖 Responses 和 Chat Completions 两套接口的普通文本、结构化输出和工具调用参数,在生成时轻微影响选词,不添加任何字符。开发者可读响应头 x-watermark 判断;团队管理员可在控制台按模型退出,但须确认适用法律豁免,部分模型可能被锁定无法关闭。

核心要点速览

  • 生效时间:2026 年 11 月 7 日起默认开启,无需改代码、没有请求参数(xAI 文档)
  • 范围:7 个模型 ID(grok-4.7、4.6、4.5、4.3 及 grok-4.20 的 reasoning、non-reasoning、multi-agent),全球与区域端点、Responses 与 Chat Completions 都覆盖
  • 覆盖内容:普通文本、结构化输出和工具调用参数;响应头 x-watermark: true 表示本次输出带水印
  • 退出:团队管理员按模型关闭,5 分钟内对新请求生效、写入审计日志;须确认适用法律豁免,部分模型被锁定不可关
  • 官方口径:水印不影响质量和速度;检测为统计方法,结果分为有水印、无水印、不确定三档,检测 API 需申请
阅读全文
关联模型 / 智能体 / 厂商:

YC Labs 让 AI 智能体蜂群打 Minecraft 和 Mindustry:GPT 蜂群两项对抗赛 16 局赢下 12 局压过 Claude,50 智能体殖民地反而陷入「官僚主义」

Y Combinator 的研究项目 YC Labs 与多智能体环境公司 Olam Labs 10 月 29 日发布《Agents in Games》实验报告:50 个 GPT-6.1 Sol 智能体在 Minecraft 生存模式里「建设繁荣文明」3 小时,最后挤在避难所里配给口粮,发了约 5,900 条消息,搞出配给账本、许可证和各种岗位;9 局 Bed Wars 中 10 个 GPT-6.1 Sol 对 10 个 Claude Opus 5.5,GPT 以 6–3 获胜;Mindustry 50 对 50 共 7 局约 9.5 小时,GPT 以 6–1 获胜。报告还发现领导者几乎总是名册上排第一的智能体,GPT 卡住时会自己上网读游戏源码。Minecraft 智能体框架已开源。这是单一机构的实验观察,不是标准化跑分。

YC Labs 让 AI 智能体蜂群打 Minecraft 和 Mindustry:GPT 蜂群两项对抗赛 16 局赢下 12 局压过 Claude,50 智能体殖民地反而陷入「官僚主义」

核心要点速览

  • 对抗结果:Bed Wars 9 局 GPT-6.1 Sol 6–3 胜,Mindustry 7 局 6–1 胜,合计 16 局 12 胜(见 YC Labs 报告)
  • Civ50:50 个 GPT 智能体 3 小时发约 5,900 条消息,34 次死亡中 22 次发生在第一夜,之后整体趋于保守
  • 领导者不靠选举:49 个智能体中 46 个第一条消息发给名册第一的 Ada,她共收到 616 条私信
  • 沟通风格:Bed Wars 一局中 GPT 发出 1,147 条私信、Claude 仅 82 条;GPT 越打越用压缩速记,Claude 用「+1」投票
  • 开源:Minecraft 长时运行智能体框架 yc-software/minecraft-agent-harness 已公开
阅读全文
AD赞助内容

X 热议:Sam Altman 称个人电脑占用稀缺 DRAM「相当糟糕」,本地推理派强烈反弹

Stripe 联合创始人 John Collison 的 Cheeky Pint 播客 10 月 29 日上线 Sam Altman 专访。谈到内存短缺时,Altman 说很多人以为开源模型加本地推理就能绕开算力紧张,但从全球配置角度看,让每个人电脑里放着一堆稀缺 DRAM、只有约 5% 的时间在用「相当糟糕」,供给紧张时应追求云端的最大利用率。pubity 转述这段话的帖子获得 2.6 万多点赞、800 多万次浏览,大量用户反驳称 PC 内存并非只为 AI 服务,本地模型还关乎隐私和离线可用。以下按观点讨论整理,不代表已证实结论。

X 热议:Sam Altman 称个人电脑占用稀缺 DRAM「相当糟糕」,本地推理派强烈反弹

核心要点速览

  • 出处:Cheeky Pint 播客 10 月 29 日 Sam Altman 专访,官方文字稿可查,原话含「being used 5% of the time」
  • Altman 的论点:DRAM 供给紧张时,放在个人电脑里的内存利用率低,云端数据中心可持续服务多用户,应追求最大利用率
  • 热度(X API,10 月 31 日 13:06 SGT 读取):pubity 帖 26,124 赞、8,557 条引用、5,210 条回复、约 806 万次浏览
  • 主要反驳:PC 内存还要跑系统、浏览器和游戏;本地模型让数据留在本机;也有人指出这与 OpenAI 的云端商业模式一致
  • 5% 这个数字 Altman 未解释口径,媒体建议当作粗略估计而非测量值
阅读全文
关联模型 / 智能体 / 厂商:

Kaggle 与 IBM Research 上线 ScarfBench 企业 Java 迁移榜:Gemini 4 Argon + Antigravity 以 75.2% 居首,七成失败发生在运行阶段

Kaggle 官方账号宣布与 IBM Research 合作上线 ScarfBench,用 204 个任务测试编码智能体能否把企业 Java 应用在 Jakarta EE、Quarkus 和 Spring 之间迁移且行为不变。IBM 10 月 27 日的技术说明显示,Gemini 4 Argon + Antigravity 以 75.2% 冒烟分居首,Claude Opus 5.5 + Claude Code 全通过率最高(72.1%),GPT-6.1 Sol + Codex 每解决一个任务成本最低(1.25 美元)。

Kaggle 与 IBM Research 上线 ScarfBench 企业 Java 迁移榜:Gemini 4 Argon + Antigravity 以 75.2% 居首,七成失败发生在运行阶段

核心要点速览

  • 204 个迁移任务、10 组「模型 + 智能体框架」组合;前三名冒烟分:Gemini 4 Argon + Antigravity 75.2%、Claude Opus 5.5 + Claude Code 70.5%、Claude Opus 5 + Claude Code 69.8%(IBM 口径)
  • 全部测试通过率 Claude Opus 5.5 + Claude Code 最高,为 72.1%,略高于 Gemini 4 Argon 的 71.1%
  • 编译几乎不是问题:10 组里 8 组编译成功率 ≥97%,但冒烟分差距超过 50 个百分点
  • 745 次失败中 535 次(约 72%)是运行时行为失败,其中 210 次是路由丢失 / 404
  • 每解决一个任务的成本:GPT-6.1 Sol + Codex 1.25 美元、Gemini 3.8 Flash + mini-swe 1.59 美元、Claude Opus 5.5 + Claude Code 10.10 美元;公开提交暂未开放
阅读全文

Factory 发布 Droid 1.0:程序化工具调用成默认,一次模型请求可跑上百次工具调用,自测 Terminal-Bench 4 领先各家原生 harness

AI 编程 Agent 公司 Factory 10 月 29 日 22:31(UTC)在 X 和官方博客发布 Droid 1.0,称这是其 agent harness 迄今最大的一次更新。核心变化是把程序化工具调用(PTC)设为默认:模型写一段 JavaScript 脚本,在沙箱里一次跑完多达上百次工具调用。官方自测 Terminal-Bench 4 中,用 GPT-6.1 Sol 通过率 57.6%(每个通过任务 $0.79),用 Claude Opus 5.5 通过率 65.2%($4.73),均高于同模型下的 Codex、Claude Code、Cursor、OpenCode 和 Devin。

Factory 发布 Droid 1.0:程序化工具调用成默认,一次模型请求可跑上百次工具调用,自测 Terminal-Bench 4 领先各家原生 harness

核心要点速览

  • 程序化工具调用成默认:模型写 JavaScript 脚本,在无文件/网络/系统权限的沙箱里运行,一次请求可跑上百次工具调用,互不依赖的调用并发执行
  • 官方示例:移动并核对 151 个 Linear issue 需 312 次工具调用,直接调用约 36 次请求、310 万输入 token,用 Script 只需 2 次请求、6.1 万 token
  • Terminal-Bench 4(Factory 自测,10 月 23–28 日,每任务 3 次):GPT-6.1 Sol 下 Droid 57.6% 对 Codex 54.0%、OpenCode 51.0%、Devin 45.0%;Opus 5.5 下 Droid 65.2% 对 Cursor/OpenCode 62.1%、Devin 59.6%、Claude Code 57.6%
  • 首轮请求从 20,887 降到 13,055 token(-37%),开局工具定义从 11 个减到 2 个;新加载的 MCP 工具追加到请求末尾,不破坏 prompt cache,生产中典型请求 98% 输入命中缓存
  • 已上线:macOS/Windows 桌面版、终端 TUI,以及 Droid SDK(@factory/droid-sdk);跑分为厂商自测,尚无第三方复现
阅读全文

GitHub Agentic Workflows 正式 GA:用 Markdown 写自动化、编译成 Actions YAML,支持 Copilot 或自带编码 Agent,新增 ARC 自托管和 micro-VM 隔离

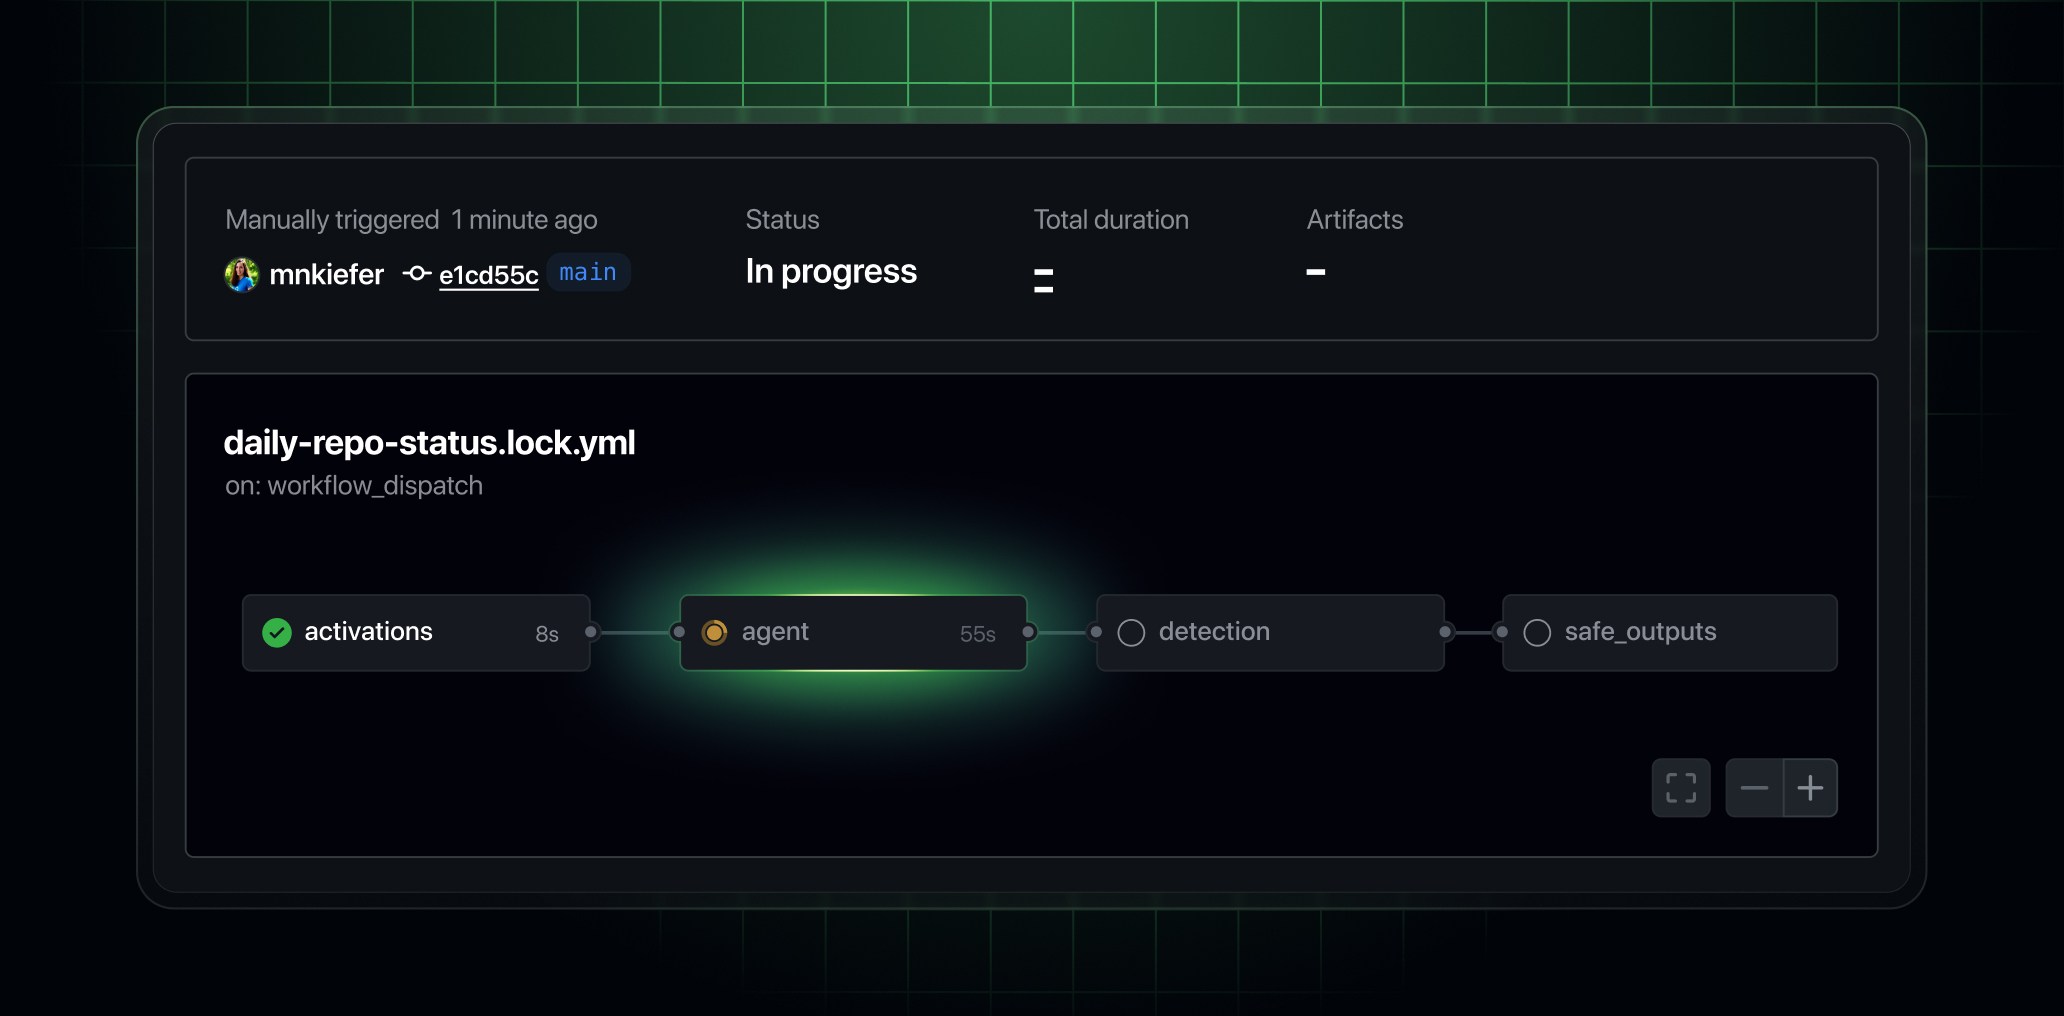
GitHub 于 10 月 28 日(Universe 2026)宣布 GitHub Next 的开源项目 GitHub Agentic Workflows 正式 GA,面向 GitHub Free、Team 和 Enterprise。开发者用自然语言 Markdown 描述 issue 分拣、CI 失败分析、文档更新、写测试等任务,gh aw 把它编译成标准 Actions YAML,由 Copilot 或自带的编码 Agent 执行。GA 新增 ARC 自托管 runner 和 Docker-in-Docker 支持、正式版 gh aw forecast 成本预估、按工作流选模型和模型路由,以及 Cloud Hypervisor / NVX micro-VM 隔离。

GitHub Agentic Workflows 正式 GA:用 Markdown 写自动化、编译成 Actions YAML,支持 Copilot 或自带编码 Agent,新增 ARC 自托管和 micro-VM 隔离

核心要点速览

  • 适用范围:github.com 上的 GitHub Free、Team 和 Enterprise 均可用;用默认的 Copilot CLI 引擎需要 Copilot 许可
  • 工作方式:Markdown 写需求,编译成标准 Actions YAML,复用已有 runner 组和策略;可用 Copilot 或自带编码 Agent
  • 安全默认值:只读权限、沙箱容器加 Agent Workflow Firewall、safe outputs 校验,以及应用变更前的威胁检测作业
  • GA 新增:ARC 自托管 runner 加 Docker-in-Docker、gh aw forecast 转正(含威胁检测额度和月度区间)、按工作流选模型提供方、模型路由、micro-VM 隔离和跨仓库 enclave
  • 客户案例(Accenture 口径):一位负责人每周省约 29 小时,团队 91% 的 commit 由 AI 编写,生产错误从每天约 11,000 个降到 1,000 以下
阅读全文

Google 推出 Connected Apps Platform 预览:开发者用 MCP 或 Android AppFunctions 一次接入 Gemini 和搜索

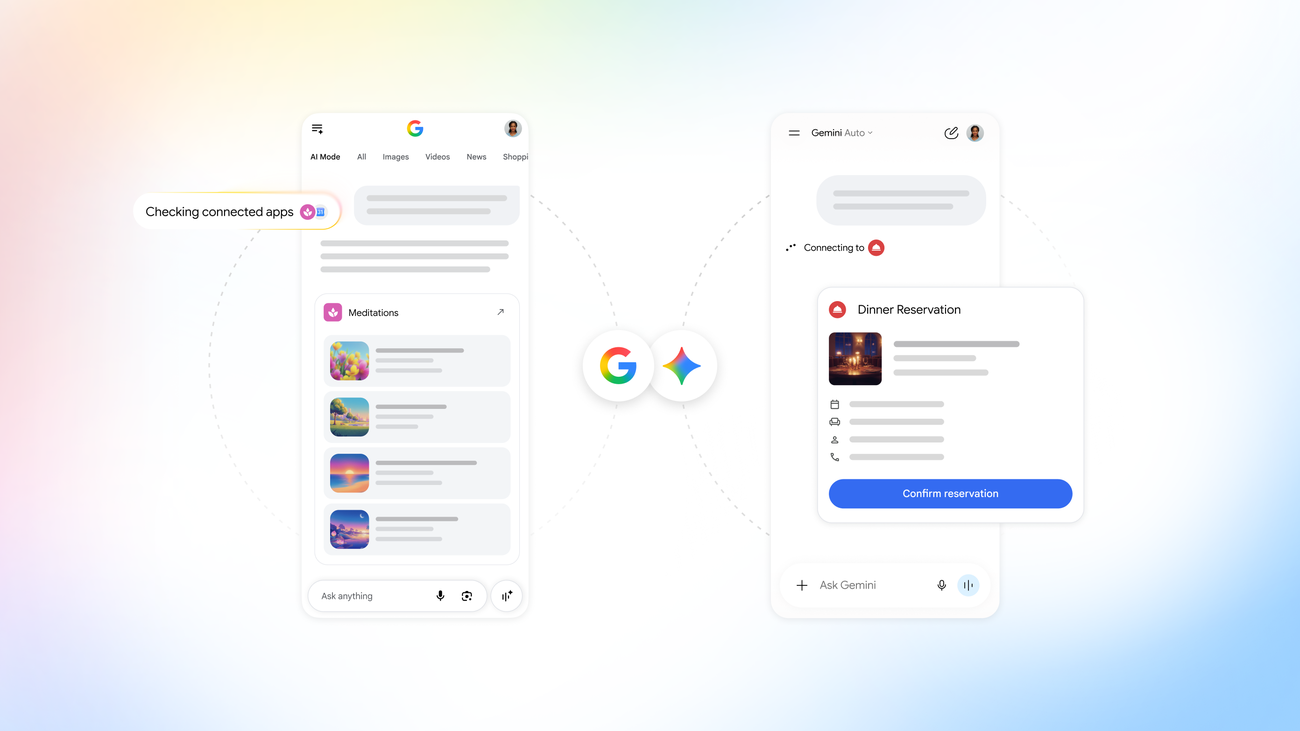
Google 于 10 月 28 日推出 Connected Apps Platform 预览版,开发者通过云端托管的 MCP 服务器或 Android MCP(Jetpack AppFunctions)接入,在 Google Connected Console 注册、测试、提交审核,并选择上线到搜索、Gemini 应用或两者。目前面向美国开发者分批开放,需申请加入预览。

Google 推出 Connected Apps Platform 预览:开发者用 MCP 或 Android AppFunctions 一次接入 Gemini 和搜索

核心要点速览

  • 两条接入路径:云端托管的远程 MCP 服务器(授权用 OAuth 2.1),或 Android 端的 Jetpack AppFunctions(Android MCP),工具在设备本地执行
  • 统一后台:Google Connected Console 负责工具注册、测试、审核发布,上线后可看流量、延迟和错误率
  • 分发选择:提交审核前决定上线到搜索、Gemini 应用或两者
  • 现状:搜索和 Gemini 里已有 50 多个 Connected Apps,Adobe、Experian、Localiza、Peloton 已在 Gemini 上线,未来几周进入搜索,Calm 将两边同时上线
  • 限制:预览期分批开放、面向美国开发者,需申请;Google 未给出全面开放时间
阅读全文

Alphabet 2026 Q3 财报:营收 1276 亿美元增 25%,Google Cloud 翻倍增长 103%,一方模型 API 每分钟处理近 320 亿 token

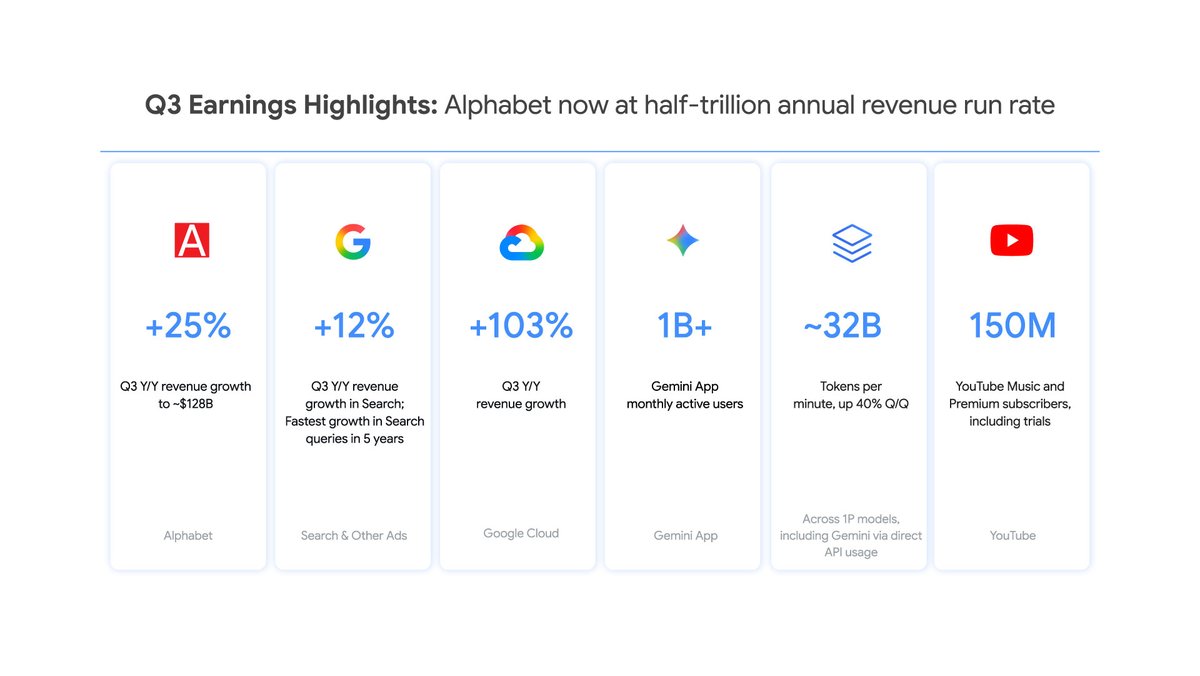
Alphabet 10 月 28 日美股盘后发布 2026 年第三季度财报:营收 1276 亿美元,同比增长 25%;Google Cloud 营收 307 亿美元,同比增长 103%,官方称由企业 AI 基础设施、AI 解决方案和 TPU 系统销售拉动。Sundar Pichai 在财报和 X 上表示,一方模型 API 每分钟处理近 320 亿 token,是一年前的四倍多,Gemini App 用户达到 10 亿。代价是本季资本开支 514 亿美元,自由现金流为负 91 亿美元。

Alphabet 2026 Q3 财报:营收 1276 亿美元增 25%,Google Cloud 翻倍增长 103%,一方模型 API 每分钟处理近 320 亿 token

核心要点速览

  • 营收 1275.77 亿美元,同比 +25%,连续第 13 个季度两位数增长;Pichai 称年化营收已达 5000 亿美元
  • Google Cloud 营收 307.09 亿美元(去年同期 151.57 亿),同比 +103%;经营利润 111.21 亿美元,去年同期 35.94 亿
  • 一方模型 API 每分钟近 320 亿 token,是一年前的 4 倍多;Pichai 的 X 帖称环比增长 40%
  • Gemini App 用户达 10 亿,官方称是 Google 史上增长最快的产品;Search 查询量同比增速为近 5 年最高
  • 本季资本开支 513.55 亿美元(去年同期 239.53 亿),自由现金流 -90.65 亿美元,连续第二个季度为负
阅读全文
AD赞助内容

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

独立评测机构 Artificial Analysis 10 月 28 日发布 Intelligence Index v5,是 1 月 v4 以来最大一次改版:新增 Cognition 的 FrontierCode 2.0 和 Terminal-Bench-Science,用 HLE-Diamond 替换 Humanity's Last Exam,60% 的权重来自私有或答案保留的测试集。榜首为 Claude Opus 5.5(max)58 分,GPT-6 Astra 57、GPT-6.1 Sol 55;开源权重最高的 Kimi K3.1 Pro(权重尚未发布)46 分,与榜首差距从 v4.3 的 3 分扩大到 12 分。同时推出跨年代对比的 Progress Index v1。

Artificial Analysis 发布 Intelligence Index v5:六成测试改用私有数据集,Claude Opus 5.5 以 58 分居首,开源差距拉大到 12 分

核心要点速览

  • 总榜(官方口径):Claude Opus 5.5(max)58、GPT-6 Astra(max)57、GPT-6.1 Sol(max)55,前五名都来自 Anthropic 和 OpenAI,Gemini 4 Argon(high)50 分排第六档
  • 开源差距从 3 分扩大到 12 分:Kimi K3.1 Pro 46 分;已发布权重的 DeepSeek V4.1 Flash 1017 和 GLM-5.3(max)都是 32 分,低于 Claude Haiku 5.5(max)的 36 分
  • 成本差距超过 13 倍:前十名中 GPT-6.1 Terra(max)每任务 0.96 美元最便宜,Claude Fable 5.1(max)13.04 美元最贵;GPT-6.1 Sol 以约八分之一成本(1.27 对 10.04 美元)落后 Opus 5.5 仅 4 分
  • 四大类各占 25%:知识工作、编程(FrontierCode 2.0 占 15%、Terminal-Bench 4.0 占 10%)、科学、通用;移除 GDPval-AA v2.1、SciCode 和 AA-LCR
  • 任务更重:每任务输出 token 中位数从 35k 升到 59k;推理强度影响更大,Opus 5.5 低档 35 分、最高档 58 分,成本差 10 倍
阅读全文

Cadence 发布 Maestro 芯片设计领域 AI 模型组合:结合 NVIDIA Nemotron 驱动 AI Super Agents,官方称质量最高提升 30%、token 效率最高 5 倍

EDA 巨头 Cadence 10 月 26 日发布 Maestro AI 模型组合,包含领域后训练 LLM、决策模型和可自我改进的 agent skills,用来驱动其 AuraStack、ChipStack、InnoStack、ViraStack 等 AI Super Agents 操作 EDA/SDA 工具。Cadence 用确定性求解器给输出打分,形成强化学习闭环。官方初步结果称相比通用基础模型质量最高提升 30%、token 效率最高 5 倍。NVIDIA 提供 Nemotron 与 OpenShell,可部署在 Cadence 云、公有云或客户本地。首批模型 2026 年第四季度向部分早期客户开放。

核心要点速览

  • Maestro 不是单个模型,而是一组领域后训练 LLM、决策模型和自我改进的 agent skills,按任务与前沿/开源模型混合调度
  • 确定性求解器和 EDA 工具对输出按工程目标与约束打分,作为强化学习反馈,形成可验证闭环
  • Cadence 口径:相比通用基础模型,质量最高提升 30%,token 效率最高 5 倍;暂无第三方评测
  • NVIDIA 提供 Nemotron 模型与 OpenShell 沙箱参考架构;客户可用自有设计数据继续后训练,支持本地部署
  • 首批模型仅在 2026 年 Q4 向部分早期客户开放;Socionext 称部署 InnoStack 预计最高 5 倍生产力提升
阅读全文

Anthropic 公开内部 Claude 研究模型发现的 3-SAT 亚指数算法:论文与 Lean 4 证明称推翻指数时间假设(ETH)

Anthropic 在官方 GitHub 仓库 anthropics/formal-math 发布论文《A 2^o(n) Time Algorithm for 3-SAT》(署名 Claude, Anthropic)及 AI 编写的 Lean 4 形式化证明,称确定性算法可在 2^o(n) 时间内求解 3-SAT,从而推翻 ETH。Anthropic 员工 Levent Alpöge 在 X 上称核心算法由内部 Claude 研究模型于 10 月 16 日用 1400 万输出 token、无人工输入找到。仓库强调结果纯属渐近意义,对实际求解没有帮助。

核心要点速览

  • 论文称:确定性算法在 2^o(n) 时间内判定 n 个变量的 3-SAT,推翻 ETH;并在 2^O(n log log n / √log n) 时间内求解更难的计数问题 #3-SAT
  • 据 Levent Alpöge 的 X 帖:核心算法由内部 Claude 研究模型于 10 月 16 日发现,用了 1400 万输出 token、无人工输入,研究员随后与 Claude 一起改进论文表述
  • Lean 4 证明由 AI 模型编写,Lean v4.33.1 与 Mathlib 固定版本;README 称只依赖 Lean 三条标准公理,CI 还用独立内核 nanoda 复核
  • 仓库明确:结果纯属渐近意义,对实际求解 SAT 实例没有意义;目前仍待数学界独立审阅
  • 此前一天 OpenAI 也公布了其模型对 ETH 的反驳,两家结果目前都处于审阅阶段
阅读全文
关联模型 / 智能体 / 厂商:

Replit 推出 Replit for Business:提出「Agent Habitat」受管环境,让 Agent 在公司权限、审批和审计之内干活

Replit CEO Amjad Masad 10 月 26 日在官方博客《The Rise of the Self-Driving Company》中发布 Replit for Business。核心概念是 Agent Habitat:一个受公司控制的环境,Agent 在里面使用公司知识和系统、与人和其他 Agent 协作,由公司决定访问范围、何时需要人工审批,并限制出错影响。企业版页面列出 SSO、SCIM、基于角色的权限、BYOC(自带云)、审计日志、隔离执行、安全扫描和模型管控,以及 510+ 个连接器。Masad 称 Replit 工程师 2026 上半年代码产出接近翻三倍,评审时长、回滚和事故持平(厂商口径)。

Replit 推出 Replit for Business:提出「Agent Habitat」受管环境,让 Agent 在公司权限、审批和审计之内干活

核心要点速览

  • 内部数据(Replit 口径):工程师 2026 上半年代码产出接近 3 倍,评审时长、回滚和线上事故持平
  • 客户案例(厂商口径):三井住友融资租赁(SMFL)称原本 6 人 6 个月的开发流程由 1 人 1 周完成,原估约 30 亿日元的项目预计不到 10 亿日元完成
  • 企业控制项:SAML SSO、SCIM、基于角色的权限、BYOC、可搜索审计日志、隔离云环境执行、强制安全扫描、Security Center 与 Auto-Protect,管理员可管控可用模型
  • 生态:企业页面称有 510+ 个连接器,并集成 Microsoft Fabric 与 Databricks Lakebase/Apps;Windows 桌面版用 Microsoft Execution Containers 沙箱化本地构建
  • Masad 的判断(观点):到 2030 年底,财富 500 强都会成为「自动驾驶公司」;a16z 的 Marc Andreessen 同日发文背书
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

OpenAI 10 月 26 日发布 GPT-6.1 Terra,定位是兼顾视觉推理、精确电脑操作和自然写作的高效模型,今天起向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise、Edu 用户开放,API 模型名 gpt-6.1-terra。标准 API 价格为输入 $1、缓存输入 $0.05、输出 $5(每百万 token),官方称比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%;上下文 1,050,000 token。官方口径下,它在 Agents' Last Exam 上中等推理强度比 GPT-5.6 Terra 高 15 个百分点、成本约三分之一,Terminal-Bench 4.0 最高强度 50.3%。

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

核心要点速览

  • 价格(官方文档):输入 $1、缓存输入 $0.05、30 分钟缓存写入 $1.25、输出 $5 每百万 token;单次输入超过 272K token 时整单输入按 2 倍、输出按 1.5 倍计费;Batch/Flex 半价,Fast 模式 2 倍
  • 规格:上下文 1,050,000 token,最大输入 922,000、最大输出 128,000,知识截止 2026-06-01;reasoning.effort 支持 none 到 max 六档,工具调用需走 Responses API
  • 电脑操作(官方口径):Agents' Last Exam 中等强度比 GPT-5.6 Terra 高 15 个百分点、成本约 1/3,与 GPT-6 Astra 持平但每 token 价格只有其 1/10;完成速度比 GPT-6 Astra 和 GPT-6.1 Sol 快 3 倍以上
  • 编程与事实性(官方口径):Terminal-Bench 4.0 最高强度 50.3%,是 GPT-5.6 Terra 公布成绩 21.5% 的两倍多;内部易错题集低强度错误率从 53.6% 降到 16.7%
  • 安全:官方称在 Preparedness Framework 网络安全项达到 Critical 阈值,沿用 GPT-6 Astra 的防护措施
阅读全文