AI 编程实时动态与要闻

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

Mixpanel 创始人 Suhail Doshi 10 月 28 日(SGT 10 月 29 日 01:36)在 X 上宣布新公司 Particle,首个模型 Particle-1 已上线。官方博客称它在 DeepSeek V4.1 Flash 上用强化学习后训练,在四个编码与数据工程基准上输出 token 少 28.4%–52.2%、单任务成本低 34.4%–51.6%,通过率仍在基座模型置信区间内。可通过 Particle API、OpenRouter 和 Vercel AI Gateway 调用,官方文档标价每百万 token 输入 0.25 美元、输出 1 美元,上下文 1,048,576 token。

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

核心要点速览

  • 四个基准(Terminal-Bench 2.1、ReactBench、ADE Bench、DeepSWE 1.1)上输出 token 少 28.4%–52.2%,单任务成本低 34.4%–51.6%(官方口径)
  • 官方汇总表:每任务成本 0.2211 美元,对比 DeepSeek V4.1 Flash 0.3368 美元、GLM 5.3 Flash 0.6523 美元;平均输出 59,580 token,对比 83,246 和 98,155
  • 任务通过率 72.57%,对比基座 71.15%、GLM 5.3 Flash 66.82%;GPQA Diamond 90.40%(基座 90.91%)、MMLU 86.08%(基座 85.98%)
  • 训练方式:在全部层的专家上训练 rank-64 LoRA,可训练参数约占模型 1.25%,用 GSPO 序列级策略优化分两阶段 RL
  • 定价:官方文档当前为每百万 token 输入 0.25 美元、缓存输入 0.03 美元、输出 1.00 美元,上下文 1,048,576 token,单次输出上限 131,072 token
阅读全文

Inception 发布扩散语言模型 Mercury 3:每秒 1068 token、1M 上下文,官方称多项跑分超过 GPT-6 Luna 与 Haiku 5.5

Inception 10 月 19 日发布 Mercury 3,称其为迄今最强的扩散式大语言模型(dLLM)。官方口径:参数规模是 Mercury 1 的 40 倍以上,输出速度 1068 token/秒,上下文从 Mercury 2.5 的 26 万扩到 100 万 token,在 GPQA Diamond、IFBench、SWE-Bench Atlas 等基准上超过 GPT-6 Luna 与 Claude Haiku 5.5(均为 medium 档)。标价每百万输入 0.20 美元、输出 0.70 美元,首发五折。已上线 Inception API、OpenRouter、Baseten 和 Vercel AI Gateway,兼容 OpenAI API。跑分均为厂商自测,暂无独立复现。

Inception 发布扩散语言模型 Mercury 3:每秒 1068 token、1M 上下文,官方称多项跑分超过 GPT-6 Luna 与 Haiku 5.5

核心要点速览

  • 速度:输出 1068 token/秒,官方对比表中 GPT-6 Luna 约 130、Haiku 5.5 约 240(厂商口径)。
  • 跑分:GPQA Diamond 89.23、IFBench 76.84、SWE-Bench Atlas 51.08,均高于 Luna 与 Haiku 5.5;但 DeepSWE v1 46.31 低于 Haiku 5.5 的 51.62,MRCR v2 也落后 Haiku。
  • 规模与上下文:参数是 Mercury 1 的 40 倍以上,上下文 100 万 token(Mercury 2.5 为 26 万)。
  • 价格:标价输入 $0.20/M、输出 $0.70/M,首发五折为 $0.10/$0.35,缓存输入再打 1 折;新 API key 赠 1 亿 token。
  • 渠道:Inception API、OpenRouter、Baseten、Vercel AI Gateway,OpenAI API 兼容,可直接替换。
阅读全文
关联模型 / 智能体 / 厂商:

Perplexity 发布开源权重多模态决策模型 pplx-decider-v1.2(27B)与 Flash(4B):图文直出类型化概率决策,输入仅 $0.02/百万 Token

Perplexity 开发者团队(@perplexitydevs)联合 OpenRouter 与 Vercel AI Gateway 正式上线新一代开源权重多模态决策模型 pplx-decider-v1.2(27B)与轻量级 pplx-decider-flash-v1.2(4B)。该系列模型支持同时输入文本与图像,直接返回带校准概率分布的类型化决策结果(Typed Answers with Probabilities),其中 27B 版本输入定价低至 $0.02/百万 Token,4B Flash 版速度更快且成本再砍半,成为智能体路由与工具选择的极速基础设施。

Perplexity 发布开源权重多模态决策模型 pplx-decider-v1.2(27B)与 Flash(4B):图文直出类型化概率决策,输入仅 $0.02/百万 Token

核心要点速览

  • 双尺寸多模态决策模型上线:发布 27B 旗舰版 pplx-decider-v1.2 与 4B 极速版 pplx-decider-flash-v1.2,支持图文输入直出类型化概率决策
  • 输入定价低至 $0.02/百万 Token:27B 版本仅售 $0.02/1M 输入 Token,4B Flash 版本速度更快且成本再减半
  • OpenRouter 与 Vercel 同步首发:支持 pplx-decider-latest 动态别名,专为智能体工具路由、护栏审查与多模态状态分类打造
阅读全文
关联模型 / 智能体 / 厂商:

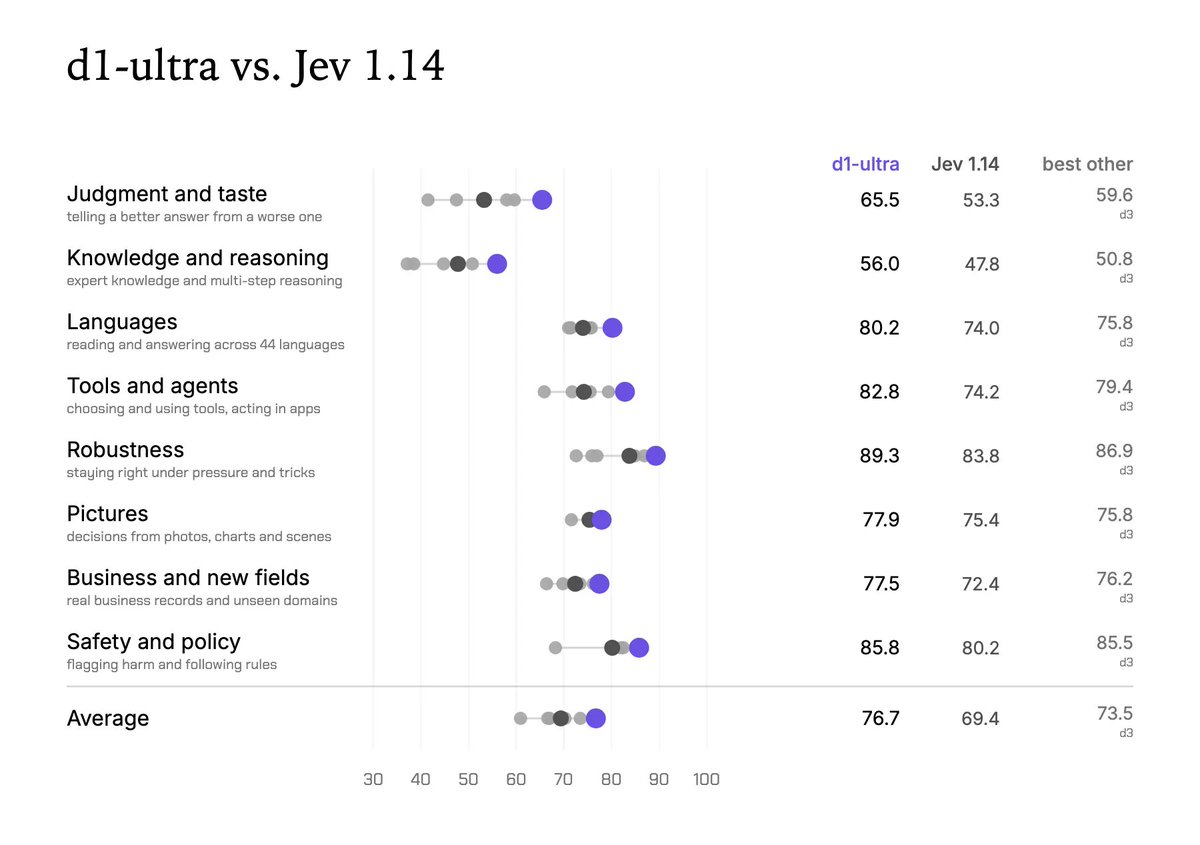
Liquid AI 发布 d1-ultra 决策模型:不生成 token 直接输出校准概率,Artificial Analysis Decision Index 以 65 分居首,输入 $0.042/百万 token

Liquid AI 于 10 月 15 日发布多模态决策模型 d1-ultra,输入文本和图像,一次前向传播直接返回是非、单选、打分三类问题的概率,不生成任何 token,只按输入计费。Artificial Analysis 独立评测中它以 65 分登顶 Decision Index v1.0,领先至少 8 分,非幻觉率 85%;已上线 Liquid API、Vercel AI Gateway 与 OpenRouter。

Liquid AI 发布 d1-ultra 决策模型:不生成 token 直接输出校准概率,Artificial Analysis Decision Index 以 65 分居首,输入 $0.042/百万 token

核心要点速览

  • Artificial Analysis Decision Index v1.0 得分 65,第一名,领先其他决策模型至少 8 分(独立评测)
  • AA-Omniscience-Decision 非幻觉率 85%,第二名 Microsoft-Decision-1 为 40%;但因更多弃答,准确率 32% 低于 d1 的 41%
  • 定价 $0.042 / 百万输入 token,输出免费;1024×1024 图像计 1,536 token(官方博客)
  • 上下文 32,768 token,支持 44 种语言,Liquid 自有 112 项评测中八大类全部领先(厂商口径)
  • 调用方式:Liquid /decisions/v1/systemone 端点 model: d1-ultra,或 Vercel/OpenRouter 的 liquid/d1-ultra(文档)
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

蚂蚁百灵 Ling-3.1-flash:560B/25B 激活 MoE;厂商报 SWE-Pro 65.39、CyberGym 87.9;Vercel/OpenCode 免费到 10/13

蚂蚁集团 InclusionAI 于 2026-09-30 公布 Ling-3.1-flash:约 560B 总参、每 token 激活约 25B 的混合推理 MoE,设计上下文最高 1M(试用/网关当前多暴露 256K–262K)。权重尚未上 Hugging Face;Vercel AI Gateway 与 OpenCode Zen 提供限时免费(至约 2026-10-13)。厂商自报含 SWE-Pro 65.39、Terminal-Bench 4.0 40.40、CyberGym 87.90——均未独立复现。

蚂蚁百灵 Ling-3.1-flash:560B/25B 激活 MoE;厂商报 SWE-Pro 65.39、CyberGym 87.9;Vercel/OpenCode 免费到 10/13

核心要点速览

  • 规模:约 560B 总参 / 25B 激活(对比 Ling-3.0-flash 的 124B/5.1B);设计最高 1M 上下文,试用期/网关当前常见 256K–262K
  • 架构(官方摘要):提高线性 Attention 比例——7 层 KDA : 1 层 Gated MLA;512 路由专家选 8 + 1 共享专家
  • 厂商基准(未独立复现):SWE-Pro 65.39、Terminal-Bench 4.0 40.40、CyberGym 87.90、BrowseComp 91.67;对标表含 DeepSeek-V4.1-Flash / GLM 5.3 flash 等
  • 可用性:Vercel AI Gateway inclusionai/ling-3.1-flash / -free(Novita),免费到约 10/13;OpenCode Zen ling-3.1-flash-free
  • 风险:权重未开源;免费通道可能用于改进模型(勿喂专有代码);HealthBench 等分数带「AQ 环境」脚注
阅读全文

Vercel:Grok 4.7 上线 AI Gateway,9 月 27 日前四折优惠

@vercel 宣布 Grok 4.7 已登陆 Vercel AI Gateway,并提供至 9 月 27 日的 40% 折扣;可在 v0、eve 与 fx 中试用。面向在 Vercel 栈上搭建应用与编码智能体的开发者,降低试用 Grok 4.7 的门槛。

核心要点速览

  • Grok 4.7 已上线 Vercel AI Gateway。
  • 至 9 月 27 日 AI Gateway 上 Grok 4.7 四折。
  • 可与 v0、eve、fx 一起试用。
阅读全文
关联模型 / 智能体 / 厂商:

Cline 发布 jev-browser 插件:在 Desktop 内为 TypeSafe Jev 挂载后台 Chrome 浏览器

Cline 宣布推出 Marketplace 插件 jev-browser,可在 Cline Desktop 中为 TypeSafe Jev 提供后台 Chrome。安装后配置 Vercel AI Gateway API Key,即可让决策模型在浏览器任务中自主打开页面完成操作,团队称实测效果令人惊喜。

核心要点速览

  • 在 Cline Desktop:Customize > Marketplace > Plugins 搜索并安装 jev-browser。
  • 将 Vercel AI Gateway API Key 写入 ~/.cline/plugins/cline-jev-browser.config.json 后重启 Cline。
  • 浏览器类任务会后台启动 Chrome;把 Jev 决策模型与真实网页操作打通。
阅读全文

OpenRouter 上线 TypeSafe Jev(测试版):面向应用状态的概率决策模型,无需 JSON 解析

OpenRouter 宣布 TypeSafe 的 Jev 已以测试版接入平台。Jev 被定位为 System One 模型:输入应用状态与类型化问题,直接返回带概率的类型化决策,无需 JSON 提示、解析层或结果校验。此举让开发者可在 OpenRouter 路由层调用 Jev,补齐此前已登陆 Vercel AI Gateway 的接入路径。

核心要点速览

  • Jev 以测试版登陆 OpenRouter,面向应用状态做类型化概率决策而非生成长文本。
  • 无需 JSON 提示、解析层与结果校验,降低 Agent/工具调用中的结构化输出摩擦。
  • 与此前 Vercel AI Gateway 接入形成互补,开发者可在多网关间选用同一决策模型。
阅读全文
关联模型 / 智能体 / 厂商:

Vercel AI Gateway 九月指数:开源权重模型首次占 Token 量 56%,Astra 花费超 Fable 5.1 一倍

Vercel 发布 AI Gateway Production Index(2026 年 9 月,数据截至 8 月)。开源权重模型首次占网关 Token 量多数,从去年 12 月的 7% 升至 8 月的 56%;平均 Token 价格连续第三个月下降,8 月再降 23.2%。特别报告显示 GPT-6 Astra 上线 12 天内占全网关花费 7.7%,约为同期 Fable 5.1 的两倍。

核心要点速览

  • 开源权重模型首次占 AI Gateway Token 量 56%,较 2025 年 12 月的不足 10% 大幅跃升。
  • 8 月平均 Token 价格再降 23.2%,连续第三个月下跌;百万 Token 以上团队中位数花费下降 7.6%。
  • GPT-6 Astra 上线 12 天占全网关花费 7.7%,约为同期 Anthropic Fable 5.1 的两倍,并在两天内占 OpenAI 花费约三分之一。
阅读全文
关联模型 / 智能体 / 厂商:

TypeSafe Jev 正式登陆 Vercel AI Gateway:面向软件的概率决策模型,并行返回 typed Choice/Score/Boolean

TypeSafe AI 宣布 Jev 已在 Vercel AI Gateway 上线。Jev 是面向软件工作流的概率决策模型:输入 state,并行评估声明的问题,直接返回 typed Choice、Score、Boolean 及概率,减少「先生成文本再解析校验」。TypeSafe 称在其工作流评测上相对 LLM 最高约 193.6× 更快、444.6× 更便宜。典型用途包括 Agent 循环选工具/子智能体、继续/重试/询问/停止、行动前风险打分与输出护栏。AI SDK 7(≥7.0.105)经 experimental evaluate API 调用 model typesafe-ai/jev;支持按请求开启 Zero Data Retention / No Training,并计入 Gateway 日志与预算。

核心要点速览

  • Jev 已在 Vercel AI Gateway 上线:并行评估问题并返回 typed Choice/Score/Boolean + 概率
  • TypeSafe 称工作流评测相对 LLM 最高约 193.6× 更快、444.6× 更便宜
  • AI SDK 7 evaluate API 调用 typesafe-ai/jev,支持按请求 ZDR/No Training 并计入 Gateway 预算
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Vercel:TypeSafe Jev 将接入 AI Gateway,安全审阅较 GPT Luna 提速约 18 倍且更准

Vercel CEO Guillermo Rauch 称团队在 fx 默认 auto 模式下用安全审阅器检查每条命令:当前跑在 GPT Luna,而 TypeSafe 的 Jev 在 p95 上可达约 18 倍更快且更准确,并将接入 Vercel AI Gateway,有望成为新默认。此前 Vercel 工程师也报告 Jev 在分类评测上相对 Gemini 2.5 Flash Lite 质量饱和且快约 6 倍。

核心要点速览

  • Rauch:Jev 将进入 Vercel AI Gateway,或成新默认安全审阅模型
  • 相对 GPT Luna,Jev 在 p95 可达约 18 倍更快且更准确
  • 配套评测:Jev 相对 Gemini 2.5 Flash Lite 质量饱和、速度约 6 倍
阅读全文
关联模型 / 智能体 / 厂商:

Vercel v0 宣布模型无关:经 AI Gateway 可选 Claude / GPT / Kimi / GLM / Grok / DeepSeek 等

Vercel v0(@v0)宣布产品改为模型无关:通过 Vercel AI Gateway,可在前沿、廉价、开源与低延迟模型之间切换,覆盖 Claude、GPT、Kimi、GLM、Grok、DeepSeek 等,用于在 v0 内构建应用而无需绑定单一模型供应商。

核心要点速览

  • v0 经 AI Gateway 变为模型无关,不再绑死单一供应商。
  • 可选 Claude、GPT、Kimi、GLM、Grok、DeepSeek 等前沿/廉价/开源/低延迟模型。
  • 由 @v0 官方宣布,构建工作流可随任务换模型与成本画像。
阅读全文
关联模型 / 智能体 / 厂商: