AI 编程实时动态与要闻

X 热议:Vercel CEO Guillermo Rauch 喊话「拥有你自己的智能」,呼吁本地模型继续普及、自己掌握 Agent 的 harness 与数据

Vercel CEO Guillermo Rauch 11 月 1 日在 X 上发帖:「拥有你自己的智能。任何反对这一点的人都有东西要卖给你(也许是把你自己的智能再卖回给你)。」他认为本地模型需要继续普及,超大模型暂时跑不了本地,所以最好的选择是保持选择权:自己掌握 harness、数据、连接和运行时,也就是自己的 Agent,并拥抱开源。帖子约 12 小时内获得约 2500 赞、12.8 万浏览,100 多条引用,讨论集中在本地与云端如何取舍。

核心要点速览

  • 这是 Rauch 的个人观点帖,不是 Vercel 官方公告或产品发布。
  • 原帖(2026-11-01 21:08 UTC)约 2533 赞、255 转发、266 回复、107 引用、12.8 万浏览,581 次收藏(抓取时数据)。
  • 核心主张:本地模型要继续普及;在超大模型跑不了本地之前,保持选择权,自己掌握 harness、数据、连接、运行时和 Agent,拥抱开源。
  • Maple AI 联合创始人兼 CEO Mark(@marksuman)引用回应:会是混合形态,云端永远更强,未来要把本地优先的 AI 和私有云配合起来。
  • 工程师 Shantanu Goel(@shantanugoel)引用称「Guillermo 说出了多数人不愿说的真话」,约 37 赞。
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:Sam Altman 称个人电脑占用稀缺 DRAM「相当糟糕」,本地推理派强烈反弹

Stripe 联合创始人 John Collison 的 Cheeky Pint 播客 10 月 29 日上线 Sam Altman 专访。谈到内存短缺时,Altman 说很多人以为开源模型加本地推理就能绕开算力紧张,但从全球配置角度看,让每个人电脑里放着一堆稀缺 DRAM、只有约 5% 的时间在用「相当糟糕」,供给紧张时应追求云端的最大利用率。pubity 转述这段话的帖子获得 2.6 万多点赞、800 多万次浏览,大量用户反驳称 PC 内存并非只为 AI 服务,本地模型还关乎隐私和离线可用。以下按观点讨论整理,不代表已证实结论。

X 热议:Sam Altman 称个人电脑占用稀缺 DRAM「相当糟糕」,本地推理派强烈反弹

核心要点速览

  • 出处:Cheeky Pint 播客 10 月 29 日 Sam Altman 专访,官方文字稿可查,原话含「being used 5% of the time」
  • Altman 的论点:DRAM 供给紧张时,放在个人电脑里的内存利用率低,云端数据中心可持续服务多用户,应追求最大利用率
  • 热度(X API,10 月 31 日 13:06 SGT 读取):pubity 帖 26,124 赞、8,557 条引用、5,210 条回复、约 806 万次浏览
  • 主要反驳:PC 内存还要跑系统、浏览器和游戏;本地模型让数据留在本机;也有人指出这与 OpenAI 的云端商业模式一致
  • 5% 这个数字 Altman 未解释口径,媒体建议当作粗略估计而非测量值
阅读全文
关联模型 / 智能体 / 厂商:

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

LM Studio 于 10 月 29 日 15:32(UTC)在 X 上宣布,用户现在可以在 LM Studio 里下载新的 oMLX 引擎,直接用于已下载的 MLX 模型;官方更新日志把它列为 Bionic 1.1.10 的新功能,同版本还加入 MLX 模型投机解码和应用内终端。oMLX 是韩国开发者 jundot 维护的 Apple Silicon 开源推理服务器(Apache 2.0,GitHub 约 2.3 万星),主打连续批处理和内存加 SSD 的两级 KV 缓存。官方未公布 LM Studio 内的速度对比。

LM Studio Bionic 1.1.10 接入 oMLX 引擎:Mac 本地模型可用内存加 SSD 两级 KV 缓存,并支持 MLX 投机解码

核心要点速览

  • LM Studio 官方宣布可在应用内下载 oMLX 引擎,直接使用已有 MLX 模型,原帖约 540 赞(原帖)
  • Bionic 1.1.10 更新日志(10 月 29 日)同时列出 MLX 投机解码、应用内终端公开可用和 llama.cpp 2.66.0 扩展包(更新日志)
  • oMLX 为 Apache 2.0 开源项目,GitHub 约 23,000 星,要求 macOS 15+ 与 Apple Silicon(M1 到 M5)(GitHub)
  • oMLX 的核心是两级 KV 缓存:热块放内存,溢出块以 safetensors 格式写入 SSD,前缀相同的请求甚至重启后也可从磁盘恢复
  • LM Studio 未公布该引擎与原 MLX 引擎的速度对比;发布后已有用户反馈「重启以应用更新」失败,官方正在排查
阅读全文

Ollama 原生支持 Recursive Flint 40B:首个 2.5B 激活参数轻量 MoE 编程智能体模型,MacBook Pro 跑出 125+ tok/s

由 Richard Socher 创办的 Recursive 正式开源 39.8B(40B)混合专家(MoE)编程智能体模型 Flint(RecursiveSI/flint),采用 Apache 2.0 协议并在 Ollama(ollama run flint)与 llama.cpp 全面开箱即用。该模型每 Token 仅激活 2.5B 参数,拥有 262K 超长上下文,在 M4 Pro MacBook Pro 上可实现 125+ tokens/秒的超高速本地推理。在 SWE-bench Verified 取得 74.2%、SWE-bench Pro v2 达到 89.7%,成为 50B 以下端侧运行最强编程智能体底座。

Ollama 原生支持 Recursive Flint 40B:首个 2.5B 激活参数轻量 MoE 编程智能体模型,MacBook Pro 跑出 125+ tok/s

核心要点速览

  • Flint 采用 49 层 Transformer 架构(2 层密集层 + 47 层 MoE 层),总参数 39.8B,每 Token 激活仅 2.5B 参数
  • 原生配备 262,144 tokens(256K)超长上下文窗口,支持端到端仓库级代码理解与跨文件缺陷定位
  • 本地推理性能极佳,M4 Pro MacBook Pro 达 125+ tok/s,64GB RTX Spark 可达 150+ tok/s
  • 在 SWE-bench Verified 取得 74.2%,SWE-bench Pro v2 达 89.7%,LiveCodeBench v6 斩获 80.3%,支持 ollama run flint 一键拉取
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

Hermes Agent v0.22.0 发布:免 Key 引导上手、一键本地 llama.cpp 模型、Gmail/Linear/Notion 连接器与 600 插件目录

Nous Research 于 10 月 14 日(UTC)发布开源智能体 Hermes Agent v0.22.0「Threshold Release」。新装桌面版用免费试用模型 nous/welcome 引导配置,无需 API Key;新增经 Nous tool gateway 接入 Gmail、Linear、Notion 的连接器;内置一键 llama.cpp 本地模型运行时;改为经过测试的 SemVer 稳定通道,并提供签名桌面包(含 Microsoft Store)。官方称这是史上最大更新窗口,代码量从约 106 万行精简到 69.8 万行(−34%)。

Hermes Agent v0.22.0 发布:免 Key 引导上手、一键本地 llama.cpp 模型、Gmail/Linear/Notion 连接器与 600 插件目录

核心要点速览

  • 规模:自 v0.21.0 以来约 24,200 次提交、6,080 个合并 PR、关闭约 7,180 个 issue、约 2,520 名贡献者,约为 v0.21.0 周期的 2.5 倍(Release Notes)
  • 瘦身:源码约 106 万行降到 69.8 万行(−34%),gateway/run.py 从 34,847 行降到 5,512 行;约 19 个冷门工具改为按需加载,桌面端每次调用的工具 schema 约减半,固定提示再省约 2.1k token
  • 本地模型:自动按 CPU/CUDA/Metal/Vulkan/ROCm 安装 llama.cpp(b11370),只推荐能完整放进显存的模型,目录含 Qwen3.8 27B、Qwen3.6 35B-A3B、DeepSeek V4 Flash 及任意 Hugging Face GGUF
  • 插件目录 600 个,每个固定到经过审查的 commit;Honcho、Mem0、Supermemory 等记忆后端移出核心
  • 更新提速:只重建变化部分,macOS 上 16.5 秒 vs 32.5 秒(官方口径)
阅读全文

NVIDIA 推出 DGX Spark 64GB:10/23 起 OEM 开卖起价 $4,999;双机集群最高约 1.7×,本地跑至约 100B

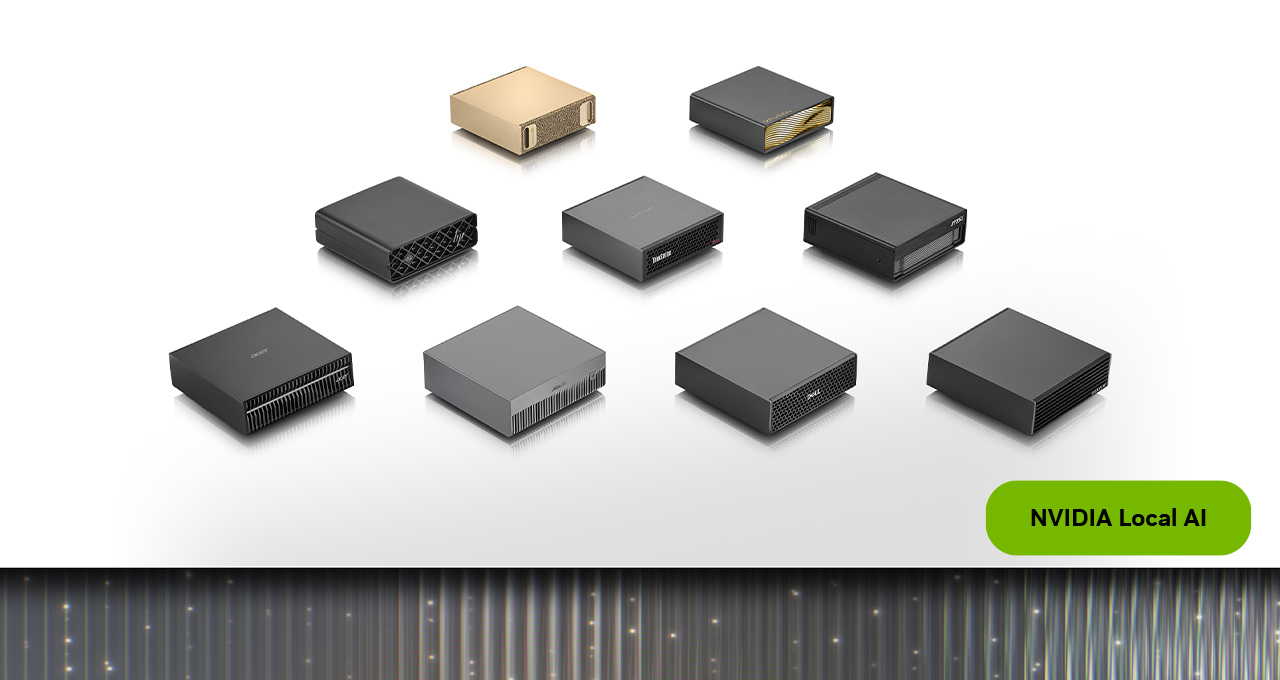
NVIDIA 于 2026-10-02 在博客宣布 DGX Spark 64GB:10 月 23 日(周五) 起经 Acer / ASUS / Dell / Gigabyte / HP / MSI 发售,起价 $4,999。同款 GB10 Grace Blackwell、DGX OS 与完整 CUDA AI 栈;单机统一内存 64GB、官方称可本地支撑约 100B 参数模型与 Agent。两台经 ConnectX-7 + QSFP 集群可池化 128GB(约 200B);Qwen 3.8 27B 测试中双 64GB 相对单机最高约 1.7×。

NVIDIA 推出 DGX Spark 64GB:10/23 起 OEM 开卖起价 $4,999;双机集群最高约 1.7×,本地跑至约 100B

核心要点速览

  • 官宣:NVIDIA Blog — DGX Spark 64GB(Allen Bourgoyne,2026-10-02)
  • 渠道与价格:2026-10-23 起 OEM(Acer/ASUS/Dell/Gigabyte/HP/MSI);博客写明 starting at $4,999;64GB 仅经参与 OEM
  • 算力栈:保留 GB10 + DGX OS + CUDA AI;开箱支持 Agent Toolkit、Ollama、vLLM、PyTorch、Nemotron 等
  • 扩展:内置 ConnectX-7;双机 QSFP 直连池化 128GB / 约 200B 参数;Qwen 3.8 27B 实测双机相对单机最高约 1.7×
  • 月底预告:NVIDIA Sync Model Launcher 可一键拉起 Qwen3.8 27B,并配置 OpenCode 走本地模型
阅读全文

Cline Desktop v0.0.35:官方 Linux x64 .deb/.rpm 上线,插件斜杠命令与 Diagnostics 导出同步到位

Cline 于 2026-09-24 发布 Desktop v0.0.35:首次随 macOS/Windows 一并提供 Linux x64 的 .deb 与 .rpm(暂无 AppImage);Open folder 走 GTK 原生选择器,更新在后台下载并在「Restart now」时安装。同版还让插件注册的斜杠命令真正执行 handler、新增可脱敏的 Diagnostics 导出,并修复本机模型触顶输出上限时直接失败等问题。

Cline Desktop v0.0.35:官方 Linux x64 .deb/.rpm 上线,插件斜杠命令与 Diagnostics 导出同步到位

核心要点速览

  • Linux 首发包:Cline_0.0.35_amd64.deb / Cline_0.0.35_x86_64.rpm;官方说明暂无 AppImage
  • 插件斜杠命令(如 /goal)不再当纯文本喂模型,会跑 handler;坏插件不再拖垮整个斜杠菜单
  • Settings → Diagnostics → Export 生成脱敏文本(去 API Key/凭证形字段/提示词/家目录路径),便于贴 GitHub issue
  • 本机 llama.cpp / Ollama / LM Studio 触顶输出上限时先 compact 再重试一次,而非直接失败
  • 模型目录刷新至 6,386;19 家默认模型变更,其中 11 家默认切到 Claude Opus 5.5(含 GitHub Copilot、Vertex)
阅读全文

GitHub Next 开源 LocalJev:用 oMLX 在本地跑兼容 Jev 的决策 API

GitHub Next 开源 LocalJev(github.com/githubnext/localjev):在团队尚未全员拿到 TypeSafe Jev 访问权时,用一上午搭出「穷人版 Jev」。它在 Bun/TypeScript 上提供兼容的 POST /v1/systemone API,默认经 oMLX 调用本地 DiffusionGemma 等模型,并评测了 DiffusionGemma、Qwen MoE、Gemma 4 MoE 与 Gemma 4 e4b/e2b;评测报告在仓库内。LocalJev 服务器可对接常规 Jev API 封装库,但概率来自模型自报而非 logit 直读,需自行校准。

核心要点速览

  • 开源 LocalJev:本地兼容 Jev 的 POST /v1/systemone 决策 API(Bun/TypeScript)。
  • 默认经 oMLX 跑 DiffusionGemma 等本地模型,并附多模型评测报告。
  • 可对接常规 Jev 客户端库;概率为模型自报而非 logit 直读,需自行校准。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ diffusiongemma⚡ qwen⚡ Gemma 4🌐 github

Magnitude 开源本地推理服务:按硬件选型跑模型,可接入 Codex / Claude Code / Cline / Hermes

开源项目 magnitudedev/magnitude(Apache-2.0,约 3.1k stars)是本地推理服务:剖析本机硬件、推荐合适本地模型,再下载、调优并运行;可接到 Codex、Claude Code、Cline、Hermes。模型按需加载,内存紧张时自动卸载,便于在已有编码智能体里用本地模型。

核心要点速览

  • 开源:magnitudedev/magnitude,Apache-2.0,约 3.1k stars。
  • 能力:硬件剖析、推荐本地模型、按需加载/内存紧张卸载。
  • 接入:Codex、Claude Code、Cline、Hermes。
阅读全文
关联模型 / 智能体 / 厂商: