AI 编程实时动态与要闻

Fireworks 首届 Forge 大会发布一批新品:Ultra-fast 推理公测达 1500 tokens/秒,Background Mode 半价,Nexus Desktop 接入 Codex 与 Claude Desktop,Sovereign 私有部署预览

开源模型推理平台 Fireworks 11 月 3 日在首届 Forge 大会上发布一批新产品:基于 NVIDIA Blackwell 的 Ultra-fast 进入公测,在 DeepSeek V4.1 Flash 上最高 1500 tokens/秒,30 轮 Agent 任务从 1 分钟降到 8 秒;可等待任务的 Background Mode 半价;新增多日 Prompt 缓存和更高限流。Nexus Desktop 把开源模型路由带进 Codex app、Claude Desktop 和 OpenCode,Pro 每月 8 美元起;还有 No Eval、LoRA 无服务器推理、Fireworks Sovereign 私有部署等,并宣布 60+ 伙伴的 Frontier Ecosystem。

Fireworks 首届 Forge 大会发布一批新品:Ultra-fast 推理公测达 1500 tokens/秒,Background Mode 半价,Nexus Desktop 接入 Codex 与 Claude Desktop,Sovereign 私有部署预览

核心要点速览

  • Ultra-fast 公测:基于 NVIDIA Blackwell,在 DeepSeek V4.1 Flash 上最高 1500 tokens/秒;官方基准中 30 轮 Agent 任务耗时从 1 分钟降到 8 秒(Fireworks 官方博客)
  • 省钱选项:Background Mode 对可等待任务半价;多日 Prompt 缓存降低反复恢复上下文的成本;更高的 serverless 限流和 Elastic Burst 已正式可用
  • Nexus Desktop 上线:开源与闭源模型按个人路由,可在 Codex app、Claude Desktop、OpenCode 中使用;Pro 每月 8 美元起,Teams 每席每月 10 美元起
  • 训练侧:No Eval 私测,把生产 trace 转成任务评测;LoRA 无服务器推理公测,先支持 GLM 5.3 Flash,按 token 计费、空闲不收费;Muse Glimmer 30B 免费训练至 11 月 30 日
  • 企业侧:Fireworks Sovereign 私测,把推理引擎部署进客户自己的云或机房;官方称已在客户环境管理超过 2.5 万块 GPU;同时宣布 60+ 伙伴的 Frontier Ecosystem
阅读全文

OpenAI API 上线 12 小时提示词缓存:GPT-5.6 及以后模型可把共享指令缓存半天,写入按 2.5 倍输入价、读取仍是 0.1 倍

10 月 20 日,OpenAI 在 Responses API 推出 12 小时提示词缓存:GPT-5.6 及以后的模型可把 prompt_cache_options.ttl 设为 "12h",让系统指令、工具定义和参考资料在请求间隔几个小时后仍按缓存价计费。12 小时写入按普通输入价的 2.5 倍收费,默认 30 分钟写入为 1.25 倍;读取价不变,多数模型为 0.1 倍,GPT-6.1 Sol 为 0.05 倍。同一请求里可以给不同断点分别设 12 小时和 30 分钟。

核心要点速览

  • 新参数:Responses API 中 prompt_cache_options.ttl 可选 "30m"(默认)或 "12h",也可用 prompt_cache_breakpoint.ttl 给单个断点单独设置,适用于 GPT-5.6 及以后模型
  • 费率(官方口径):30 分钟写入 1.25 倍、12 小时写入 2.5 倍普通输入价;读取多数模型 0.1 倍,GPT-6.1 Sol 为 0.05 倍,两种时长读取价相同
  • 按文档费率推算:同一前缀一天内每隔 1 小时复用 6 次,用 30 分钟缓存每次都要重写,约 6×1.25=7.5 倍输入成本;用 12 小时缓存约 2.5+5×0.1=3.0 倍
  • 每个请求最多 4 次缓存写入,最小可缓存前缀 1,024 个可见 token;用量里新增 ttl_30m_tokens 与 ttl_12h_tokens 两项拆分计费
  • "12h" 只是最低保留时长,不代表删除期限,也不保证每次都命中或降低延迟;GPT-5.5 及更早模型仍用 prompt_cache_retention
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI:GPT-6 API Prompt Caching 默认命中率提升,缓存输入最高可省 90%

OpenAI Developers(@OpenAIDevs)宣布 GPT-6 API 的 Prompt Caching 已改进:默认缓存命中率更高,更多输入 Token 可享受最高约 90% 的缓存输入折扣,有助于 Agent 跑得更快、更省。官方文档同步强调可用 Prompt Caching Dashboard 观察命中率,并用 Diagnostics 排查未命中。

OpenAI:GPT-6 API Prompt Caching 默认命中率提升,缓存输入最高可省 90%

核心要点速览

  • GPT-6 API Prompt Caching 默认命中率提升,面向长程 Agent 更省、更快。
  • 缓存输入 Token 折扣最高约 90%。
  • 可用 Dashboard 看命中率,并用 Diagnostics 排查 cache miss。
阅读全文

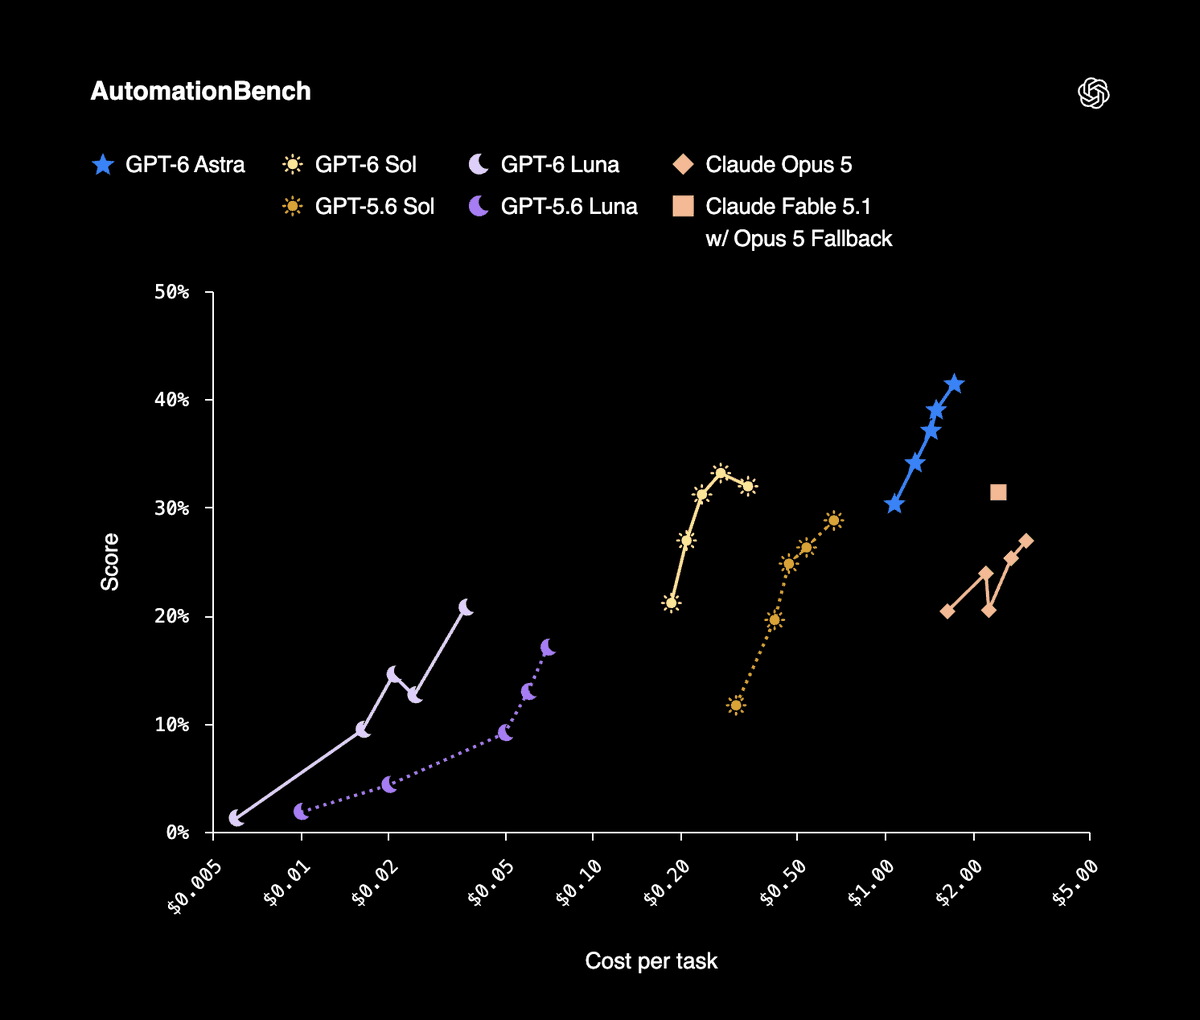
OpenAI 推出 GPT-6 Sol 与 Luna:企业级双主力模型登场,API 价格腰斩低至 $0.10/M

OpenAI 宣布 GPT-6 家族迎来两款企业级主力模型 —— GPT-6 Sol 与 GPT-6 Luna。两款模型继承了月初旗舰 GPT-6 Astra 的核心智能,通过新型投机解码与推理管线优化,将 API 价格较此前促销价腰斩 50%:高精度任务专用的 Sol 定价为 $2/$10 每百万 Token,高吞吐低延迟专用的 Luna 仅需 $0.10/$0.50 每百万 Token,且提示词缓存读取享受 90% 极限制扣。即日起登陆 ChatGPT Work 与 Codex,并向全量开发者开放 API。

OpenAI 推出 GPT-6 Sol 与 Luna:企业级双主力模型登场,API 价格腰斩低至 $0.10/M

核心要点速览

  • 双模型分层矩阵:GPT-6 Sol 主打高精度复杂代码与智能体规划,GPT-6 Luna 主打高并发超低成本数据处理与辅助补全。
  • 价格腰斩:Sol 为 $2.00 输入 / $10.00 输出;Luna 仅需 $0.10 输入 / $0.50 输出,配合 90% 缓存读取折扣性价比极高。
  • 全生态立即上线:API 标识 gpt-6-sol 与 gpt-6-luna,同步开放于 ChatGPT Work、Codex,桌面端面向全量用户开放 Luna 体验。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

月之暗面:Kimi K3 上线 Amazon Bedrock,支持编码与长程智能体工作流及显式 Prompt Caching

@Kimi_Moonshot 宣布 Kimi K3 已登陆 Amazon Bedrock,可用于编码、文档分析与长程智能体工作流,并接入 Bedrock 的访问控制、加密与审计;同时支持显式 Prompt Caching。官方文档指向 AWS Bedrock 模型卡,方便企业在 AWS 栈内直接调用。

月之暗面:Kimi K3 上线 Amazon Bedrock,支持编码与长程智能体工作流及显式 Prompt Caching

核心要点速览

  • Kimi K3 已上线 Amazon Bedrock。
  • 面向编码、文档分析与长程智能体工作流,并带 Bedrock 访问/加密/审计。
  • 支持显式 Prompt Caching;可按 AWS 官方模型卡接入。
阅读全文

Codex 任务中途用 Jev 动态调 GPT-6 Astra 推理力度:自测 Astra 成本约降 50% 且不破 prompt cache

@miu21590 演示在 Codex 运行过程中用 Jev 动态调整 GPT-6 Astra 的 reasoning effort:卡住时多想、常规步骤少想;作者称自测 Astra 成本约降 50%、跑得更快,且不破坏 prompt caching。相对「开跑前用 Jev 选模型」的常见用法,这是把决策模型接到任务中途控成本。

Codex 任务中途用 Jev 动态调 GPT-6 Astra 推理力度:自测 Astra 成本约降 50% 且不破 prompt cache

核心要点速览

  • 在 Codex 任务执行中途调用 Jev,动态升降 GPT-6 Astra reasoning effort。
  • 作者自测:Astra 成本约降 50%,更快,且不破坏 prompt cache。
  • 相对开跑前选模型,把决策模型接到中途控成本。
阅读全文
关联模型 / 智能体 / 厂商:

Google AI Studio 发布托管智能体与 Antigravity Preview 编程模型

Google AI Studio 推出全新托管智能体(Managed Agents)架构与专属底座模型 antigravity-preview-09-2026。系统深度升级了面向软件研发的代码缓存(Prompt Caching)机制与大文件仓 File API,支持在极低延迟下直接挂载数万行私有仓库并维持多轮无损推理。

核心要点速览

  • 上线 Managed Agents 架构与专有编程模型 antigravity-preview-09-2026
  • 引入仓库级 Prompt Caching 机制,代码工程重复上下文资费直降 80%
  • 强化 File API 与沙箱挂载能力,极大提升跨文件大工程的推理准确率
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Antigravity Preview 09.2026🤖 Managed Agents🌐 Google

Bench v2.1.0:给 Claude Code 加宪法与三阶段改动审查,含安装器/CLI 与 1036 测试

Dana(@MatureIntellect)发布 Bench v2.1.0:用书面宪法约束 Claude Code,每条拟议编辑走三阶段审查并写入防篡改账本;本版加入 prompt caching、分阶段模型控制、正式安装器/CLI、并发锁、成本/延迟周报,以及 1,036 项测试。

核心要点速览

  • 版本:Bench v2.1.0(benchgov.com)。
  • 治理:宪法 + 三阶段编辑审查 + 防篡改账本。
  • 工程:安装器/CLI、prompt caching、并发锁、1036 测试、成本/延迟报告。
阅读全文
关联模型 / 智能体 / 厂商:

DeepSeek 官方开放长上下文 Prompt Caching 降价方案:缓存命中单价低至每百万 Token 0.1 元

DeepSeek 宣布对其开放平台 API 全量上线自动 Prompt Caching 机制。当开发者在会话中重复传递系统 Prompt、大型仓库上下文或历史代码切片时,缓存命中的输入 Token 单价直降至 0.1 元/百万 Tokens(折合约 $0.014/M),使构建自主代码 Agent 的 API 综合使用成本降低 85% 以上。

核心要点速览

  • 缓存命中输入单价仅需 ¥0.1 / 1M Tokens,支持长达 64k 的上下文切片自动命中。
  • 无需手动声明缓存块,平台网关根据前缀哈希自动实现透明缓存与费率核减。
  • 大幅降低了终端 Agent(如 Aider、Cline、OpenHands)频繁读取项目文件的 API 成本。
阅读全文

Anthropic 升级 Prompt Caching 自动延期算法:长会话多轮 Agent 交互计算开销下降 40%

Anthropic 宣布对其 API 上的 Prompt Caching 生存时间(TTL)管理机制进行升级。当智能体与 Claude 保持高频交互时,底层缓存将自动滑动续期,无需重新写入未变更的项目文件。该项优化使长达数小时的复杂软件工程交互总体 Token 写入费用降低 40%,同时首字生成延迟压降至 300ms 以内。

核心要点速览

  • 连续交互中的活跃上下文缓存自动延期,避免每 5 分钟超时重新支付全额写入费用。
  • 大型项目长会话交互总成本平均降低 40%,显著改善复杂代码重构体验。
  • 首字生成延迟(TTFT)维持在 300ms 以内,支持高吞吐并发工具调用。
阅读全文
AD赞助内容