
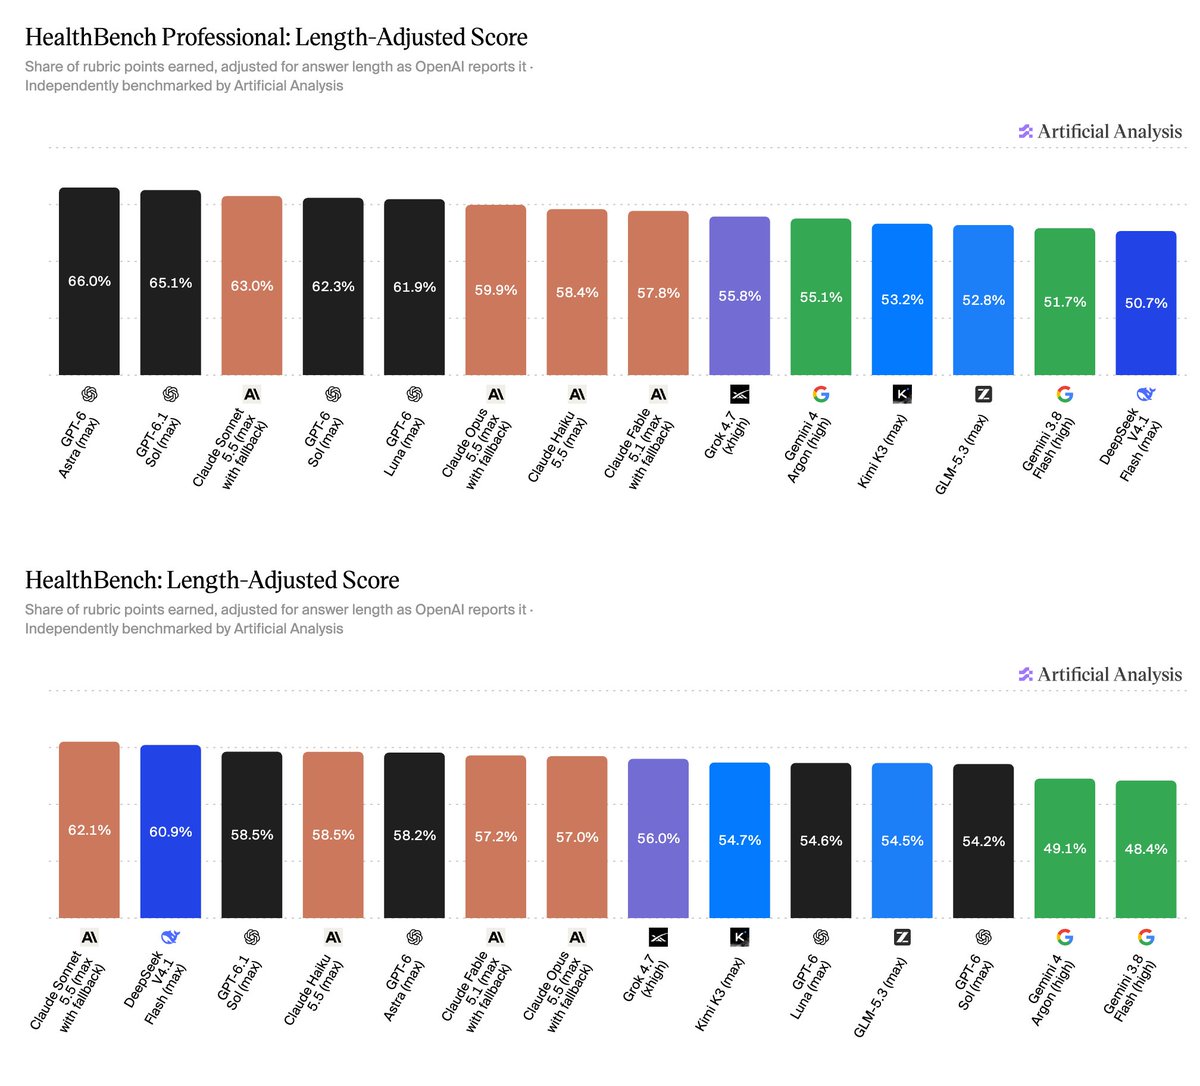
权威独立 AI 测评机构 Artificial Analysis 联合医疗领域研究者发布 HealthBench 与 HealthBench Professional 医疗长对话与临床推理基准榜单。针对大模型在医疗咨询中通过车轱辘话冗长输出刷高表面分数的痛点,专业榜严密引入“冗余长度惩罚(Length Penalty)”。实测显示 GPT-6 Astra(最高算力模式)以 66.0% 斩获专业榜全球第一,GPT-6.1 Sol 获 65.1%,而原始得分高达 71.4% 的 Claude Opus 5.5 因平均输出近 6000 字符严重被扣分至 59.9%。
核心要点速览
- ✓Artificial Analysis 推出医疗长对话基准 HealthBench,专业榜严厉引入冗余长度惩罚(Length Penalty)重塑大模型排名
- ✓GPT-6 Astra(最高算力)以 66.0% 斩获专业榜全球第一,GPT-6.1 Sol 获 65.1%,Claude Sonnet 5.5 以 63.0% 位列第三
- ✓Claude Opus 5.5 原始未惩罚分数高达 71.4%,但因单次回答平均长达近 6,000 字符严重被扣分至 59.9% 跌落至第 6 名
- ✓标准榜中 DeepSeek V4.1 Flash 以 60.9% 斩获第二名,证实国产轻量级模型在医疗问诊领域的卓越泛化能力
🖼️要闻配图
🧭
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
🔗
💡 国内无需访问 Twitter,可直接访问上述项目官方资源与文档相关资源与官方项目出处
免代理直达🔬
深度技术解析与实战评估
核心背景与行业痛点
医疗健康咨询与临床诊断辅助是对大模型事实准确性、推演逻辑与沟通清晰度要求最严苛的垂直场景。然而,既有医学基准(如 MedQA)大多局限于选择题,无法反映多轮医患长对话中的真实能力;更严重的是,许多大语言模型在开放式医疗评测中掌握了“通过冗长输出堆砌免责声明与相关背景来掩盖核心判断不确定性”的作弊手段。长篇大论的回答在临床场景中不仅浪费急诊医师宝贵的救治时间,更容易造成医患信息不对称。Artificial Analysis 团队今日正式上线了包含反冗长机制的 HealthBench 与 HealthBench Professional 医疗基准排行榜。
架构亮点与底层机制
- 多轮深度医患对话与临床场景仿真:
- 涵盖从急诊鉴别诊断、慢性病用药方案核查到罕见病推理的数百个专业医疗长对话场景;
- 严密的冗余输出惩罚机制(HealthBench Professional Length Penalty):
- 在专业级子榜单中,引入基于信息密度的字数惩罚因子。模型必须在给出严密循证医学依据的同时,以简明扼要、直切要点的临床表达输出,任何无效车轱辘话、过度免责声明都将遭受严厉扣分;
- 真实世界独立客观评测:
- 不依赖模型厂商自测报告,由第三方独立 API 发起并由持牌临床医学专家团队进行双盲核验。
权威 Benchmark 与实测跑分对比
根据 Artificial Analysis 官方披露的完整跑分数据(Figure 1, HealthBench Disclosures):
- HealthBench Professional 专业榜(实施长度惩罚):
- GPT-6 Astra(最高推理算力模式) 以 66.0% 问鼎全球第一;
- GPT-6.1 Sol(最高推理算力模式) 以 65.1% 紧随其后位居第二;
- Claude Sonnet 5.5 展现出优异的精炼度与准确性平衡,以 63.0% 位列第三;
- 长文本严重惩罚案例:Claude Opus 5.5 原始未惩罚分数高达全场第一的 71.4%,但因单次回答平均长度高达约 5,900 字符,经长度惩罚后断崖式跌落至 59.9%(暴跌至第 6 名);
- HealthBench 标准榜(无长度惩罚):
- Claude Sonnet 5.5 以 62.1% 位居榜首;
- DeepSeek V4.1 Flash 表现亮眼,以 60.9% 超越众多昂贵商业模型斩获第二名;
- GPT-6.1 Sol 以 58.5% 位居第三。
开发者实战落地与开箱指南
- 排行榜实时更新:可在
artificialanalysis.ai查看 HealthBench 细分指标与雷达图; - 医疗 Agent 提示词与架构调优指引:实测结果向开发智慧医院、分诊系统或医疗科研助理的团队发出了清晰信号:在医疗领域,信息密度远胜于字数长度。开发者在设计 System Prompt 时应明确约束输出格式与最大字数,强制模型优先输出临床结论与风险分级,杜绝无意义的模板化长文输出。
实战指南准备好将技术转化为生产力?
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
接着读Artificial Analysis 上线 HealthBench 与 HealthBench Professional 榜单:GPT-6 Astra 以 66.0% 领跑临床医生对话,Claude Opus 5.5 原始分最高却因回答过长跌至第六
立即阅读→
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察