

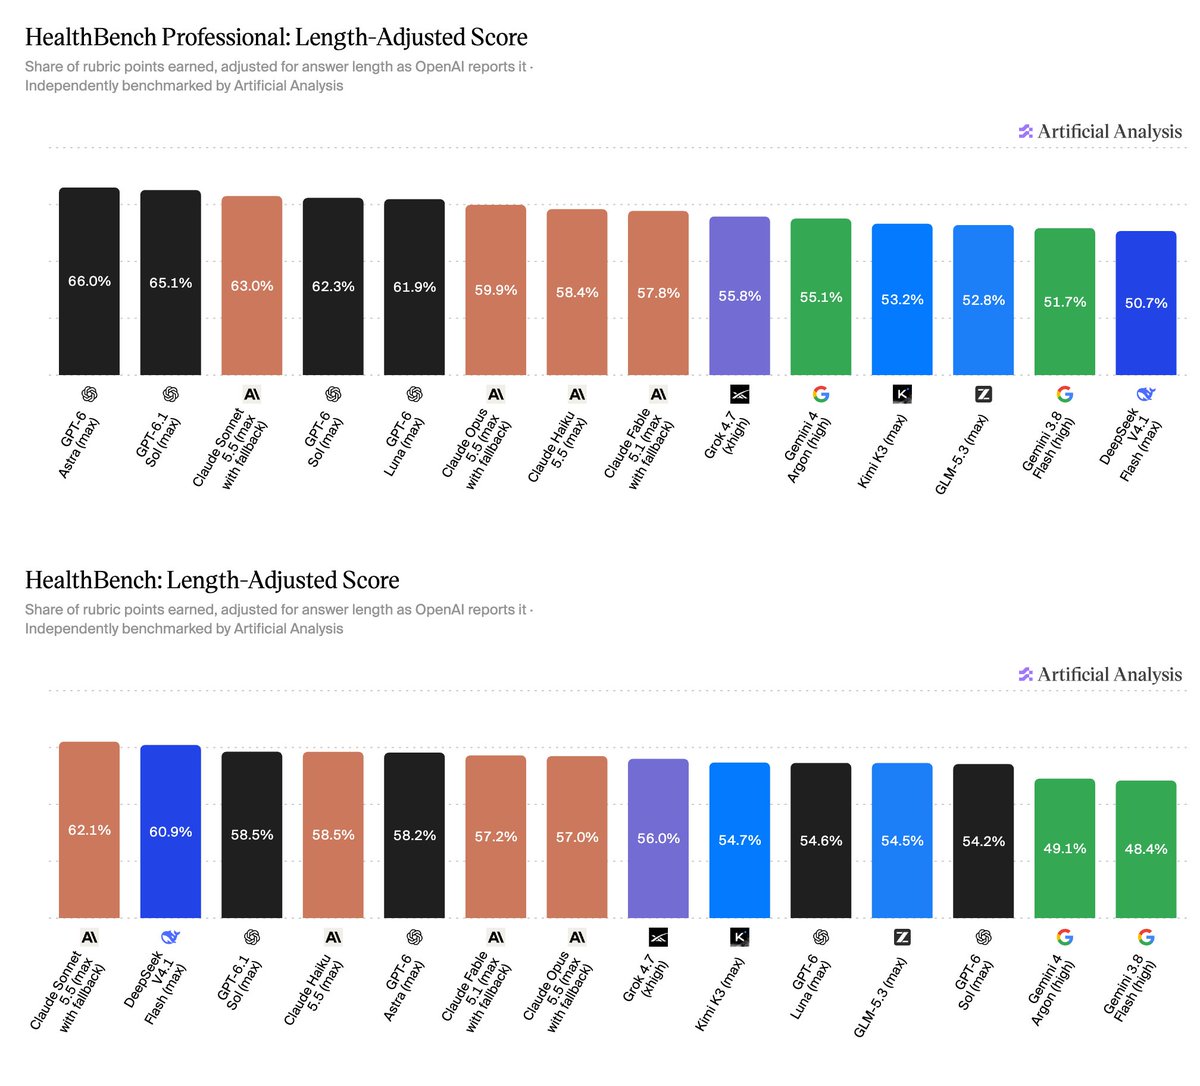
独立评测机构 Artificial Analysis 10 月 19 日上线两张医疗对话榜单,评测基于 OpenAI 的 HealthBench(5000 段真实健康对话)和 HealthBench Professional(525 段临床医生对话),由医生编写的评分细则打分,同时公布原始分和 OpenAI 采用的长度调整分。Professional 榜上 GPT-6 Astra(max)长度调整分 66.0% 第一,GPT-6.1 Sol 65.1%,Claude Sonnet 5.5 63.0%;Claude Opus 5.5 原始分最高(71.4%),但平均约 5900 字符的回答被扣分后跌到第六(59.9%)。HealthBench 榜上 Claude Sonnet 5.5 以 62.1% 第一,DeepSeek V4.1 Flash 60.9% 紧随其后,单任务成本约为前者的 1/16。
核心要点速览
- ✓HealthBench Professional(长度调整分):GPT-6 Astra(max)66.0%、GPT-6.1 Sol(max)65.1%、Claude Sonnet 5.5 63.0%。
- ✓Claude Opus 5.5 原始分 71.4% 全场最高,但平均回答约 5900 字符(阈值 2000 的近 3 倍),调整后掉到 59.9%、排第六;Claude Fable 5.1 同样被扣超过 11 分。
- ✓Professional 榜的分数-成本帕累托前沿全是 OpenAI 模型:GPT-6 Luna(max)61.9%、每任务 0.004 美元,不到 GPT-6 Astra(0.27 美元)成本的 2%。
- ✓HealthBench 榜:Claude Sonnet 5.5 62.1% 第一,DeepSeek V4.1 Flash 60.9%(每任务 0.005 美元),GPT-6.1 Sol 58.5%。
- ✓评分沿用 OpenAI 原实现:Professional 由 GPT-5.4(low)判分,HealthBench 由 GPT-4.1 判分。
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
大模型越来越多地被用来回答健康问题,但通用跑分测不出「答得对、答得全、说得清」这类临床场景要求。OpenAI 此前发布的 HealthBench 用医生编写的评分细则逐条给回答打分,Artificial Analysis 这次把它和更难的 HealthBench Professional 做成持续更新的公开榜单,方便横向比较各家最新模型。
架构亮点与底层机制
HealthBench 含 5000 段普通用户和医护人员的对话,覆盖急诊转诊、全球健康等 7 个主题,每条细则归入准确性、完整性、沟通质量、语境感知、指令遵循 5 个维度之一。HealthBench Professional 只有 525 段,全部是与临床医生的对话,涵盖问诊、写作和科研任务,并包含对抗性难题。榜单同时给出原始分和 OpenAI 采用的长度调整分:超过 2000 字符的回答被降分,更短的回答被加分。判分模型沿用 OpenAI 原实现,Professional 用 GPT-5.4(low),HealthBench 用 GPT-4.1。
权威 Benchmark 与实测跑分对比
以下均为 Artificial Analysis 公布的数据。Professional 长度调整分:GPT-6 Astra(max)66.0%、GPT-6.1 Sol 65.1%、Claude Sonnet 5.5 63.0%;Claude Opus 5.5 原始分 71.4% 最高,但调整后仅 59.9%,排第六。HealthBench:Claude Sonnet 5.5 62.1%、DeepSeek V4.1 Flash 60.9%、GPT-6.1 Sol 58.5%。成本上,GPT-6 Luna 在 Professional 拿到 61.9%,每任务仅 0.004 美元。
开发者实战落地与开箱指南
做医疗问答产品时,可在 Artificial Analysis 的 HealthBench 页面按分数和单任务成本筛选候选模型。要注意判分模型来自 OpenAI,且长度调整会明显影响排名:如果你的产品需要详尽回答,参考原始分;如果更看重简洁,参考调整分。评测代码可在 OpenAI 的 simple-evals 仓库找到,建议用自己的场景数据复测。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察