
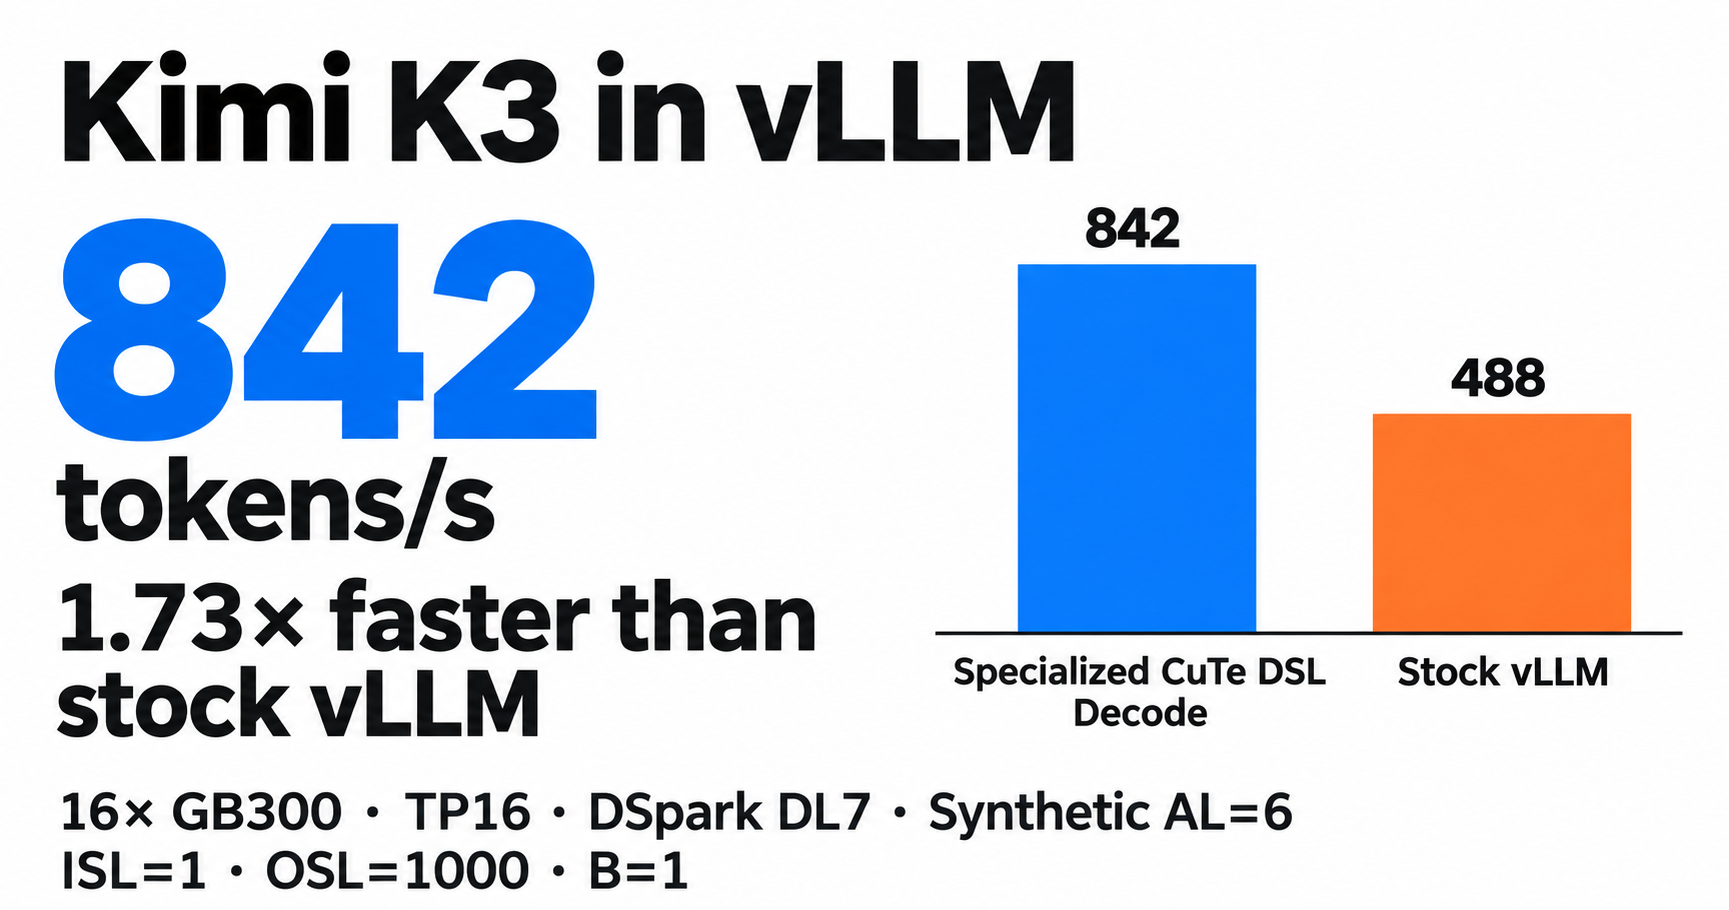
vLLM 官方博客(作者 NVIDIA 的 Benjamin Chislett)披露:借助编码 Agent 辅助开发,团队为 Kimi K3 在 NVIDIA GB300 上重写了一条 CuTe DSL 统一解码路径,把注意力、MoE 与 NVLink 通信融合,单层耗时从 130 微秒/23 个 kernel 降到 69 微秒/13 个。16 卡配合 DSpark 投机解码在 batch 1 达到 842 tok/s,是原版 vLLM 的 1.73 倍;相关 PR #61867 已于 10 月 16 日合入。
核心要点速览
- ✓16 卡 GB300 + DSpark(7 个草稿 token、合成接受长度 6)batch 1 解码 842 tok/s,原版 vLLM 为 488,提速 1.73 倍(官方口径)
- ✓无投机解码时 TP16 提速 1.62–1.92 倍(batch 64 达 3,606 tok/s),TP8 提速 1.31–1.58 倍
- ✓单层 kernel 从 23 个减到 13 个,耗时 130 微秒降至 69 微秒
- ✓AgentX 编码 Agent 负载下 P90 交互速度 403.2 对 223.7 tok/s/用户(1.8 倍),但对比基线为此前 8 卡结果
- ✓同一套「快速通道」方法已扩展到 DeepSeek-V4.1-Flash(PR #61868 待合入),Muse Spark Open 早期结果超 950 tok/s/用户
开发者 3 秒速决决策指标
本地显存不够?先比较云端 API 与自部署的实际成本
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
Kimi K3 这类超大 MoE 模型在低并发下的解码速度,直接决定编码 Agent 的「手感」。小 batch 推理主要受显存带宽和 kernel 启动开销拖累,原版 vLLM 跑 K3 每层要启动 23 个 kernel。另一个痛点是:Agent 写出的优化代码越来越多,维护者逐行审查跟不上,贸然合入又怕线上出错。
架构亮点与底层机制
团队用编码 Agent 辅助,为 Blackwell(8 或 16 卡、同一 NVLink 域、batch 1–64)写了一条 CuTe DSL 统一解码路径:按 batch 大小选择小矩阵或 split-K kernel;注意力输出投影直接与 all-reduce 和残差计算融合;MoE 路由打分拆到各 TP 卡后经 NVLink 交换;共享专家走独立 stream;通信间隙预取下一步权重。长上下文可开启解码上下文并行。治理上遵循「快速通道」RFC(#59665):改动只放在模型代码内、限定支持范围、系统化验证正确性与性能。
权威 Benchmark 与实测跑分对比
以下均为 vLLM/NVIDIA 官方口径:16 卡配合 DSpark(7 个草稿 token、合成接受长度 6)batch 1 达 842 tok/s,原版为 488,提速 1.73 倍;注意这是受控合成场景,真实接受率会更低。不开投机解码时,TP16 在 batch 1 为 256.4 tok/s(1.88 倍)、batch 64 为 3,606 tok/s(1.62 倍);TP8 提速 1.31–1.58 倍。AgentX 负载 P90 交互速度 403.2 对 223.7 tok/s/用户,但基线是此前 8 卡结果,并非同卡数对比。
开发者实战落地与开箱指南
PR #61867 已于 10 月 16 日合入 vLLM 主干,适用于 GB300/Blackwell 多卡部署;从同系列 DeepSeek PR 的描述看,它通过 decode_backend: latency_specialized 开关选择启用,具体参数以 PR 说明为准。DeepSeek-V4.1-Flash 版(#61868)仍在评审,GLM-5.3 版本官方称后续公布。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察