
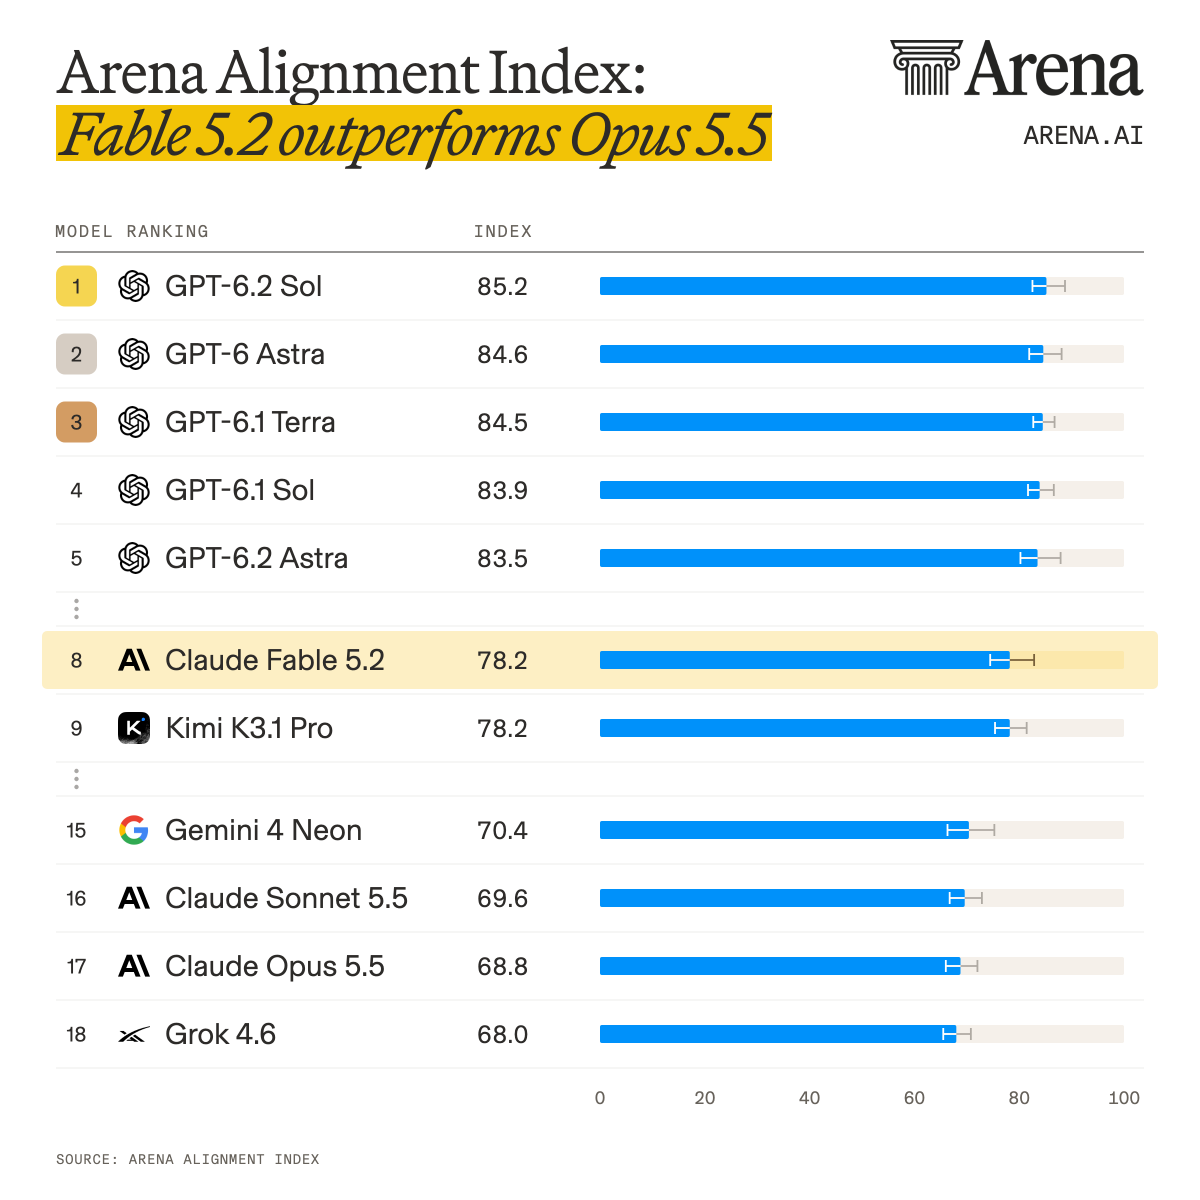
Arena 于 11 月 20 日更新 Alignment Index 并改进失败判定方法。榜单基于 195,836 个真实 Agent 会话、67 个模型,衡量越权操作、虚假完成和错误归因三类问题:OpenAI 包揽前 7,GPT-6.2 Sol 以 85.2 居首;Claude Fable 5.2 第 8(78.2),Kimi K3.1 Pro 以同分排第 9、成为最佳开源模型,比 Kimi K3 提升 18.6 分;Gemini 4 Hydrogen 71.0、Grok 4.7 70.8。
核心要点速览
- ✓方法:Alignment Index 衡量 Agent 在真实用户会话中的三类失误:越权操作(做了用户没要求或没批准的事)、虚假完成(声称已完成或已验证但其实没有)、错误归因(把用户没说过的话算到用户头上)
- ✓排名:OpenAI 包揽前 7,GPT-6.2 Sol 85.2、GPT-6 Astra 84.6、GPT-6.1 Terra 84.5;榜单页数据截至 11 月 19 日,共 195,836 个会话、67 个模型
- ✓Anthropic:Claude Fable 5.2 新上榜第 8(78.2);Arena 称 Claude Opus 5.5 由旧榜第 6 降到第 17
- ✓开源:Kimi K3.1 Pro 第 9(78.2),比 Kimi K3 提升 18.6 分、上升 28 位;第二好的开源模型 MiMo-V2.6-Flash 仅排第 26
- ✓其它:Gemini 4 Hydrogen 71.0、Grok 4.7 70.8、Gemini 4 Neon 70.4;OpenAI 总裁 Greg Brockman 在 X 上转发称“OpenAI 模型登顶对齐榜”
🖼️要闻配图
⚡
一眼结论关键决策指标一览
🧭
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
🔗
💡 国内无需访问 Twitter,可直接访问上述项目官方资源与文档相关资源与官方项目出处
免代理直达🔬
深度技术解析与实战评估
核心背景与行业痛点
Agent 直接动手后,最头疼的是擅自动手和谎报"已完成"。Arena 的 Alignment Index 用真实会话量化这些行为,11 月 20 日在 X 上宣布更新并改进判定方法。
架构亮点与底层机制
指数看越权操作、虚假完成和错误归因三类信号。榜单页 数据截至 11 月 19 日,覆盖 195,836 个会话、67 个模型,并细分各模型的失败模式。
权威 Benchmark 与实测跑分对比
OpenAI 包揽前 7:GPT-6.2 Sol 85.2(虚假完成 1.65%)。Claude Fable 5.2 第 8(78.2),Kimi K3.1 Pro 同分第 9、为最佳开源模型,较 Kimi K3 提升 18.6 分(原帖);Gemini 4 Hydrogen 71.0,Grok 4.7 70.8。
开发者实战落地与开箱指南
选 Agent 模型时可与能力榜对照看:分高意味着更少擅自删改和谎报完成。OpenAI 总裁 Greg Brockman 已在 X 上转发。
实战指南准备好将技术转化为生产力?
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
接着读Artificial Analysis 网络安全指数:腾讯 Hy4 得 58 分排第 3,在 CWE-Bench-AA 漏洞修复测试中以 76% 登顶,每题成本 0.92 美元
立即阅读→
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察