
清华大学与 Z.AI(智谱)等机构的论文 HarnessPro(arXiv 2610.26770,10 月 19 日提交、10 月 20 日更新 v2)提出一种无需标准答案的 harness 自我改进方法:让专门的 agent 诊断执行轨迹、改写指令与运行时策略,再用 LLM 生成的测试评估,并按性能与成本给出 Lite、Medium、Heavy 三档 harness。论文口径:GPT-5.5 搭配 Codex 时,Heavy 档在 Terminal-Bench 2 达到 80.8%,比此前方法 RHO 高 4.5 个百分点,单任务成本从 1.09 美元降到 0.72 美元。代码以 MIT 协议开源,本周被 Pandaily 等媒体集中报道。
核心要点速览
- ✓Terminal-Bench 2(GPT-5.5 × Codex,三次平均):Heavy 档 80.8%、单任务 0.72 美元;RHO 为 76.3%、1.09 美元,成本降 33.9%(论文口径,见 arXiv)
- ✓三个基准平均:相对 RHO 通过率 +2.0 个百分点、单任务成本 -26.1%;基准为 Terminal-Bench 2、SWE-Bench Pro、ProgramBench
- ✓换模型也成立:GLM-5.2 × Claude Code 在 Terminal-Bench 2 上,Heavy 档 81.4%、0.62 美元,对比原版 74.6%、0.92 美元和 RHO 78.0%、1.00 美元
- ✓省钱档:Medium 档在 Terminal-Bench 2 上 76.3%(与 RHO 持平)但只要 0.56 美元;Lite 档 72.9%、0.43 美元
- ✓训练代价小:每个基准只用 10 个训练任务、跑 3–4 轮进化,测试集为 59/100/100 个留出任务;GitHub 以 MIT 协议开源三档 harness
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
Coding agent 的效果不只取决于模型,还取决于 harness,也就是包在模型外面的指令、工具和运行时策略。近来流行的做法是让 agent 根据自己的执行轨迹反复改 harness(递归自我改进),但论文指出这类方法往往用更高的成本换来更高的通过率:GPT-5.5 × Codex 在 SWE-Bench Pro 上,RHO 把单任务成本从 1.88 美元推到 2.68 美元,涨了 42.6%。对按 token 付费的团队来说,这正是痛点。HarnessPro 由清华大学与 Z.AI(智谱)等机构的研究者完成,目标是同时提分和降本。
架构亮点与底层机制
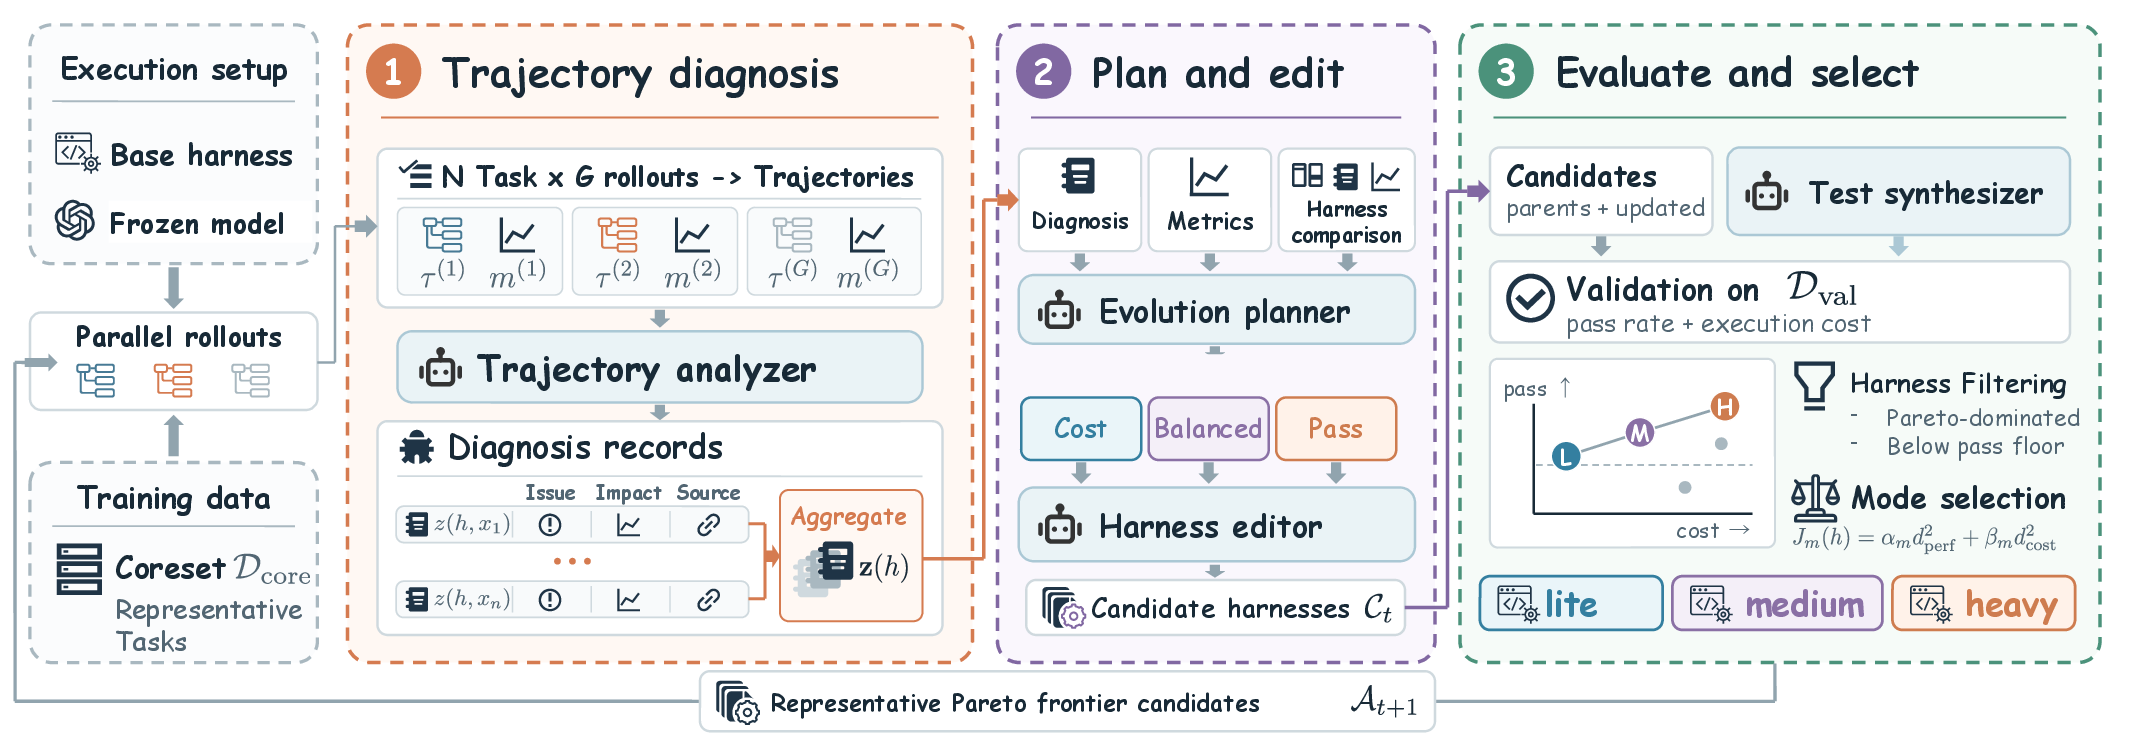
流程分三步:先由专门的 agent 诊断执行轨迹,找出失败模式、重复的工具调用和多余计算;再按不同的性能与成本优先级制定改动计划,生成候选 harness,改动范围包括指令、执行配置、工具使用策略和校验脚本;最后用 LLM 合成的测试打分,不需要标准答案或官方测试,并用归一化加权平方距离选出 Lite(省钱)、Medium(平衡)、Heavy(重性能)三档,进入下一轮迭代。
权威 Benchmark 与实测跑分对比
以下均为论文作者口径,尚无第三方复现。GPT-5.5 × Codex 在 Terminal-Bench 2 上:Heavy 80.8%、0.72 美元,RHO 76.3%、1.09 美元;Medium 76.3%、0.56 美元;Lite 72.9%、0.43 美元。三个基准平均,Heavy 相对 RHO 通过率高 2.0 个百分点、成本低 26.1%。换成 GLM-5.2 × Claude Code,Heavy 在 Terminal-Bench 2 达 81.4%、0.62 美元(原版 74.6%、0.92 美元)。每个基准只用 10 个训练任务,测试集分别为 59、100、100 个留出任务。
开发者实战落地与开箱指南
仓库 pzs19/HarnessPro 以 MIT 协议开源,附带三个基准各三档的 harness 成品。环境要求 Linux、Python 3.12 或 3.13、uv、Docker Compose 和 Codex CLI(论文用 0.147.0),克隆后运行 uv sync 和 prepare_runtime 脚本即可,基准数据和模型密钥需自行配置。实际用法上,可以先拿 Medium 档替换现有 Codex harness,看能否在通过率不降的前提下把账单压下来;成本敏感的批量任务再试 Lite。注意这些 harness 是针对具体基准进化出来的,迁移到自家仓库前要用自己的任务重新验证。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察