

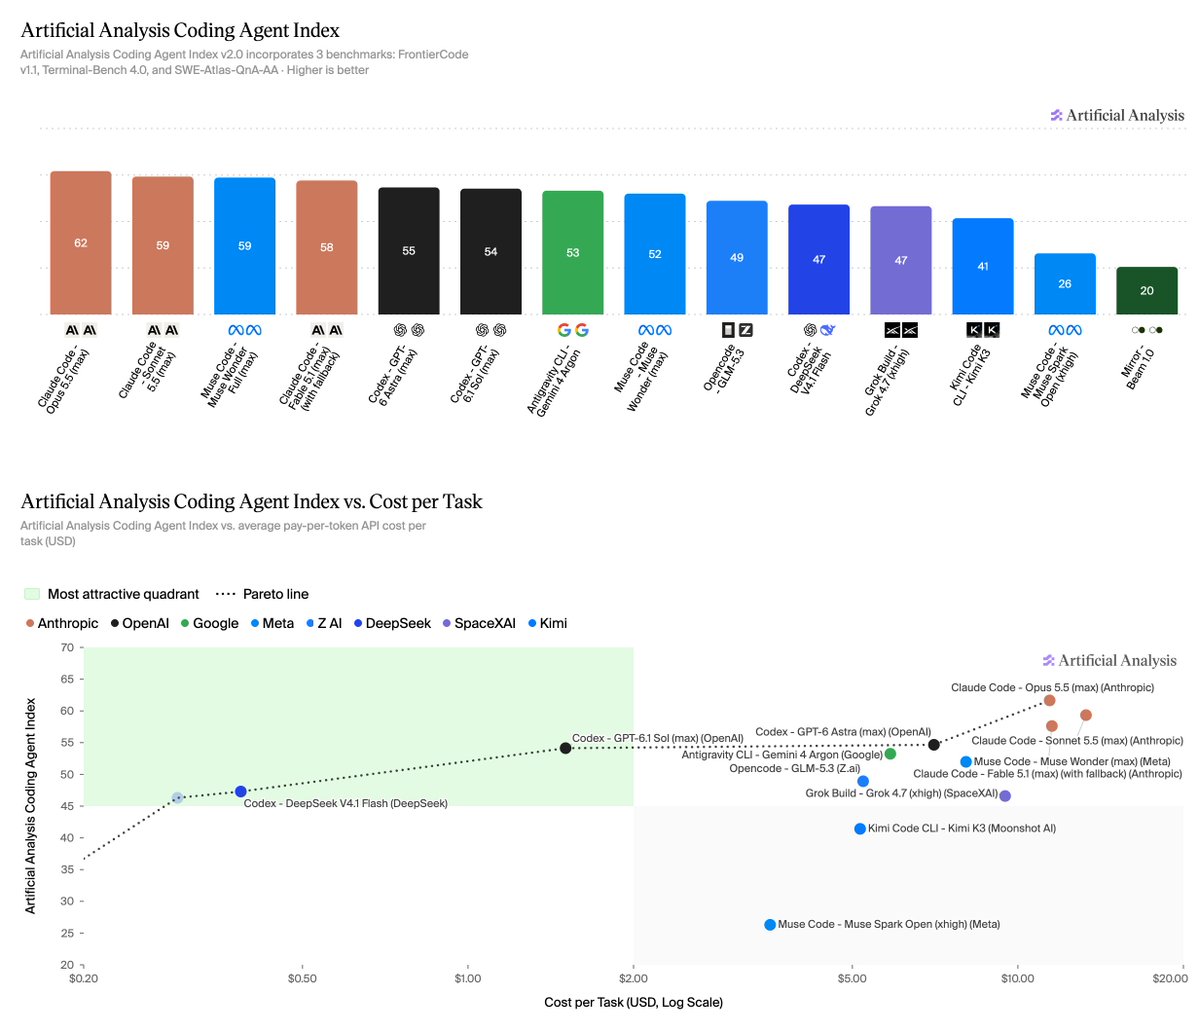
Artificial Analysis 于 2026-10-23 发布 Coding Agent Index v2.0,评测对象是「模型 + Agent 外壳」的组合,覆盖 290 道任务,三项基准等权:Cognition 的 FrontierCode v1.1(100 道真实开源仓库任务,按维护者是否会合并打分)取代 DeepSWE v1.1,SWE-Atlas-QnA 改为评分更严格的 SWE-Atlas-QnA-AA,Terminal-Bench 4.0 不变。Claude Code + Claude Opus 5.5(max)以 61.7 分居首,Sonnet 5.5 59.3、Muse Wonder Full 58.9 紧随。新版整体分数下降:21 个两版都测过的配置平均分从 54.8 降到 47.4。
核心要点速览
- ✓榜首:Claude Code + Claude Opus 5.5(max)61.7,Claude Sonnet 5.5(max)59.3,Muse Code + Muse Wonder Full(max)58.9,Claude Fable 5.1(max with fallback)57.6(Artificial Analysis 口径)
- ✓FrontierCode v1.1 上 Opus 5.5 拿到 56.0%,领先 Codex + DeepSeek V4.1 Flash 的 52.6%;24 个配置中有 15 个挤在 43%–49%
- ✓新旧版对比:21 个配置平均分 54.8 → 47.4,其中 20 个下降;同一批配置 FrontierCode 平均 45.1%,DeepSWE 为 65.6%
- ✓成本前沿四个点:DeepSeek V4.1 Flash 47.3 分 $0.39/任务、GPT-6.1 Sol 54.1 分 $1.50、GPT-6 Astra 54.7 分 $7.04、Opus 5.5 61.7 分 $11.42(按 API 按量计费,不是订阅价)
- ✓SWE-Atlas-QnA-AA 改写了 1,306 条评分细则中的 127 条,裁判换成 GPT-6 Luna(xhigh)每条 5 票,数据集和裁判配置已在 Hugging Face 公开
开发者 3 秒速决决策指标
Claude Code 高频使用:比较订阅额度与 API 账单
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
Coding Agent 的能力不只取决于模型,还取决于它跑在哪个外壳里(Claude Code、Codex、Muse Code 等)。Artificial Analysis 的 Coding Agent Index 就是按「模型 + 外壳」一行一行打分。旧版 v1.5 里的 DeepSWE v1.1 已经被头部配置刷到 65% 以上,区分度下降;v2.0 的目标是换一个更难、更贴近真实合并标准的软件工程基准。
架构亮点与底层机制
v2.0 由三项等权组成,共 290 道任务:FrontierCode v1.1(Cognition 出品,100 道任务,测试集不公开)、Terminal-Bench 4.0(66 道终端任务,不变)、SWE-Atlas-QnA-AA(Scale AI 的 124 道仓库问答)。FrontierCode 按「维护者会不会合并」打分:任一阻断项失败记 0 分,全部通过则按非阻断项得 70%–100%。Agent 可以联网,但轨迹扫描发现它去抓上游 PR、合并提交或镜像答案就直接记 0。SWE-Atlas-QnA-AA 改写了 127 条评分细则,裁判换成 GPT-6 Luna(xhigh),每条细则投 5 票。每道题跑 3 次取平均。
权威 Benchmark 与实测跑分对比
以下均为 Artificial Analysis 官方口径。总榜:Claude Code + Opus 5.5(max)61.7、Sonnet 5.5(max)59.3、Muse Wonder Full(max)58.9、Fable 5.1 57.6。FrontierCode 单项:Opus 5.5 56.0%,Codex + DeepSeek V4.1 Flash 52.6%,GPT-6.1 Sol 49.4%,GPT-6 Astra 49.3%。整体变难:21 个配置平均分从 54.8 降到 47.4,20 个下降。成本前沿上,DeepSeek V4.1 Flash 以每任务 $0.39 拿到 47.3 分,Opus 5.5 则是 $11.42 拿 61.7 分。
开发者实战落地与开箱指南
选 Agent 时别只看总分:预算紧、任务量大可以先试 Codex + DeepSeek V4.1 Flash 或 GPT-6.1 Sol;追求合并质量再上 Opus 5.5。注意 v2.0 与 v1.5 的分数不可直接比较,看历史文章里的旧分数要先确认版本。各配置的单项分、每任务成本和 token 用量可以在 Artificial Analysis 的 Coding Agents 页面查,SWE-Atlas-QnA-AA 数据集可以在 Hugging Face 下载自测。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察