
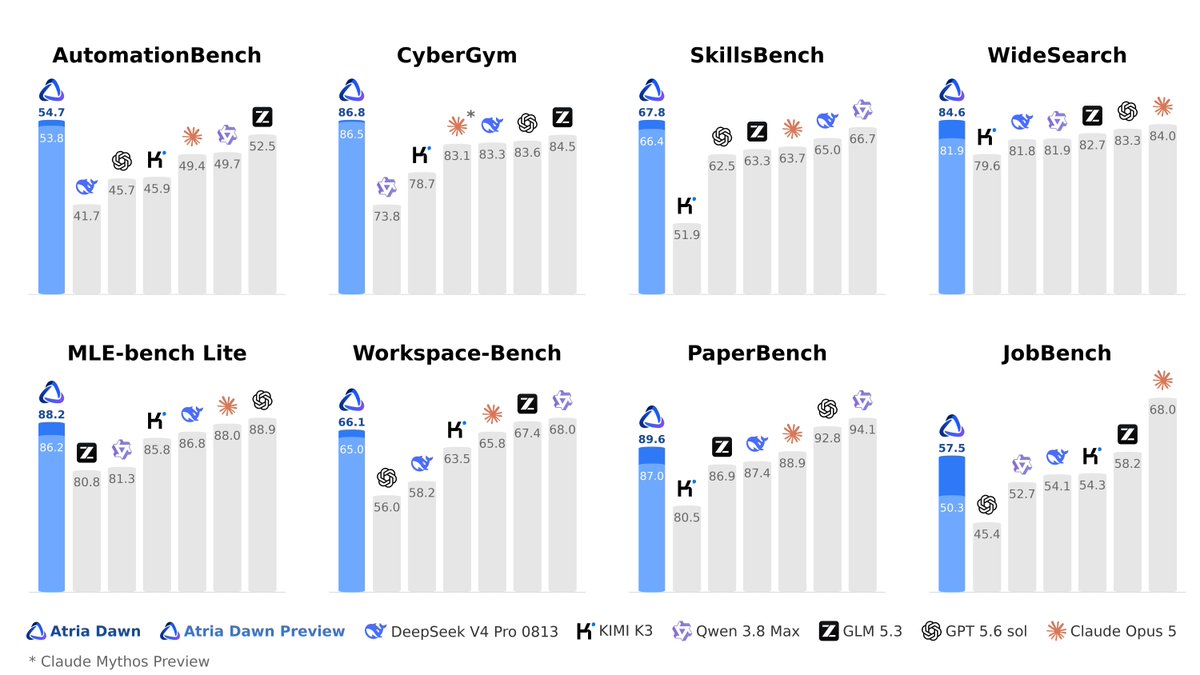
上海人工智能实验室把 Atria Dawn 从 Preview 升级为正式版,Hugging Face(internlm/Atria-Dawn 及 FP8 版)与 ModelScope 均已上线开放权重,MIT 许可。模型基于 744B 参数 MoE 的 GLM-5.2,面向科研与工程类长程智能体任务,上下文从 Preview 的 256K 翻倍到 512K,仅接受文本输入。官方表格显示其在 AutomationBench、CyberGym、SkillsBench 等智能体基准上领先所列模型,但在 SWE-bench Pro、Terminal-Bench 2.1 等编码基准上仍落后 Claude Opus 5(均为厂商口径)。
核心要点速览
- ✓上下文 512K,是 Preview 版 256K 的两倍;基座为 744B 参数 MoE 的 GLM-5.2,仅支持文本输入
- ✓Hugging Face 与 ModelScope 提供 BF16 与 FP8 权重,MIT 许可
- ✓厂商口径:AutomationBench 54.7、CyberGym 86.8、SkillsBench 67.8、BFCL V4 78.4,均为表内最高
- ✓短板同样来自官方表:SWE-bench Pro 61.7 对 Claude Opus 5 的 76.5,Terminal-Bench 2.1 81.0 对 90.2
- ✓本地部署需 SGLang v0.5.13.post1+ 或 vLLM v0.23.0+;也提供 OpenAI 兼容 API,可直接接入 Codex
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
上海人工智能实验室 9 月开源 Atria Dawn Preview,主打长程科研与工程智能体。开放权重的智能体模型常受限于上下文长度和多步工具调用稳定性。正式版已上线 Hugging Face(internlm/Atria-Dawn)与 ModelScope,ModelScope 官方 10 月 27 日在 X 公告,MIT 许可。
架构亮点与底层机制
据官方模型卡,基座为 744B 参数 MoE 的 GLM-5.2,覆盖深度研究、软件构建、文档交付和授权安全分析,强调规划、调用工具、写代码、跑实验到失败恢复的闭环。上下文由 256K 升至 512K,仅支持文本输入,另有 FP8 版;技术报告见 arXiv 2609.15818。
权威 Benchmark 与实测跑分对比
均为厂商口径:AutomationBench 54.7、CyberGym 86.8、SkillsBench 67.8、BFCL V4 78.4 为表内最高。编码偏弱:SWE-bench Pro 61.7(Claude Opus 5 为 76.5),Terminal-Bench 2.1 81.0(Opus 5 为 90.2)。第三方评测暂未公布。
开发者实战落地与开箱指南
本地部署需 SGLang v0.5.13.post1+ 或 vLLM v0.23.0+,按 GLM-5.2 配方启动,需多卡服务器,FP8 可省显存。也可用官方 OpenAI 兼容 API(model 填 Atria-Dawn),模型卡给出了 Codex 的接入配置。更适合研究自动化与办公类智能体,纯编码仍是闭源前沿模型更强。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察