

机器人基础模型公司 Skild AI 11 月 9 日宣布开源内部物理求解器 Steel(Apache 2.0),由其与 NVIDIA 合作开发,作为 GPU 刚体动力学求解器并入开源 Newton 物理引擎,服务 Isaac Lab 机器人训练。官方博客称:20 个单任务基准上几何平均吞吐为 PhysX 的 3.8 倍、MuJoCo Warp 的约 1.3 倍;把 20 类不同机器人任务混在一个批次时,峰值吞吐达 PhysX 的 13 倍,同批次规模下显存约 11 GiB 对 29 GiB。同时开源 WebGPU 版本,可在浏览器里直接体验。
核心要点速览
- ✓官方口径:20 类任务混合批次下 Steel 达 390 万环境步/秒(245,760 个环境),PhysX 峰值为 30 万,约 13 倍
- ✓同为 61,440 个环境时 Steel 为 361 万步/秒,是 PhysX 的 12 倍,显存约 11 GiB 对 29 GiB(少约 62%)
- ✓20 个单任务基准中 19 个快于 PhysX,几何平均 3.8 倍;约为 MuJoCo Warp 的 1.3 倍;23 关节 Kuka–Allegro 抓取任务达 PhysX 的 6.7 倍
- ✓Apache 2.0 开源,在 Newton 中以 newton.solvers.SolverSteel 调用;另开源 WebGPU 版本,浏览器内可交互 24 个场景
- ✓注意:所有数字仅为物理仿真吞吐,不是端到端策略训练速度,均在单张 RTX PRO 6000 Blackwell 上测得
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
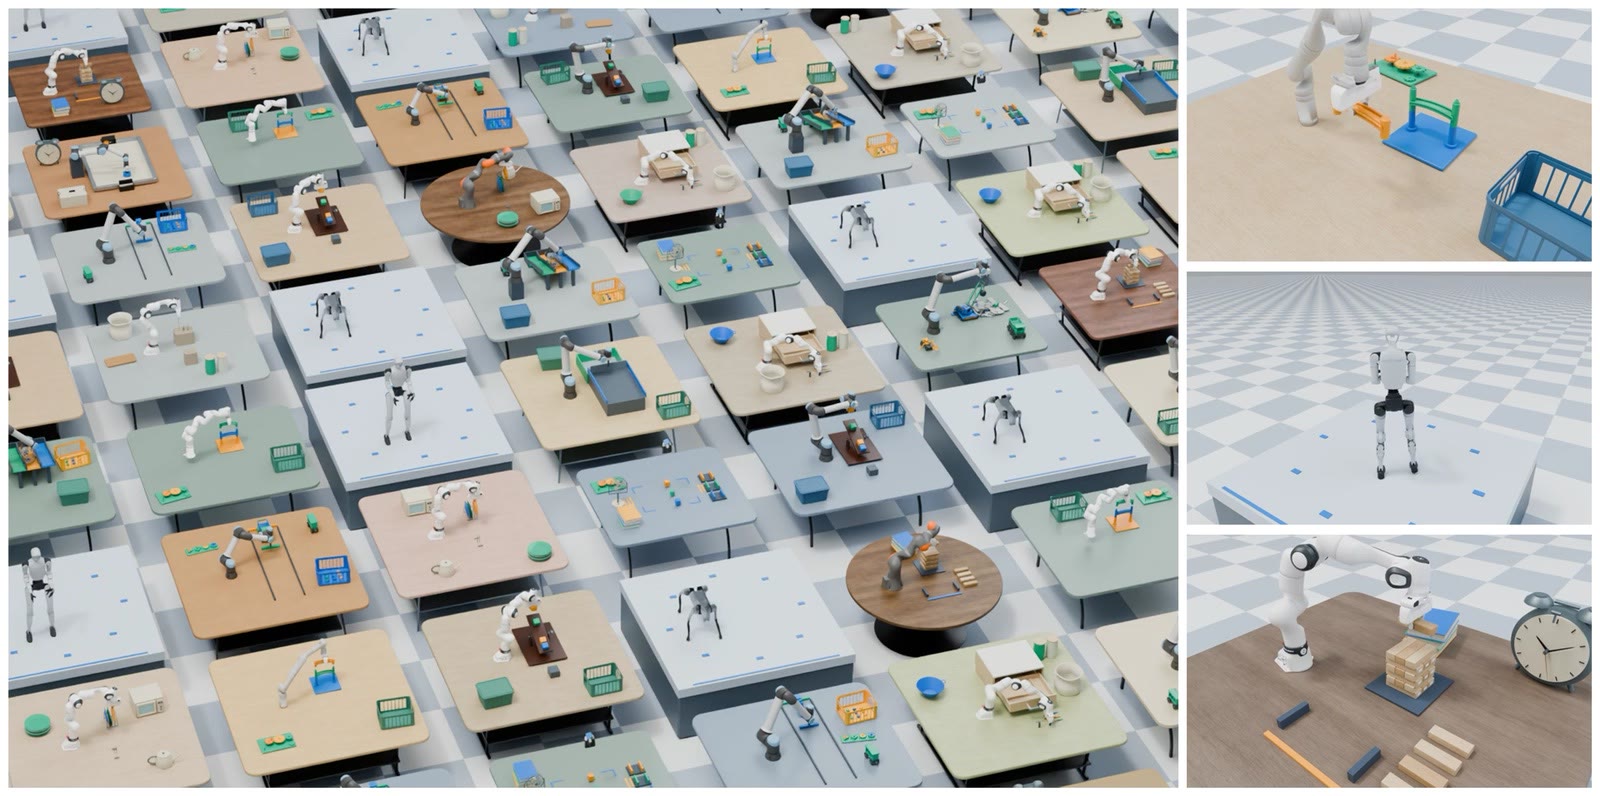
GPU 并行仿真让四足和人形机器人的运动控制训练突飞猛进,因为可以把同一个机器人、同一个任务复制成千上万份。但操作类任务(抓取、装配、用工具)完全不同:需要海量多样、接触密集的场景,不同机器人的关节数和接触数差别很大。很多现有引擎在"同构批次"里最高效,遇到异构批次就会因填充和密集矩阵浪费算力与显存。
架构亮点与底层机制
Steel 是 Newton 物理引擎里的刚体求解器。它按环境组织动力学和约束,把关节数相近的机械结构分组执行,并按每个环境当前的接触量分配求解工作;底层采用约化坐标关节动力学加投影 Gauss-Seidel 约束求解。可与 Newton 的布料、线缆、沙土求解器耦合。
权威 Benchmark 与实测跑分对比
以下均为官方/厂商口径,单张 RTX PRO 6000 Blackwell、仅计物理步进:混合 5/10/15/20 类任务时,峰值吞吐为 PhysX 的 9.2 至 13.0 倍;20 类混合下 Steel 390 万步/秒,PhysX 30 万步/秒。同为 61,440 个环境时为 12 倍,显存约 11 GiB 对 29 GiB。20 个单任务基准几何平均为 PhysX 的 3.8 倍(MuJoCo Warp 为 2.9 倍),19 个任务领先。对比基于 Isaac Sim 6.1;官方也注明 PhysX 在 6.0 版上跑这些混合任务最多快约 2.7 倍。暂无第三方复现。
开发者实战落地与开箱指南
代码在 GitHub skild-ai/steel(Apache 2.0),也已进入 Newton,以 newton.solvers.SolverSteel 调用,面向 Isaac Lab 训练流程。官方提醒单任务测试启用了 reuse_kinematics=True,这在 Newton 1.8 中需手动开启。博客内的 WebGPU 演示可在浏览器里直接拖动物体试玩。做操作类强化学习、需要在一个批次里混跑多种机器人的团队最值得试。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察