

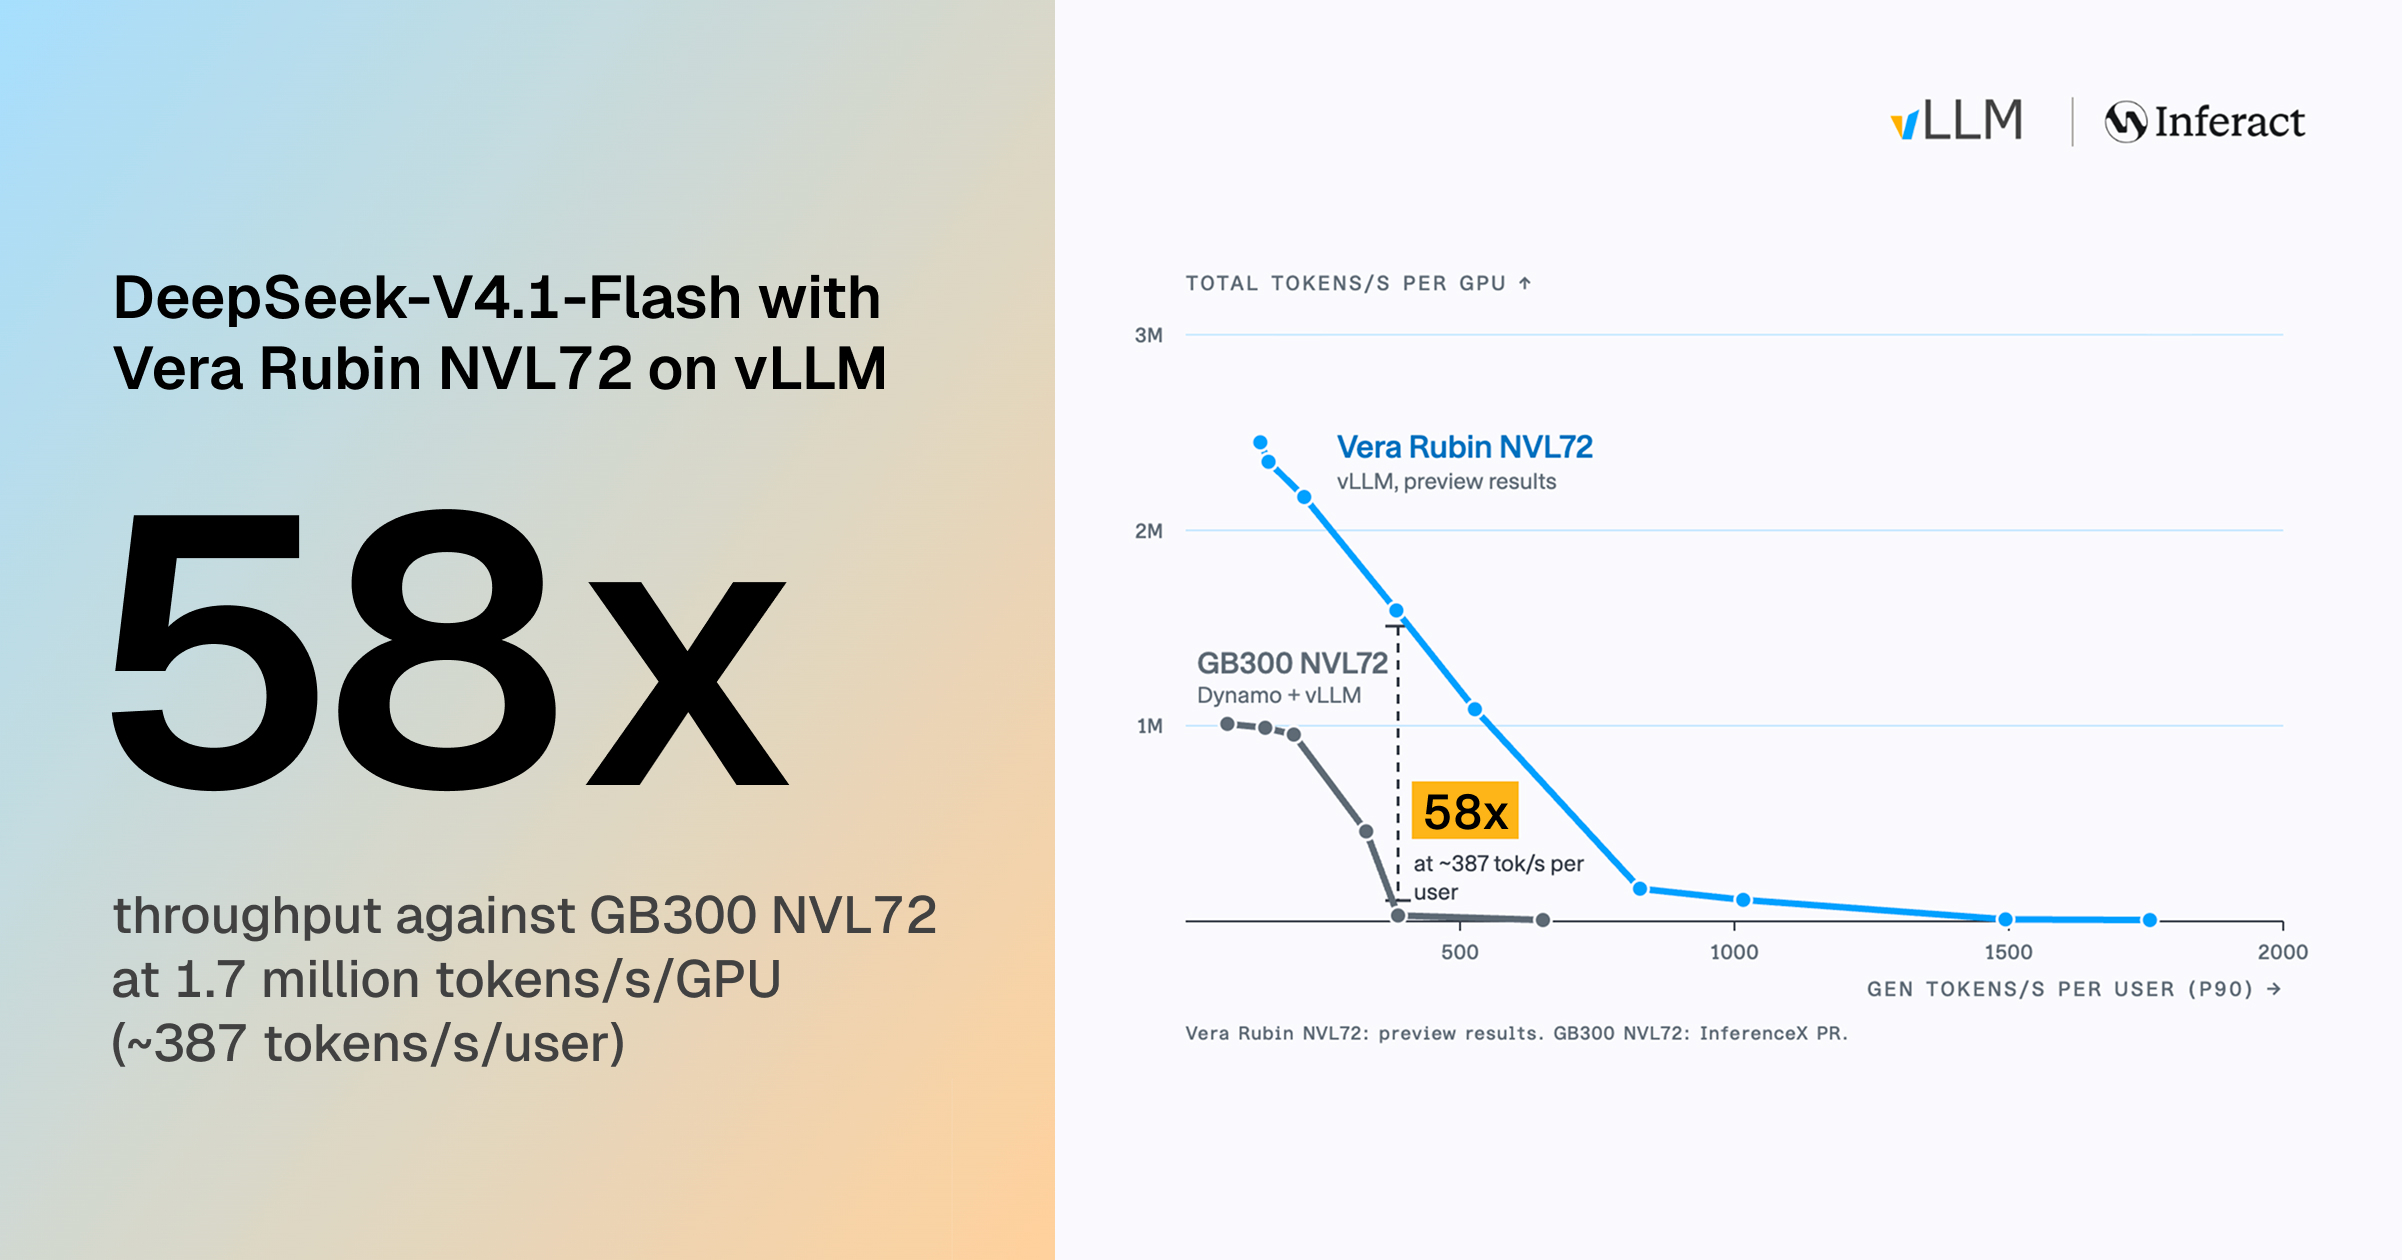
11 月 12 日,vLLM 发布 DeepSeek-V4.1-Flash 系列第三篇博客(Inferact 主导):在一台 Vera Rubin NVL72 上,用 SemiAnalysis AgentX 负载测得每用户 P90 387 token/s 时单 GPU 总吞吐 170 万 token/s,是 GB300 NVL72 同一交互速度下的 58 倍;峰值吞吐 252 万 token/s/GPU,是 GB300 的 2.7 倍。58 倍只对应高交互速度这一点,Rubin 数据为预览结果。
核心要点速览
- ✓两个倍数要分开看(vLLM 口径):每用户 387 token/s 时 170 万 token/s/GPU,是 GB300 的 58 倍;峰值吞吐 252 万 token/s/GPU,是 GB300 的 2.7 倍
- ✓单用户延迟:TP8 跨两个计算托盘的专用解码路径,并发 1 时 P90 达 1,810 token/s,P50 从 1,117 提升到 1,844 token/s
- ✓内核重写:针对 Rubin 的双内存域和 SM107 新 MMA 指令,DEP2 prefill 步约快 28%,DEP decode 步约快 25%
- ✓机架级内存池:Mooncake KV 池从 DRAM 扩到空闲 HBM,Engram 表分片到各 GPU HBM;并发 4,800 时请求量多 68%,TTFT P50 从 29.8 秒降到 4.2 秒
- ✓数据性质:Rubin 结果为预览数据,GB300 对比来自 InferenceX PR,部分点为插值
开发者 3 秒速决决策指标
本地显存不够?先比较云端 API 与自部署的实际成本
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
Agent 负载的特点是会话多、前缀长、要求每个用户都拿到高速输出。在这种「高交互」区间,上一代机架吞吐会急剧下降,这正是推理成本的痛点。vLLM 此前已在 GB300 NVL72 上做过 PD 分离和 Wide-EP,这次把同一套栈搬到英伟达新一代 Vera Rubin NVL72。
架构亮点与底层机制
Rubin 每块 GPU 有两个内存域,SM 读本域快得多,vLLM 因此把 MoE 权重、残差流按内存域切分。SM107 新增 K64 FP8×FP4 MMA,每条指令做双倍工作,MegaMoE 在每 rank 8K+ token 时吞吐提升 8–11%。72 块 GPU 共享一个 NVLink 域,TP8 可以跨两个托盘,几乎不增加 all-reduce 开销。Dynamo 按未缓存工作量路由请求,前缀命中率保持在 96.5–97%。
权威 Benchmark 与实测跑分对比
以下均为 vLLM 官方口径,负载是 SemiAnalysis AgentX:每用户 P90 387 token/s 时 170 万 token/s/GPU(GB300 的 58 倍),峰值 252 万 token/s/GPU(2.7 倍),单会话 1,810 token/s。58 倍反映的是 GB300 在高交互区间吞吐塌得厉害,不代表整体快 58 倍。Rubin 为预览结果,暂无第三方复测。
开发者实战落地与开箱指南
Vera Rubin 尚未大规模可得,普通团队短期用不上这套配置。但博客里的方法可以借鉴:按会话负载画「每用户速度—单卡吞吐」曲线选工作点,用共享 KV 池加负载感知路由替代会话亲和,并在 GB300/B300 上先用 vLLM 的 PD 分离与 Wide-EP 方案。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察