AI 编程实时动态与要闻

DeepSeek Harness 团队开源 dsh-superagent:常驻单个 GitHub 仓库的主动式编码 Agent 原型,同步公开 Super-agent 架构文章

10 月 31 日,deepseek-ai 在 GitHub 以 MIT 协议开源 dsh-superagent-prototype:一个作为 DeepSeek Harness 插件包运行、常驻单个 GitHub 仓库(可选接入飞书)的主动式编码 Agent。授权成员提出请求后,它会建工作项、在独立会话和目录里干活,再回到原对话交付,例如提一个 PR。README 明确写着这是研究原型,不是 DeepSeek 官方产品。同时发布的《Exploring Super-agent Design》提出 Router-Worker 双层架构,媒体转述的团队自测显示 p95 完成时间 15.7 分钟,对比单会话方案 29.5 分钟。

核心要点速览

  • 开源:deepseek-ai/dsh-superagent-prototype 于 10 月 31 日公开,MIT 协议、TypeScript 实现,写稿时约 1,800 star
  • 定位:每次部署只服务 1 个 GitHub 仓库,可选接入飞书;只在被授权成员点名或团队写好的规则允许时才动手
  • 交付:默认只允许为工单开的、增删合计少于 200 行且已获批准的 PR 自动合并,且不以 Agent 自己的账号开启自动合并
  • 团队自测(据媒体转述文章,厂商口径):约 300 条消息、20 个请求的模拟中,p50 / p95 完成时间 12.4 / 15.7 分钟,单会话加 Subagent 方案为 20.4 / 29.5 分钟
  • 风险:Worker 会话以运维者的系统用户身份免审批执行命令,README 要求用前先审阅和改造
阅读全文

CrowdStrike:中国关联组织 VAPOR PANDA 用 ARTEX 多智能体框架(主用 DeepSeek)11 天内攻击 200 多家机构

CrowdStrike 于 10 月 29 日发布报告:中国关联的间谍组织 VAPOR PANDA 自 10 月 17 日起,用开源 agent 入侵框架 ARTEX 搭配 DeepSeek 和另一款未能确认的商业大模型,在 11 天内从同一个控制端对至少 14 个国家的 200 多家机构发起攻击,确认 9 家被攻入并植入 BLOODALCHEMY 后门。单次入侵中规划 agent 就消耗约 14 亿输入 token;恢复的对话记录显示有人类操作员用中文在关键节点下指令。

核心要点速览

  • 10 月 17 日起 11 天,同一个 ARTEX 控制端攻击至少 14 个国家、200 多家机构,涉及多国外交部、美国 19 家制药/半导体/国防/核能/金融机构,以及美国、比利时、菲律宾的电信商(CrowdStrike 报告)
  • 确认 9 家机构被攻入并部署 BLOODALCHEMY 后门,另有至少 12 家遭密码喷洒和凭据扫描
  • 主用 DeepSeek,外加一款 CrowdStrike 未能确认的订阅制商业大模型;单次入侵中规划 agent 约消耗 14 亿输入 token
  • 恢复的记录里人类操作员用「【人类指令】」标签下中文指令,还要求 agent 找出「没有装猎鹰(Falcon)」的 Windows 主机
  • CrowdStrike 称这与微软此前报道的 Storm-0940 使用 ARTEX 是两起不同活动,并判断未来 12 个月中国关联组织「极可能」继续采用此类 agent 框架
阅读全文
关联模型 / 智能体 / 厂商:

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

Mixpanel 创始人 Suhail Doshi 10 月 28 日(SGT 10 月 29 日 01:36)在 X 上宣布新公司 Particle,首个模型 Particle-1 已上线。官方博客称它在 DeepSeek V4.1 Flash 上用强化学习后训练,在四个编码与数据工程基准上输出 token 少 28.4%–52.2%、单任务成本低 34.4%–51.6%,通过率仍在基座模型置信区间内。可通过 Particle API、OpenRouter 和 Vercel AI Gateway 调用,官方文档标价每百万 token 输入 0.25 美元、输出 1 美元,上下文 1,048,576 token。

Suhail 新公司 Particle 发布首个模型 Particle-1:基于 DeepSeek V4.1 Flash 后训练,编码任务平均少用约 45% token

核心要点速览

  • 四个基准(Terminal-Bench 2.1、ReactBench、ADE Bench、DeepSWE 1.1)上输出 token 少 28.4%–52.2%,单任务成本低 34.4%–51.6%(官方口径)
  • 官方汇总表:每任务成本 0.2211 美元,对比 DeepSeek V4.1 Flash 0.3368 美元、GLM 5.3 Flash 0.6523 美元;平均输出 59,580 token,对比 83,246 和 98,155
  • 任务通过率 72.57%,对比基座 71.15%、GLM 5.3 Flash 66.82%;GPQA Diamond 90.40%(基座 90.91%)、MMLU 86.08%(基座 85.98%)
  • 训练方式:在全部层的专家上训练 rank-64 LoRA,可训练参数约占模型 1.25%,用 GSPO 序列级策略优化分两阶段 RL
  • 定价:官方文档当前为每百万 token 输入 0.25 美元、缓存输入 0.03 美元、输出 1.00 美元,上下文 1,048,576 token,单次输出上限 131,072 token
阅读全文

Mistral 推出 Responses API 公开预览:兼容 OpenAI Responses 格式,答案、推理和工具调用分项返回,专为构建智能体

Mistral AI 10 月 28 日在 X 宣布 Responses API 进入公开预览,定位为在 Mistral 上构建智能体的接口。官方文档说明它采用 OpenAI Responses 格式,每次响应的 output 数组里分别给出模型消息、推理内容和函数调用,比 Chat Completions 更容易逐步处理。预览版是无状态的,对话历史由应用自己保存并回传;支持文本、图片、文件输入,JSON Schema 结构化输出,流式事件,客户端函数调用,reasoning.effort,以及 POST /v1/responses/input_tokens 计数。服务部署在 Mistral AI Cloud Inference 的欧盟和美国区域。同一帖串还宣布在其云上提供 DeepSeek V4.1 Flash(公开预览)和 GLM 5.3 Flash(正式可用)。

核心要点速览

  • Responses API 公开预览,采用 OpenAI Responses 格式,已有 Responses 集成可以较容易迁到 Mistral
  • 每次响应把答案、推理、函数调用分成不同 output 项,便于智能体逐步处理
  • 预览版无状态:应用自己维护对话历史,并把上一轮 output 项连同 function_call_output 回传
  • 支持图片和文件输入、JSON Schema 结构化输出、流式、函数调用(含 namespace)、reasoning.effort,以及 /v1/responses/input_tokens 计数
  • 部署在 Mistral AI Cloud Inference 的欧盟和美国区域;同时新上 DeepSeek V4.1 Flash(预览)和 GLM 5.3 Flash(GA)
阅读全文
AD赞助内容

Cursor 上线 DeepSeek V4.1 Flash:CursorBench 4.0 四档推理全部落在成本前沿,Max 档 47.7%、每任务 $0.98

Cursor 官方 10 月 27 日(SGT)宣布 DeepSeek V4.1 Flash 已在 Cursor 中可用,在 Cursor Settings > Models 打开即可。Cursor 称该模型每一档推理强度都落在 CursorBench 成本前沿上:每任务 $0.60 到 $0.98,在这个价位没有模型得分更高。官方 CursorBench 4.0 榜单显示,DeepSeek V4.1 Flash 1017 Max 档 47.7%($0.98/任务),Medium 46.3%($0.80),High 45.6%($0.77),Low 44.9%($0.60);同榜最高分 Opus 5.5 Max 为 57.8%,但每任务 $13.43。

Cursor 上线 DeepSeek V4.1 Flash:CursorBench 4.0 四档推理全部落在成本前沿,Max 档 47.7%、每任务 $0.98

核心要点速览

  • 四档跑分(CursorBench 4.0 官方榜):Max 47.7%/$0.98、Medium 46.3%/$0.80、High 45.6%/$0.77、Low 44.9%/$0.60,Max 档在全榜排第 17
  • 性价比对比:Max 档 47.7% 与 Sonnet 5.5 High(47.8%,$1.20)几乎持平但便宜约 18%;Opus 5.5 Max 高约 10 个百分点,但每任务 $13.43,约是它的 13.7 倍
  • 同价位对手:Haiku 5.5 Max 48.4%/$1.12、Haiku 5.5 Extra High 44.3%/$0.56,DeepSeek 正好卡在两者之间的价格段
  • 代价是 token 和步数:Max 档平均每任务约 53.7 万 token、187 步,Sonnet 5.5 High 只用约 3.7 万 token、41 步,长任务时延要有心理预期
  • 开启方式:Cursor Settings > Models 里打开;有个反直觉细节,Medium 档(46.3%)比 High 档(45.6%)分数略高、价格只贵 $0.03
阅读全文

Artificial Analysis 独立实测 DeepSeek Search 搜索 API:$0.75/千次极低成本突破基座模型 36 分

国际权威模型独立评测机构 Artificial Analysis 正式发布针对 DeepSeek 官方搜索增强 API(DeepSeek Search)的详尽基准测试数据。评测显示,挂载 DeepSeek 搜索模块后,基座模型的全域搜索综合指数从原先的 33 分暴涨至 69 分(净增 36 分,位列全部 27 款受测搜索 API 的第 17 位)。在成本维度上,DeepSeek Search 展现出无与伦比的颠覆性定价:每 1,000 次搜索请求仅收费 0.75 美元,折合单任务平均成本仅约 0.032 美元,成为全网受测商业搜索 API 中最经济的选项;在事实性问答基准 AA-Omniscience 达到 70% 准确率,而在复杂长程网页浏览任务 BrowseComp 则达到 63%。

Artificial Analysis 独立实测 DeepSeek Search 搜索 API:$0.75/千次极低成本突破基座模型 36 分

核心要点速览

  • Artificial Analysis 发布 DeepSeek Search API 独立实测数据,搜索综合指数达到 69 分(较未接入搜索的 33 分提升 36 分)
  • 定价极具杀伤力:每 1,000 次搜索仅需 0.75 美元,单任务平均耗费仅约 0.032 美元,为全网最便宜的商业搜索 API
  • 在跨领域事实性问答基准 AA-Omniscience 斩获 70% 准确率(位列 27 款受测模型第 10 位)
  • 在长程复杂网页浏览任务 BrowseComp 取得 63% 准确率,为大模型 Agent 开发者提供了高性价比的实时信息检索方案
阅读全文

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

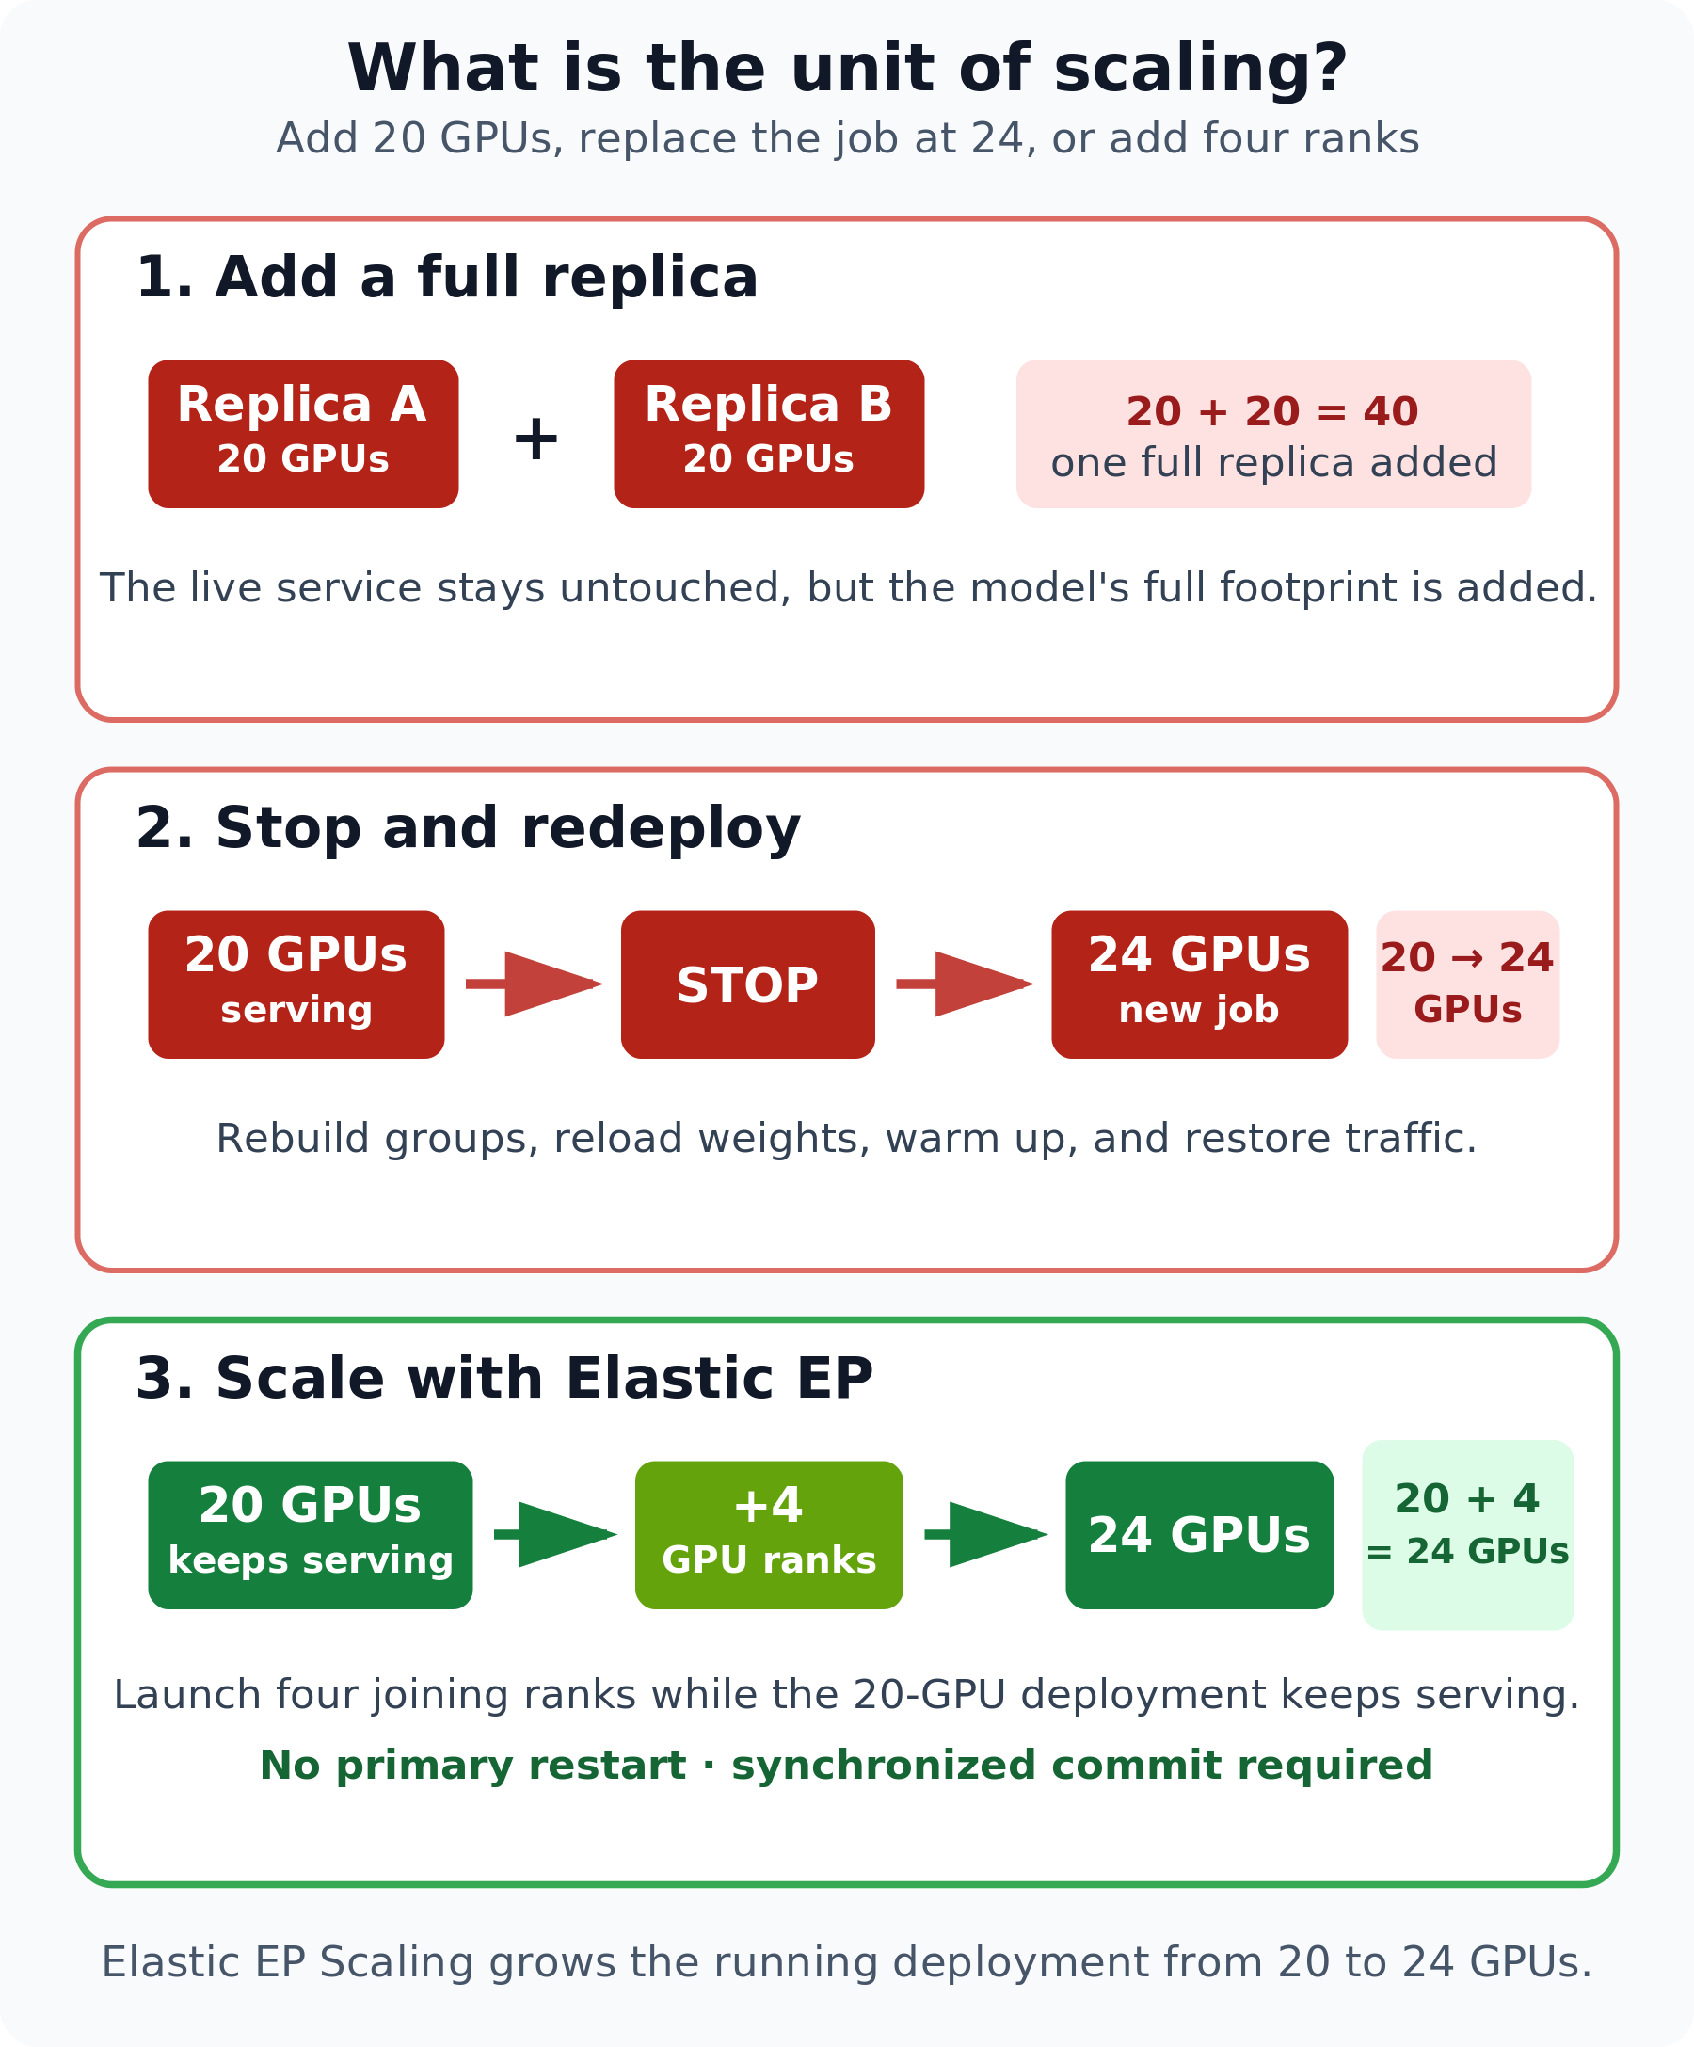
LMSYS 团队联合 NVIDIA Dynamo 团队在官方技术博客与 X(@lmsysorg)正式宣布,高性能大模型推理框架 SGLang 推出弹性专家并行(Elastic EP)与 NIXL(Near-Instant Cross-Node Link)动态伸缩后端。针对超大 MoE 架构(如 DeepSeek-V3/V4)在传统静态专家并行下因单卡硬件故障导致全集群崩溃重启、以及业务高峰期无法在线扩容的严重痛点,Elastic EP 实现了专家-GPU 映射解耦。依托 NVIDIA NIXL 高性能通信原语与 Mooncake 调度器,SGLang 首次实现在完全不中断在线推理请求的前提下,将运行中的 MoE 集群动态扩容(如从 20 卡无感扩展至 24 卡),并支持单节点故障的秒级自动降级容错。

SGLang 推出 Elastic EP 与 NIXL:运行时动态伸缩 MoE GPU 集群,零停机无缝扩容

核心要点速览

  • LMSYS 与 NVIDIA Dynamo 团队联手发布 SGLang Elastic EP,正式支持 MoE 模型在线动态扩缩容
  • 彻底破解静态专家并行(Static EP)在单节点硬件故障时全集群宕机的致命痛点,支持秒级自动容错降级
  • 集成 NVIDIA NIXL 高性能跨节点通信原语(--moe-a2a-backend nixl),支持 RDMA 与 NVLink 原生零拷贝调度
  • 实现零停机在线扩容(Live Scale-Up),集群可在持续处理生产推理请求的同时从 20 卡在线平滑扩容至 24 卡
阅读全文

vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

vLLM 官方联合蚂蚁集团正式开源底层高性能量化推理算子库 Humming(humming-kernels)。该算子库专为大规模混合专家(MoE)与低精度密集模型的高并发服务而设计,全面覆盖 WnA16、W8A8、W4A8 与 W4A4 多种量化精度,横跨 INT1~INT8 与 FP4~FP8 数据格式,并原生适配从 NVIDIA Turing 到 Blackwell 架构及平头哥真武 810E 芯片。实测显示,Humming 算子在小 Batch 下比 cuBLAS 快 3~4 倍,在大 Batch 下比 Marlin 快 2 倍;在 8 张 H20 GPU 上运行 DeepSeek-V4.1-Flash,64 并发下整机端到端吞吐暴增 43.3%,首字时延(TTFT)大幅降低 32%,现已作为默认引擎整合至 vLLM v0.29.0+ 中。

vLLM 联合蚂蚁集团开源 Humming 算子库:最高 5 倍算子加速,MoE 端到端吞吐提升 43.3%

核心要点速览

  • vLLM 与蚂蚁集团联合开源 Humming 高性能算子库(Apache 2.0),现已原生内置于 vLLM 0.29.0+ 核心代码中
  • 全方位打通 WnA16、W8A8、W4A8 与 W4A4 低比特精度,算子即时编译耗时仅需 1.82 秒(相比 CUTLASS 的 23.35 秒提速 12 倍)
  • 在 8 卡 H20 集群部署 DeepSeek-V4.1-Flash 实测:64 并发下吞吐从 442 提升至 634 tokens/s(净增 +43.3%)
  • 首字生成时延(TTFT)缩减 25%~32%,在下一代 B300 架构上 MoE 核心算子实现最高 5 倍极限加速
阅读全文

vLLM 与蚂蚁集团开源量化推理内核库 Humming:一套内核覆盖多种量化格式和 Turing 以来全部 NVIDIA GPU,DeepSeek-V4.1-Flash 端到端吞吐提升 14%–43%

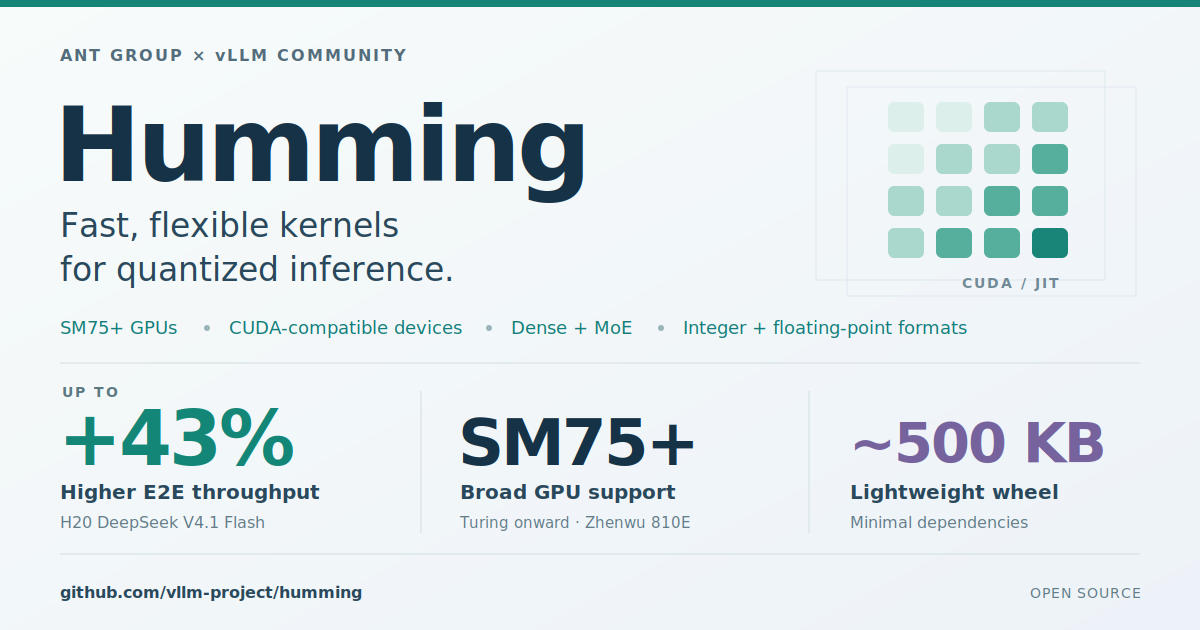
10 月 21 日,vLLM 社区与蚂蚁集团开源 Humming(Apache 2.0),一个用 JIT 编译按需生成 GEMM 内核的量化推理库,支持 Turing 起所有 NVIDIA 架构及平头哥真武 810E,覆盖 INT1–INT8、FP4–FP8 等权重/激活组合和稠密、MoE 两类负载。官方微基准中部分场景比 vLLM Marlin、FlashInfer、DeepGEMM 快 2–5 倍;在 8 张 H20 上跑 DeepSeek-V4.1-Flash,MoE 从 Marlin W4A16 换成 Humming W4A8 后吞吐提升 14%–43%。vLLM 0.29.0 起已内置。

vLLM 与蚂蚁集团开源量化推理内核库 Humming:一套内核覆盖多种量化格式和 Turing 以来全部 NVIDIA GPU,DeepSeek-V4.1-Flash 端到端吞吐提升 14%–43%

核心要点速览

  • 一套 JIT 内核框架替代按格式各写一个内核:支持 WNA16、W8A8、W4A8、W4A4,INT1–INT8 与 FP4–FP8 权重,稠密与 MoE
  • 硬件:Turing(SM75)起全部 NVIDIA GPU,含 Blackwell SM100/103/120/121,以及平头哥真武 810E
  • 端到端:8×H20、TP=8 跑 DeepSeek-V4.1-Flash,Humming W4A8 比 Marlin W4A16 吞吐高 14%–43%,平均 TTFT 降 25%–32%;并发 64 时输出 442→634 tok/s
  • 微基准(vLLM 社区测):H200 W4A8-MXFP4 约为 DeepGEMM W8A8 的 4.5 倍,B300 MoE Grouped 路径约为 Marlin 的 5 倍;单个 W4A16 内核编译 1.82 秒,CUTLASS 为 23.35 秒
  • 使用:pip install humming-kernels(wheel 约 500 KB);vLLM 0.29.0 起内置,用 --linear-backend humming --moe-backend humming 启用
阅读全文
关联模型 / 智能体 / 厂商:

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

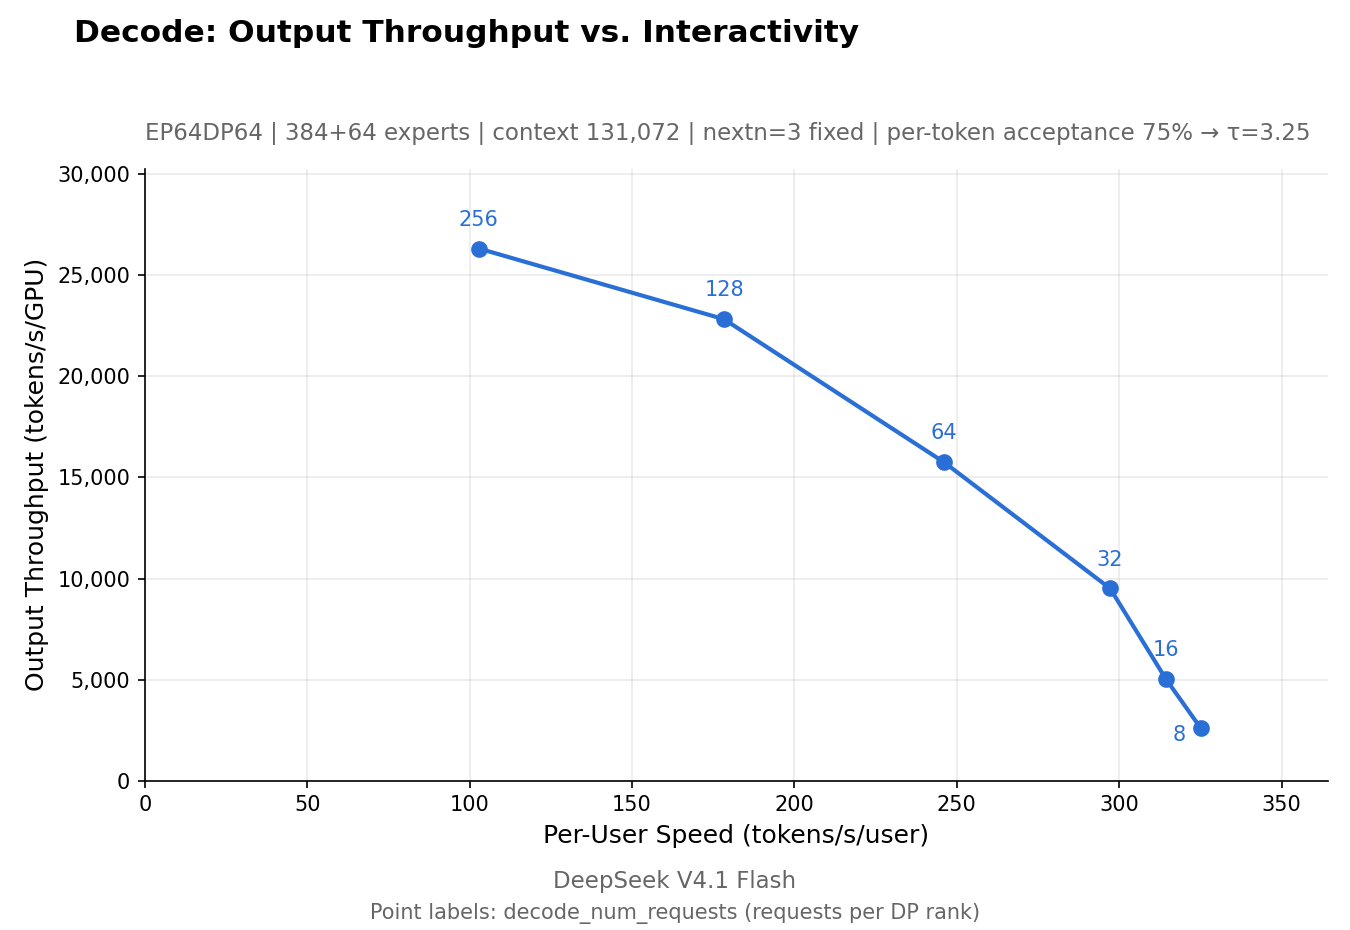
在 DeepSeek 宣布开源其生产级推理引擎 DeepInfer 数小时后,vLLM 官方项目团队正式公布了针对 DeepSeek-V4.1-Flash 的实测重磅性能对标数据。采用 DeepSeek 官方完全相同的测试拓扑(131K 超长上下文、nextn=3 投机采样),vLLM 在 NVIDIA GB200 NVL 架构上针对 Batch Size 8~256 的全并发区间,将与 DeepInfer 的端到端吞吐差距压缩至 6% 以内;在下一代 GB300 架构上,单 GPU 吞吐量突破 1,000,000 Token/秒,单用户峰值输出达 826 Token/秒,折合单 GPU 每小时营收达 38.96 美元。同时宣布 FastH3-Omni 与 Spark-X2.6-4B 首发支持。

vLLM 官方实测追平 DeepInfer:GB200 上吞吐差距缩小至 6%,GB300 单卡达百万 Token/秒

核心要点速览

  • vLLM 团队迅速公布实测对标数据,在 NVIDIA GB200 上运行 DeepSeek-V4.1-Flash 吞吐已追平至仅落后 DeepInfer 6%
  • 在下一代 NVIDIA GB300 硬件架构上,vLLM 实现单张 GPU 吞吐达 100 万 Token/秒,单用户峰值输出 826 Token/秒
  • 按 DeepSeek 线上非高峰期官方定价测算,单台 GPU 每小时可产生高达 38.96 美元的云端推理收益,经济效益惊人
  • 同步宣布对多模态视频大模型 FastH3-Omni 与拥有 100 万上下文的 4B 模型 Spark-X2.6-4B(Apache 2.0)提供 Day-0 首日原生支持
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

DeepSeek 官方正式开源其生产级高性能推理引擎 DeepInfer(基于 Apache 2.0 协议发布)。DeepInfer 汲取了 vLLM、SGLang 与 TensorRT-LLM 架构精华,专为大规模部署 DeepSeek-V4.1-Flash 设计。引擎支持 NVIDIA SM100 架构与华为昇腾 Ascend 950 NPU,原生集成 FlashMLA、DeepGEMM、DeepEP 与 TileKernels。引入 DSpark 置信度投机采样(默认 5 个 Draft Token)、SWA 有界重放(140 Token 窗口)与 MoE 专家并行动态负载均衡。同时开源生产级分词与编解码组件 deepseek-recipe,构建从模型、算子到推理服务的全栈开源生态。

DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

核心要点速览

  • DeepSeek 官方正式开源 DeepInfer 推理引擎(Apache 2.0),完整公开支撑 DeepSeek-V4.1-Flash 线上高吞吐与低延迟调度的底层代码
  • 跨异构硬件深度调优,同时全面适配 NVIDIA SM100 GPU 与华为昇腾 Ascend 950 NPU,提供硬件级确定性输出保证
  • 深度融合 FlashMLA、DeepGEMM、DeepEP 与 TileKernels 原生算子,并搭载基于 DSpark 的 5-Token 置信度投机解码与 140-Token 滑动窗口重放
  • 同步开源生产级 token 编解码套件 deepseek-recipe,彻底消除开源社区本地部署与官方 API 之间的对齐鸿沟
阅读全文

DeepSeek 开源生产推理框架 DeepInfer:支撑 V4.1-Flash 线上服务,含投机解码、批次不变推理与结构化输出,同步开源 deepseek-recipe

DeepSeek 于 10 月 20 日(UTC)开源内部推理框架 DeepInfer(Apache 2.0),即支撑 DeepSeek-V4.1-Flash 大规模线上服务的推理栈。本次开源版本提供离线推理,支持 Attention DP/CP、MoE EP+EPLB 并行、DSpark 投机解码、SWA bounded replay、批次不变推理、确定性采样和结构化输出,硬件为 NVIDIA SM100 与华为昇腾 950。KV cache 系统、PD 分离和负载均衡未包含在内。同时开源的 deepseek-recipe(MIT)负责把 Chat Completions、Messages、Responses 等格式请求统一转换并编码,对齐官方 API 行为。

DeepSeek 开源生产推理框架 DeepInfer:支撑 V4.1-Flash 线上服务,含投机解码、批次不变推理与结构化输出,同步开源 deepseek-recipe

核心要点速览

  • DeepInfer 以 Apache 2.0 开源,官方称即支撑 DeepSeek-V4.1-Flash 线上服务的推理框架,目前只支持这一个模型
  • 硬件仅支持 NVIDIA SM100(Blackwell)GPU 和华为昇腾 950 NPU;官方性能曲线测于 4 卡 prefill、64 卡 decode
  • 开源版缺 KV cache 系统、VE/Prefill/Decode 分离和多副本负载均衡三块,离完整线上服务还有距离
  • 官方给出的 V4.1 参考成绩(Pass@1,厂商口径):AIME 2026 99.9%、GPQA Diamond 93.4%、HLE-Full 42.6%,用于校验部署是否配置正确
  • 同步开源 deepseek-recipe(MIT,Rust+Python 绑定),统一处理 Chat Completions/Messages/Responses 请求转换与 token 编解码
阅读全文
关联模型 / 智能体 / 厂商:
⚡ DeepSeek-V4.1-Flash-1017🌐 DeepSeek🌐 NVIDIA🌐 Huawei

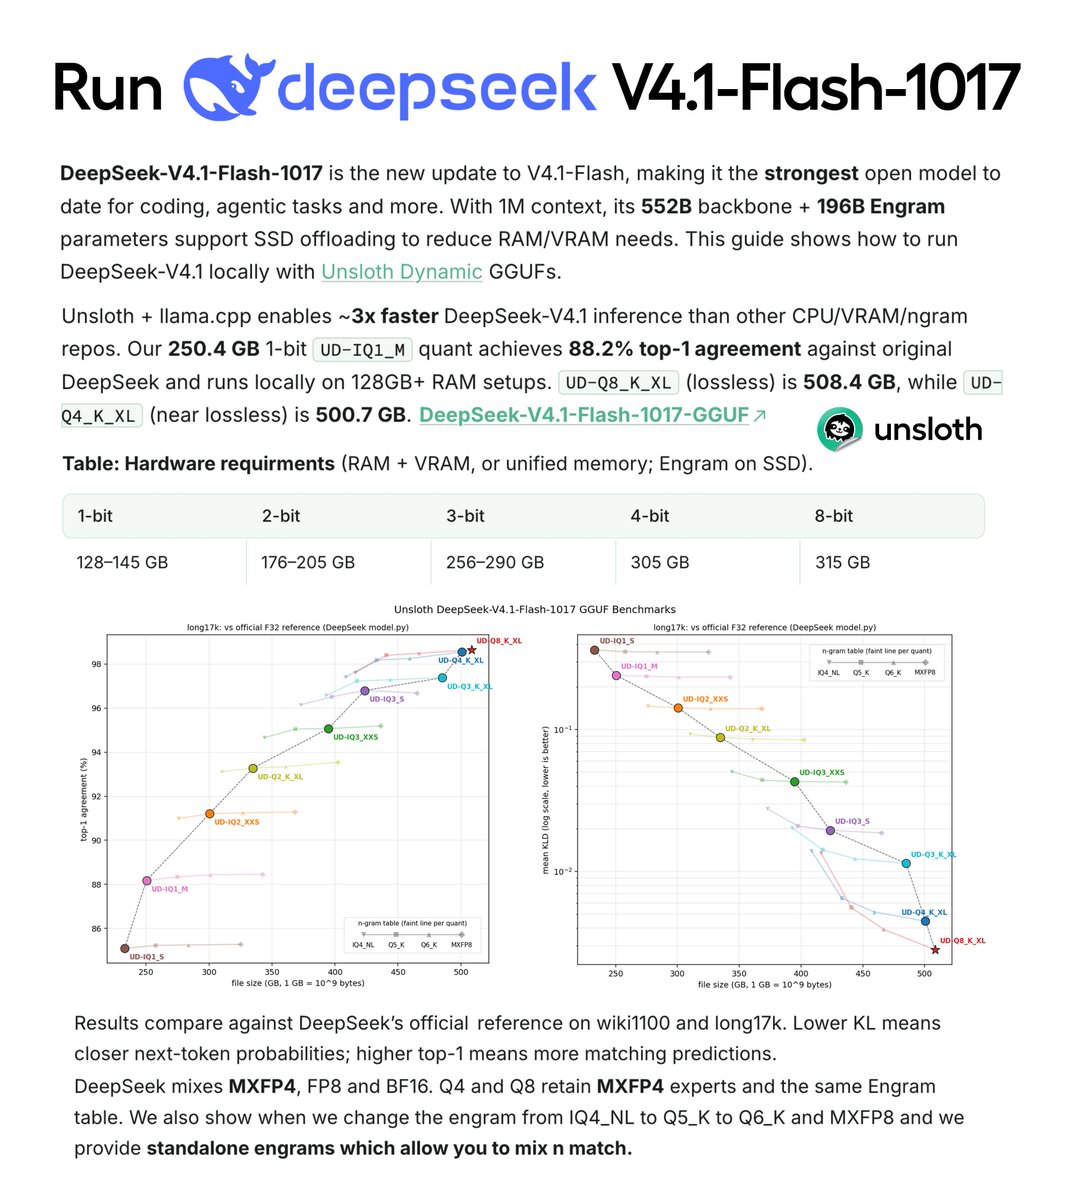
Unsloth 发布 DeepSeek-V4.1-Flash-1017 动态 GGUF:1-bit 版 250GB、128GB+ 内存可本地跑,Engram 表可放 SSD

Unsloth 于 10 月 19 日(UTC)发布 DeepSeek-V4.1-Flash-1017 的动态 GGUF 量化与本地运行指南。按 Unsloth 口径,1-bit UD-IQ1_M 体积 250.4GB(无损 Q8 为 508.4GB),在 long17k 上与官方权重 top-1 一致率 88.2%,可在 128GB+ 内存设备上运行;模型的 Engram n-gram 表(110.6–202.8GB)可通过 mmap 留在 SSD 按需读取。目前需用 Unsloth 的 llama.cpp 分支或 Unsloth Desktop 运行。

Unsloth 发布 DeepSeek-V4.1-Flash-1017 动态 GGUF:1-bit 版 250GB、128GB+ 内存可本地跑,Engram 表可放 SSD

核心要点速览

  • 1-bit UD-IQ1_M 250.4GB,较无损 UD-Q8_K_XL(508.4GB)缩小约 51%;long17k top-1 一致率 88.2%、wiki1100 为 87.1%(Unsloth 指南,厂商口径)
  • 最小的 UD-IQ1_S 为 233.0GB,适配 128GB 内存设备(如 Mac、DGX Spark),top-1 一致率 82.8%–85.1%;3-bit UD-IQ3_XXS 需约 256GB(如 Mac Studio),一致率 94.6%–95.1%
  • 模型由 552B 主干加 196B Engram 参数组成,Engram n-gram 表 110.6–202.8GB 可经 mmap 留在 SSD 按需加载,省内存但不省磁盘
  • Unsloth 称其基于 llama.cpp 的实现比其他 CPU/显存/ngram 方案推理快约 3 倍(厂商口径,未见第三方复测)
  • HF 仓库 为 MIT 许可,提供 IQ1_S 到 Q8_K_XL 共 9 档量化,另附可单独替换精度的 Engram 文件
阅读全文
关联模型 / 智能体 / 厂商:

真实世界 3D 资产生成大考:BlenderWorld 首发 223 项工业基准,GPT-6 Astra 斩获 79.9 分领跑

多所顶尖研究机构在 arXiv:2610.23986 中正式发布首个面向真实世界参考的视觉智能体 3D 创作评测基准 BlenderWorld。基准涵盖程序化建模、着色材质编写、空间布局与灯光模拟等 223 项真实工业级任务,接入 Blender 软件全自动沙盒环境。实测显示 GPT-6 Astra 以 79.9 分综合得分问鼎全球榜首(完美完成率达 42.2%),Opus-5 斩获 73.0 分,而开源模型 DeepSeek-V4.1-Flash 斩获 65.7 分超越众多大尺寸基线。

真实世界 3D 资产生成大考:BlenderWorld 首发 223 项工业基准,GPT-6 Astra 斩获 79.9 分领跑

核心要点速览

  • 多所顶尖机构发布首个面向真实世界 3D 资产创作的工业评测基准 BlenderWorld(arXiv:2610.23986),涵盖 223 项全自动 Blender 任务
  • GPT-6-Astra 以 79.9 分与 42.2% 完美率强势领跑全球榜首,Opus-5 斩获 73.0 分位居第二
  • 开源旗舰 DeepSeek-V4.1-Flash 斩获 65.7 分登顶开源第一,并在多模态子任务中以 65.5 分追平商业旗舰 GPT-5.6-Sol
  • 揭示截然不同的 Agent 求解流派:GPT 倾向于前瞻性规划(39.9K Token),而 DeepSeek 依靠高频工具迭代检查(单任务 168 次工具调用)
阅读全文
关联模型 / 智能体 / 厂商:

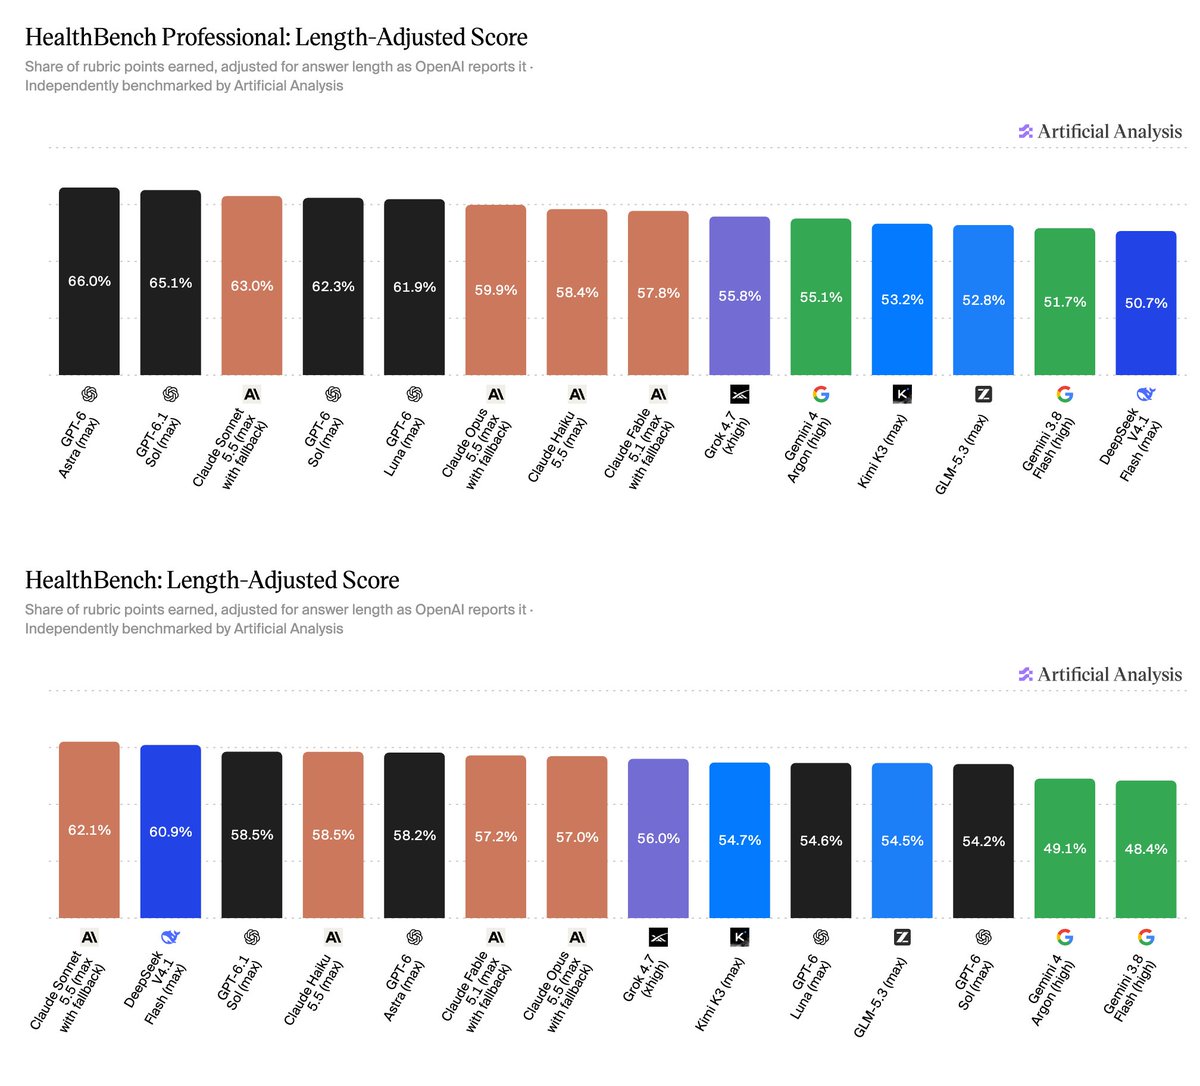
Artificial Analysis 上线 HealthBench 与 HealthBench Professional 榜单:GPT-6 Astra 以 66.0% 领跑临床医生对话,Claude Opus 5.5 原始分最高却因回答过长跌至第六

独立评测机构 Artificial Analysis 10 月 19 日上线两张医疗对话榜单,评测基于 OpenAI 的 HealthBench(5000 段真实健康对话)和 HealthBench Professional(525 段临床医生对话),由医生编写的评分细则打分,同时公布原始分和 OpenAI 采用的长度调整分。Professional 榜上 GPT-6 Astra(max)长度调整分 66.0% 第一,GPT-6.1 Sol 65.1%,Claude Sonnet 5.5 63.0%;Claude Opus 5.5 原始分最高(71.4%),但平均约 5900 字符的回答被扣分后跌到第六(59.9%)。HealthBench 榜上 Claude Sonnet 5.5 以 62.1% 第一,DeepSeek V4.1 Flash 60.9% 紧随其后,单任务成本约为前者的 1/16。

Artificial Analysis 上线 HealthBench 与 HealthBench Professional 榜单:GPT-6 Astra 以 66.0% 领跑临床医生对话,Claude Opus 5.5 原始分最高却因回答过长跌至第六

核心要点速览

  • HealthBench Professional(长度调整分):GPT-6 Astra(max)66.0%、GPT-6.1 Sol(max)65.1%、Claude Sonnet 5.5 63.0%。
  • Claude Opus 5.5 原始分 71.4% 全场最高,但平均回答约 5900 字符(阈值 2000 的近 3 倍),调整后掉到 59.9%、排第六;Claude Fable 5.1 同样被扣超过 11 分。
  • Professional 榜的分数-成本帕累托前沿全是 OpenAI 模型:GPT-6 Luna(max)61.9%、每任务 0.004 美元,不到 GPT-6 Astra(0.27 美元)成本的 2%。
  • HealthBench 榜:Claude Sonnet 5.5 62.1% 第一,DeepSeek V4.1 Flash 60.9%(每任务 0.005 美元),GPT-6.1 Sol 58.5%。
  • 评分沿用 OpenAI 原实现:Professional 由 GPT-5.4(low)判分,HealthBench 由 GPT-4.1 判分。
阅读全文