
Inworld Inference 全面开放:专为消费级 AI 打造的开源模型推理 API,Gemma 4 26B p95 首 token 比 OpenRouter 中位供应商快 7.8 倍
Inworld AI 于 2026-10-14 向所有开发者开放 Inworld Inference,定位为面向消费级应用(陪伴、家教、语音、互动小说)的推理服务。它不铺海量模型,而是为 Gemma 4、GLM 5.3 Flash、DeepSeek、MiMo 等开源模型逐个定制推理构建:草稿-验证(投机)解码、改写的 split-KV 验证注意力、KV 感知路由和按评测把关的低精度权重。官方口径:Gemma 4 26B p95 首 token 0.31 秒,比 OpenRouter 中位供应商快 7.8 倍;最高 90% 提示命中缓存;GLM 5.3 Flash 30 天 2000 万+请求成功率 99.999%。API 兼容 OpenAI SDK,按请求选 Flex/Default/Priority/Fast 四档。
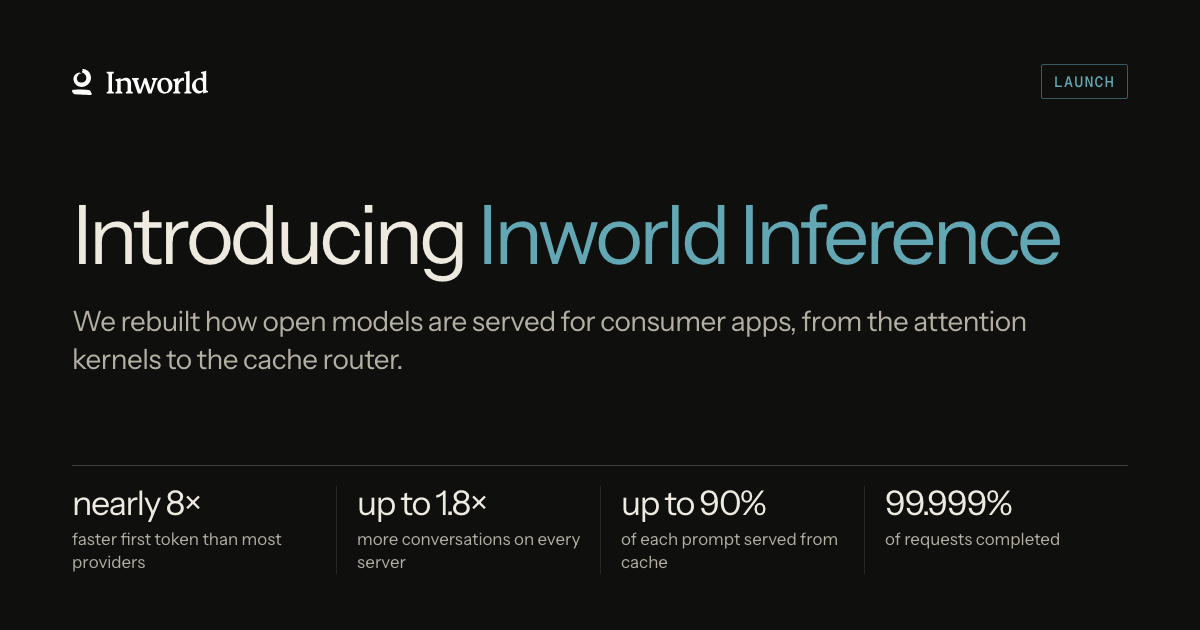
核心要点速览
- Gemma 4 26B 首 token:p50 0.17 秒 / p95 0.31 秒,较 OpenRouter 中位供应商快 3.6 倍 / 7.8 倍(官方博客,厂商口径,非同负载对比)
- 价格:Gemma 4 26B 输入 $0.07、缓存 $0.035、输出 $0.34 每百万 token,比不训练用户数据的供应商中位价低近 40%
- 改写验证注意力 kernel 后单层快 3.4–7.5 倍,注意力占解码步比例 27.5%→16.5%,p50 TTFT 154→117 ms,评测分数不变
- KV 感知路由:GLM 5.3 Flash 缓存命中 25%→47%,DeepSeek V4.1 Flash 11%→33%;MiMo 2.6 Pro 缓存输入便宜 99%
- 可靠性:GLM 5.3 Flash 30 天 2000 万+请求仅 98 次失败(约 4.8/百万);
service_tier支持 Flex/Default/Priority/Fast 四档
关联模型 / 智能体 / 厂商:
⚡ Gemma 4 26B⚡ Gemma 4 31B⚡ GLM-5.3-Flash⚡ MiMo 2.6 Pro⚡ DeepSeek-V4.1-Flash🌐 Inworld AI🌐 Google🌐 Zhipu🌐 Xiaomi🌐 DeepSeek🌐 OpenRouter