
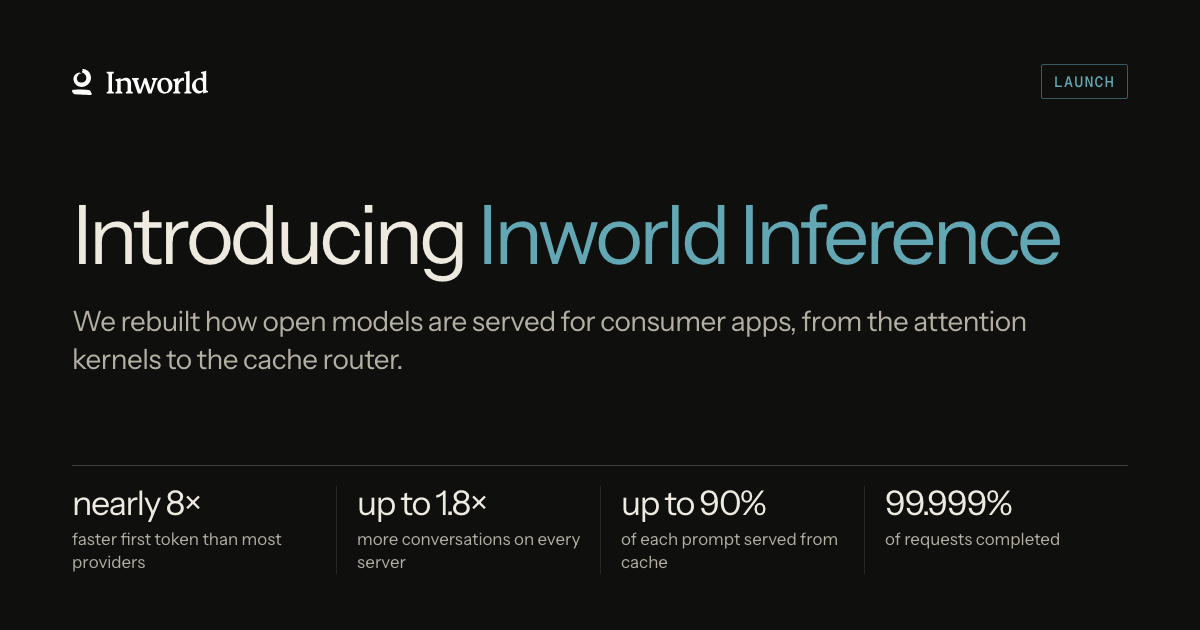
Inworld AI 于 2026-10-14 向所有开发者开放 Inworld Inference,定位为面向消费级应用(陪伴、家教、语音、互动小说)的推理服务。它不铺海量模型,而是为 Gemma 4、GLM 5.3 Flash、DeepSeek、MiMo 等开源模型逐个定制推理构建:草稿-验证(投机)解码、改写的 split-KV 验证注意力、KV 感知路由和按评测把关的低精度权重。官方口径:Gemma 4 26B p95 首 token 0.31 秒,比 OpenRouter 中位供应商快 7.8 倍;最高 90% 提示命中缓存;GLM 5.3 Flash 30 天 2000 万+请求成功率 99.999%。API 兼容 OpenAI SDK,按请求选 Flex/Default/Priority/Fast 四档。
核心要点速览
- ✓Gemma 4 26B 首 token:p50 0.17 秒 / p95 0.31 秒,较 OpenRouter 中位供应商快 3.6 倍 / 7.8 倍(官方博客,厂商口径,非同负载对比)
- ✓价格:Gemma 4 26B 输入 $0.07、缓存 $0.035、输出 $0.34 每百万 token,比不训练用户数据的供应商中位价低近 40%
- ✓改写验证注意力 kernel 后单层快 3.4–7.5 倍,注意力占解码步比例 27.5%→16.5%,p50 TTFT 154→117 ms,评测分数不变
- ✓KV 感知路由:GLM 5.3 Flash 缓存命中 25%→47%,DeepSeek V4.1 Flash 11%→33%;MiMo 2.6 Pro 缓存输入便宜 99%
- ✓可靠性:GLM 5.3 Flash 30 天 2000 万+请求仅 98 次失败(约 4.8/百万);
service_tier支持 Flex/Default/Priority/Fast 四档
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
大厂和多数推理商都在押注企业与编程场景,但消费级 AI(陪伴、家教、语音助手、互动小说)的约束正好相反:每一轮都要重发整段对话历史,Inworld 统计其服务的应用中位提示长度是回复的 13–36 倍;一次用户操作还会扇出安全审核、意图分类、记忆读写等约 20 次调用;用户月付 5–20 美元甚至免费,每次调用都必须极便宜。Inworld Inference 即为此而建,10 月 14 日向所有开发者开放。
架构亮点与底层机制
不追求模型数量,而是为每个开源模型单独做推理构建:草稿模型先写若干 token、主模型一次前向验证的投机解码(输出分布不变,见 Leviathan 等论文);把 Gemma 4 26B 的验证步改走 split-KV 注意力 kernel;KV 感知路由按“前缀命中量 × 副本负载”打分,把每轮对话送回持有其缓存的副本;MLP 用 NVFP4、注意力与 KV 保持 FP8,且每个构建必须在 MATH、MMLU-Pro、GSM8K 上不低于旧版才上线。
权威 Benchmark 与实测跑分对比
以下均为厂商口径:Gemma 4 26B p95 首 token 0.31 秒,对比 OpenRouter 中位供应商 2.42 秒(快 7.8 倍);验证注意力单层快 3.4–7.5 倍,p50 TTFT 154→117 ms;GLM 5.3 Flash 缓存命中 25%→47%,30 天 2000 万+请求仅 98 次失败。官方注明 OpenRouter 数据为快照,并非同负载对比。
开发者实战落地与开箱指南
API 兼容 OpenAI SDK:base_url 设为 https://api.inworld.ai/v1,模型如 inworld/models/gemma-4-26b-a4b-it。用 service_tier 按请求选档:后台摘要用 Flex(忙时快速失败且不计费),实时回复用 Fast;配置 fallback.ttft_timeout 可在首 token 超时后自动切备用模型。价格与模型列表见 Models,接入文档见 Inworld Docs。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察