AI 编程实时动态与要闻

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

美团 LongCat 团队 11 月 2 日在 API 平台更新日志中上线 LongCat-2.5,这是 9 月 25 日 LongCat-2.5-Preview 的正式版。官方技术博客称它总参数 1.6 万亿、每个 token 激活约 480 亿,在 LongCat-2.0 基础上强化原生视觉理解和智能体编程,训练和 W4A4 推理都在国产 AI 加速卡上完成。官方口径成绩包括 Terminal Bench v2.1 88.4、Terminal Bench v4.0 38.5、BrowseComp 91.9、MCP Atlas 83.1。API 支持 OpenAI 和 Anthropic 两种格式,1M 上下文、最多 128K 输出,限时价每百万 token 输入 $0.30、缓存输入 $0.006、输出 $1.20。

美团龙猫正式发布 LongCat-2.5:1.6T 总参、约 48B 激活的原生多模态智能体模型,API 限时 $0.30/$1.20

核心要点速览

  • 规模:1.6 万亿总参数 MoE,每 token 激活约 480 亿;1M 上下文、最高 128K 输出(官方博客、API 文档)
  • 代码智能体(官方口径):Terminal Bench v2.1 88.4(Claude Opus 5 89.1、GPT-5.6-Sol 88.8)、Terminal Bench v4.0 38.5(GPT-5.6-Sol 37.3、Claude Opus 5 53.9)、DeepSWE v1.1 64.6
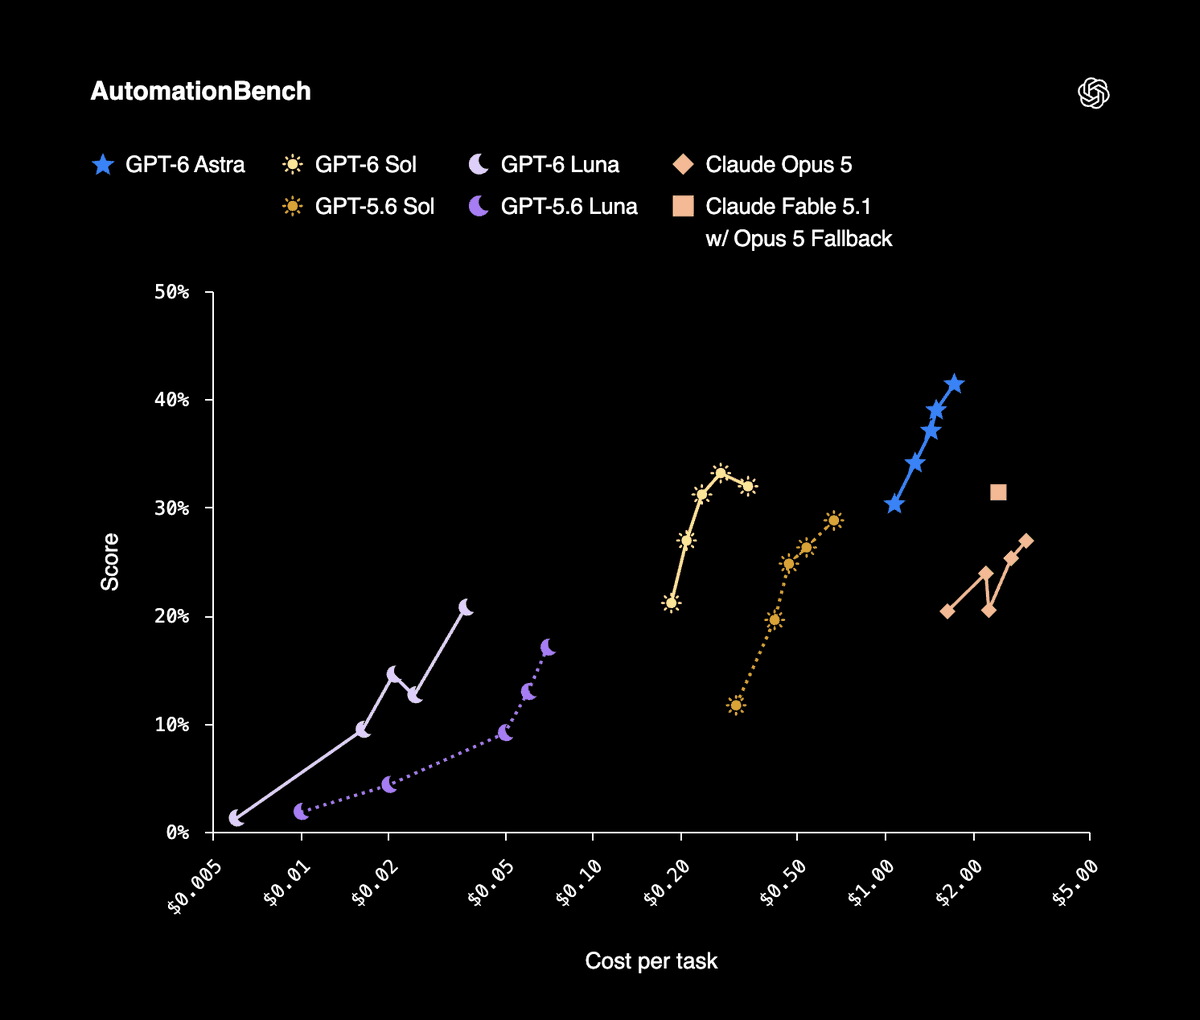
  • 通用智能体(官方口径):BrowseComp 91.9、MCP Atlas 83.1、AutomationBench v1.0.6 51.8、HLE w/tools 63.1;相比 LongCat-2.0 的 AutomationBench 15.8 大幅提升
  • 价格:限时每百万 token 输入 $0.30(¥2)、缓存输入 $0.006(¥0.04)、输出 $1.20(¥8)(定价页)
  • 工程:W4A4 推理相比 W8A8 基线预填充吞吐 +43.3%、解码吞吐 +42.77%;长序列 SFT 中 FSDP 单卡吞吐比 DDP 基线高 86%
阅读全文

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

OpenAI 10 月 26 日发布 GPT-6.1 Terra,定位是兼顾视觉推理、精确电脑操作和自然写作的高效模型,今天起向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise、Edu 用户开放,API 模型名 gpt-6.1-terra。标准 API 价格为输入 $1、缓存输入 $0.05、输出 $5(每百万 token),官方称比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%;上下文 1,050,000 token。官方口径下,它在 Agents' Last Exam 上中等推理强度比 GPT-5.6 Terra 高 15 个百分点、成本约三分之一,Terminal-Bench 4.0 最高强度 50.3%。

OpenAI 发布 GPT-6.1 Terra:主打快速低价的电脑操作,API 每百万 token $1/$5,比 GPT-5.6 Terra 和 GPT-6.1 Sol 便宜一半

核心要点速览

  • 价格(官方文档):输入 $1、缓存输入 $0.05、30 分钟缓存写入 $1.25、输出 $5 每百万 token;单次输入超过 272K token 时整单输入按 2 倍、输出按 1.5 倍计费;Batch/Flex 半价,Fast 模式 2 倍
  • 规格:上下文 1,050,000 token,最大输入 922,000、最大输出 128,000,知识截止 2026-06-01;reasoning.effort 支持 none 到 max 六档,工具调用需走 Responses API
  • 电脑操作(官方口径):Agents' Last Exam 中等强度比 GPT-5.6 Terra 高 15 个百分点、成本约 1/3,与 GPT-6 Astra 持平但每 token 价格只有其 1/10;完成速度比 GPT-6 Astra 和 GPT-6.1 Sol 快 3 倍以上
  • 编程与事实性(官方口径):Terminal-Bench 4.0 最高强度 50.3%,是 GPT-5.6 Terra 公布成绩 21.5% 的两倍多;内部易错题集低强度错误率从 53.6% 降到 16.7%
  • 安全:官方称在 Preparedness Framework 网络安全项达到 Critical 阈值,沿用 GPT-6 Astra 的防护措施
阅读全文

月之暗面发布 Kimi K3.1 Pro:2.8T 总参 / 104B 激活的开放权重 MoE,1M 上下文,Terminal-Bench 4.0 达 65.7%,API 降至 $2/$10,权重 11 月 4 日前开放

2026-10-23(UTC 17:15,SGT 10-24 01:15),Kimi 官方账号 @Kimi_Moonshot 正式发布 Kimi K3.1 Pro,同时推出快 2–3 倍的 K3.1 Pro Highspeed,已在 Kimi.ai、Kimi Work、Kimi Code 和 Kimi API 上线,完整权重承诺 2026-11-04 前开放。官方技术博客称它是 K3 的后训练版本(更大规模多领域联合 RL),MoE 总参 2.8T、激活 104B,1M token 上下文,多模态。厂商口径跑分:Terminal-Bench 4.0 65.7%(GPT-6 Astra 58.2%、Claude Opus 5.5 66.4%),BenchCAD 带工具 92.7%。Kimi API 定价页显示 kimi-k3.1-pro 输入 $2、输出 $10、缓存命中 $0.20 每百万 token,低于 K3 的 $3/$15。

月之暗面发布 Kimi K3.1 Pro:2.8T 总参 / 104B 激活的开放权重 MoE,1M 上下文,Terminal-Bench 4.0 达 65.7%,API 降至 $2/$10,权重 11 月 4 日前开放

核心要点速览

  • MoE 总参 2.8T、激活 104B,1M token 上下文,多模态;完整权重承诺 2026-11-04 前开放(官方博客)
  • 厂商口径:Terminal-Bench 4.0 65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%;内部 Kimi Code Bench 3.0 长程 61.2%(K3 为 55.95%)
  • API 定价:kimi-k3.1-pro 输入 $2 / 输出 $10 / 缓存命中 $0.20 每百万 token;Highspeed 版 $4 / $20(定价页)
  • 内部幻觉压力测试 Kimi Hallu Bench Hard:声明级幻觉率从 K3 的 23.4% 降到 8.3%(官方注明不代表日常错误率)
  • 开放权重版在中期训练和 RL 阶段移除了网络安全相关数据:xdev-bench-hard pass@3 从未处理版的 90.5% 降到 81.0%
阅读全文
关联模型 / 智能体 / 厂商:

Inception 正式发布 Mercury 3:扩散架构大模型突破 1000 Token/s,100 万上下文挑战 GPT-6 与 Haiku

前沿 AI 初创公司 Inception 联合创始人 Stefano Ermon 宣布正式推出新一代扩散架构大语言模型 Mercury 3。模型在 NVIDIA GPU 上实现高达 1,068 Token/秒的超高生成吞吐,参数量达到前代 Mercury 1 的 40 倍并支持 100 万(1M)Token 原生上下文。在 IFBench、GPQA Diamond 与 SWE-Bench Atlas 基准上全面对标前沿闭源基线,输入/输出百万 Token 标准定价为 0.20 / 0.70 美元(上线期半价优惠仅需 0.10 / 0.35 美元)。

Inception 正式发布 Mercury 3:扩散架构大模型突破 1000 Token/s,100 万上下文挑战 GPT-6 与 Haiku

核心要点速览

  • Inception 联合创始人 Stefano Ermon 正式发布扩散架构大模型 Mercury 3,在 NVIDIA GPU 上实现 1,068 Token/秒的超高吞吐
  • 模型参数扩充至 Mercury 1 的 40 倍,支持 100 万原生超长上下文(4 倍于 Mercury 2.5),标准定价百万输入/输出仅 0.20 / 0.70 美元
  • 在 IFBench、GPQA Diamond 与 SWE-Bench Atlas 测试中表现亮眼,基准综合智能达到前代 3 倍且同步上线 OpenRouter
  • 彻底摆脱自回归逐字预测瓶颈,以并行扩散去噪实现亚秒级长文本代码生成,极大优化高并发 Agent 运行效率
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

MiniMax 正式推出新一代旗舰轻量大模型 M3.1 Flash(此前以 Space Bunny 代号霸榜全球竞技场 200T+ Token)。模型支持 100 万 Token 原生上下文,百万输入/输出 Token 定价低至 0.15 / 0.60 美元(缓存读取仅 0.015 美元),推理速度较 M3 提升 3 倍且成本降低三分之二。在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,定于 10 月 23 日正式开源权重。

MiniMax 正式发布 M3.1 Flash:100 万超长上下文、百万 Token 仅 0.15 美元,WebDev 竞技场大幅跃升 106 分

核心要点速览

  • MiniMax 正式发布新一代旗舰轻便大模型 M3.1 Flash,揭秘其正是此前霸榜竞技场超 200T Token 的神秘代号 Space Bunny
  • 支持 100 万原生超长上下文,百万输入/输出仅需 0.15 / 0.60 美元(缓存读取 0.015 美元),推理速度提升 3 倍且成本降低三分之二
  • 在 LMSYS Code Arena: WebDev 中斩获 1588 分跃升 106 分,位列开源模型第 12 名,游戏开发(+179 分)与参考设计(+155 分)大幅飞跃
  • Artificial Analysis 独立测评显示 Intelligence Index 达 42 分且 HLE 达 48%,完成基准测试消耗 Token 较竞品减少近半,权重将于 10 月 23 日全面开源
阅读全文
关联模型 / 智能体 / 厂商:

Liquid AI 开源 LFM2.5-24B-A2B:24B 总参、约 2B 激活的推理型 MoE,主打本地 Agent 与工具调用

Liquid AI 10 月 13 日发布 LFM2.5 家族最大也是最后一款模型 LFM2.5-24B-A2B:总参 24B、每 token 激活约 2.45B,131K 上下文,强制先思考再回答。厂商口径下在 8 项工具/Agent 基准中 5 项领先或持平 Qwen3.6-35B-A3B(AutomationBench 27.69 vs 8.72),但 SWE-Bench Verified、GPQA 等知识与编码项落后。权重已上 Hugging Face,并有 GGUF/MLX/FP8/ONNX 版本;API 定价 $0.10/$1.00 每百万 token,OpenRouter 同步上架。

Liquid AI 开源 LFM2.5-24B-A2B:24B 总参、约 2B 激活的推理型 MoE,主打本地 Agent 与工具调用

核心要点速览

  • 规格(模型卡):总参 24.0B、激活 2.45B;40 层(30 个门控短卷积块 + 10 个 GQA);每个 MoE 块 64 专家 top-4 路由;上下文 131,072、词表 128K
  • Agent 基准(厂商口径,对比 Qwen3.6-35B-A3B):AutomationBench 27.69 vs 8.72、LiveClaw 48.09 vs 38.19、ToolSandbox 80.71 vs 75.02、BFCLv4 65.01 vs 65.00
  • 短板同样公开:SWE-Bench Verified(OpenCode)51.00 vs 66.20、GPQA Diamond 74.42 vs 83.69、WebArena Verified 26.75 vs 37.62,官方建议知识类任务搭配检索
  • 速度(官方博客):Apple M5 Max 解码 184 tok/s、AMD Ryzen AI Max+ 395 为 114 tok/s;单张 B300 + SGLang 高并发超 21K 输出 tok/s
  • 训练:预训练由 17T 扩到 33T token,中训 2T@32K + 300B@131K;后训练含在 OpenClaw、Hermes Agent、Pi、OpenCode 中的 Agentic RL;API $0.10 输入 / $1.00 输出每百万 token
阅读全文
关联模型 / 智能体 / 厂商:
⚡ LFM2.5-24B-A2B⚡ LFM2.5-24B-A2B-Base⚡ LFM2-24B-A2B⚡ Qwen3.6-35B-A3B⚡ Gemma-4-26B-A4B-it🤖 Hermes Agent🤖 OpenClaw🤖 OpenCode🤖 Pi🌐 Liquid AI🌐 Hugging Face🌐 OpenRouter

Claude Code 2.1.280:默认 Opus 换成 Opus 5.5(1M 上下文),API 价 $4/$20

Claude Code 更新日志账号(@ClaudeCodeLog)称 2.1.280 已发布,共 114 项 CLI 变更。官方 CHANGELOG 写明:新增 Claude Opus 5.5(claude-opus-5-5)并成为默认 Opus 模型,提供 1M 上下文,API 价为每百万 Token $4 输入 / $20 输出,缓存读取 $0.20/MTok;同时改进自动模式在安全审核拒绝或无响应时的拒绝与退避,避免重试死循环。

Claude Code 2.1.280:默认 Opus 换成 Opus 5.5(1M 上下文),API 价 $4/$20

核心要点速览

  • 默认 Opus 模型切换为 Claude Opus 5.5(claude-opus-5-5),上下文 1M。
  • API 定价 $4/$20 每百万 Token,缓存读取 $0.20/MTok。
  • 自动模式在安全审核拒绝/无响应时改为单次拒绝并退避,减少重试死循环。
阅读全文

Anthropic 正式发布 Claude Opus 5.5:开启 5.5 世代,运行成本直降 40%、推理速度提升超 30%

Anthropic 宣布全新旗舰模型 Claude Opus 5.5 正式上线,作为 Claude 5.5 家族的首发成员。官方实测显示,Opus 5.5 在绝大部分复杂推理与 Agentic 编码任务中已达到前代旗舰 Claude Fable 5.1 水平,而在典型企业工况下的运行成本相比 Opus 5 降低了 40%,输出速度提升超 30%,API 价格定为输入 $4/M、输出 $20/M,提示词缓存读取仅 $0.20/M。

核心要点速览

  • Claude 5.5 世代首发旗舰,多项核心任务综合能力平齐 Claude Fable 5.1。
  • 单任务综合成本降低约 40%,输出吞吐速度提升超 30%,大幅改善长链路 Agent 响应延迟。
  • API 价格为 $4/M 输入、$20/M 输出,提示词缓存读取仅 $0.20/M,缓存写入 $5/M。
  • 在 Anthropic 自动化行为安全审计中取得历史最高分,强化敏感代码与网络防御过滤。
阅读全文
关联模型 / 智能体 / 厂商:

OpenAI 推出 GPT-6 Sol 与 Luna:企业级双主力模型登场,API 价格腰斩低至 $0.10/M

OpenAI 宣布 GPT-6 家族迎来两款企业级主力模型 —— GPT-6 Sol 与 GPT-6 Luna。两款模型继承了月初旗舰 GPT-6 Astra 的核心智能,通过新型投机解码与推理管线优化,将 API 价格较此前促销价腰斩 50%:高精度任务专用的 Sol 定价为 $2/$10 每百万 Token,高吞吐低延迟专用的 Luna 仅需 $0.10/$0.50 每百万 Token,且提示词缓存读取享受 90% 极限制扣。即日起登陆 ChatGPT Work 与 Codex,并向全量开发者开放 API。

OpenAI 推出 GPT-6 Sol 与 Luna:企业级双主力模型登场,API 价格腰斩低至 $0.10/M

核心要点速览

  • 双模型分层矩阵:GPT-6 Sol 主打高精度复杂代码与智能体规划,GPT-6 Luna 主打高并发超低成本数据处理与辅助补全。
  • 价格腰斩:Sol 为 $2.00 输入 / $10.00 输出;Luna 仅需 $0.10 输入 / $0.50 输出,配合 90% 缓存读取折扣性价比极高。
  • 全生态立即上线:API 标识 gpt-6-sol 与 gpt-6-luna,同步开放于 ChatGPT Work、Codex,桌面端面向全量用户开放 Luna 体验。
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic:Claude Sonnet 5 的 $2/$10 百万 token 定价改为长期标准价,原定 9/1 涨至 $3/$15 取消

Anthropic 官方定价文档确认:Claude Sonnet 5 发布时标为截至 2026-08-31 的入门价 $2/$10(输入/输出每百万 token),现已定为标准价;原定 2026-09-01 上调至 $3/$15 将不会执行。对长期以 Sonnet 5 做编码智能体与 API 预算的团队是利好。

核心要点速览

  • 官方文档:Sonnet 5 维持 $2 输入 / $10 输出每百万 token,不再是限时入门价。
  • 原定 2026-09-01 涨至 $3/$15 的计划取消。
  • 对 Claude Code / API 编码工作负载的长期成本模型更可预期。
阅读全文
AD赞助内容

通义千问发布 Qwen3.8-Max-0902:2.4T 参数、百万上下文,编程与协作后训练强化

阿里通义宣布 Qwen3.8-Max 升级为 Qwen3.8-Max-0902:约 2.4T 参数、1M 上下文,并在 Coding 与 Cowork 方向继续后训练,面向复杂企业任务、科研与长程工作流。QwenCloud API 定价为每百万 Token 输入 2 美元、输出 6 美元;显式/隐式缓存命中分别为 0.17 / 0.25 美元。

核心要点速览

  • Qwen3.8-Max-0902 正式上线 QwenCloud API,面向编程与协作长程任务。
  • 规模约 2.4T 参数、1M 上下文,相对前代 Max 强化 Coding/Cowork 后训练。
  • 标价 2/6 美元每百万 Token,缓存命中可低至 0.17–0.25 美元。
阅读全文

Yutori 发布 Navigator n2:27B 桌面级 Computer-Use 模型,打通 GUI、命令行、API 与代码

Yutori 正式推出 Navigator n2,这是一款 27B 参数的通用桌面级电脑操作大模型,全面覆盖 Linux、macOS 与 Windows 系统。在 OSWorld 2.0 评测中斩获 65.2%,API 定价每百万 Token 输入 $0.50(缓存 $0.05)、输出 $4.00。

核心要点速览

  • 多模态混合决策:不再单纯依靠缓慢的 GUI 点击,模型会智能在图形界面、Shell 命令、系统 API 或即时脚本间自动选择最快路径;
  • 基准跑分拔尖:OSWorld 2.0 达到 65.2%、OSWorld-Verified 85.3%、MacAgentBench 83.1%;
  • 27B 的适中参数规模与低廉费率让桌面级智能体从演示阶段正式步入规模化工业部署。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Yutori Navigator N2

阿里通义千问开源 Qwen3.8-Flash:125B 稀疏 MoE 架构,提前预览 Qwen4 前沿技术

阿里通义千问正式开源 Qwen3.8-Flash 多模态 MoE 模型,总参 125B 激活仅 6B,采用 GDN、稀疏注意力与 Muon 优化器等 Qwen4 预研技术,训练成本仅为前代 1/9 且代码能力超越 Qwen3.7-Plus,官方 API 定价低至 $0.15 / $0.47。

核心要点速览

  • 全新底层架构:融合 GDN 门控残差、Qwen 稀疏注意力、N-gram 嵌入与 Muon 优化器,系 Qwen4 架构技术先行预览;
  • 编程与自动化基准出色:DeepSWE 1.1 获 58.7 分、SWE-bench Pro 62.5 分、CoWorkBench 73.9 分;
  • QwenCloud、OpenRouter、vLLM、SGLang 与 Unsloth 均已首日支持,本地仅需约 75GB 内存即可运行 GGUF。
阅读全文
关联模型 / 智能体 / 厂商:

阿里通义开源 Qwen3.8-Flash:125B/6B 多模态 MoE,SWE-bench Pro 达 62.5 预览 Qwen4 架构

阿里云通义千问团队开源发布 Qwen3.8-Flash,作为 Qwen4 架构的早期技术预览。模型采用 125B 总参、单 Token 仅激活 6B 的高效 MoE 结构,训练成本仅为上一代 Plus 的 1/9,在 SWE-bench Pro 上取得 62.5 分,DeepSWE 1.1 达到 58.7 分。支持原生 262K 上下文并可通过 YaRN 外推至 1M,QwenCloud 定价低至 $0.16 / $0.47 per 1M tokens。

核心要点速览

  • 125B 总参、6B 极低激活量,SWE-bench Pro 达 62.5 分,编码能力大幅跃升。
  • QSA 混合注意力内核在 1M 长上下文下实现 7.6 倍预填充与 4.9 倍解码加速。
  • 首发上线 QwenCloud、OpenRouter 与 OpenCode,全面开放商业开源权重下载。
阅读全文
关联模型 / 智能体 / 厂商: