AI 编程实时动态与要闻

微软开源 4B 电脑操作智能体 Mage-VL-Cowork:一个模型自己决定点界面还是写 bash,OSWorld-Verified 66.0%

微软 Mage 团队 10 月 30 日在 Hugging Face 以 Apache-2.0 发布 Mage-VL-Cowork:4B 参数的多模态电脑操作智能体,同一个模型每一步自己选择用截图点界面(computer_use)还是在终端跑 bash/Python,不需要外部调度器。官方报告它在 OSWorld-Verified(361 题、50 步上限)两次平均 66.0%,高于 Qwen3.6-27B 的 63.9%,但仍低于 9B 的 SCALECUA-Qwen3.5-9B(68.7%)。

微软开源 4B 电脑操作智能体 Mage-VL-Cowork:一个模型自己决定点界面还是写 bash,OSWorld-Verified 66.0%

核心要点速览

  • 4B 参数,基于 Mage-VL(Mage-ViT 视觉编码器 + Qwen3-4B-Instruct-2507),bf16 权重约 9.48 GB,Apache-2.0 许可。
  • OSWorld-Verified 两次独立跑分 65.33% 和 66.75%,取平均 66.0%;操作系统类任务 87.5%,多应用工作流 62.7%。
  • 官方对比:同一个 LibreOffice Calc 建图表任务,它用终端里的 Python 改表格 39 秒完成(6 步),纯界面操作的 Qwen3.6-27B 用了 9 分 56 秒(39 步)。
  • 在线 RL 比混合 SFT 再提升 10.16 个百分点,同时平均模型调用次数减少 13.0%、输出 token 减少 25.4%。
  • 训练数据由 Mage-CUA-Forge 生成约 29.4 万个桌面和网页任务,覆盖 6,915 种技能,单任务生成成本从 0.906 美元降到 0.158 美元。
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Mage-VL-Cowork⚡ Mage-VL⚡ Qwen3-4B⚡ Qwen3.6-27B🌐 Microsoft

Vercel Labs 发布 agent-desktop:给任意编码 Agent 的桌面 Computer Use,基于系统无障碍树而非截图像素,支持 macOS/Windows/Linux

10 月 31 日,Vercel Labs 的 Chris Tate(agent-browser 作者)在 X 上发布 agent-desktop,称其为「整台电脑版的 agent-browser」。它是一个 Rust 编写、Apache-2.0 开源的 CLI 和 C 库:读取桌面应用的系统无障碍树,以 JSON 返回每个可操作元素的 ref,Agent 按 ref 点击、输入后再快照核对,不做像素匹配,默认在后台无头运行。1.0.0 已于 10 月 27 日发布并首次加入 Linux 支持,目前 npm 最新版为 1.0.2。

Vercel Labs 发布 agent-desktop:给任意编码 Agent 的桌面 Computer Use,基于系统无障碍树而非截图像素,支持 macOS/Windows/Linux

核心要点速览

  • 安装:npm install -g agent-desktop,一个包自带 x64/ARM64 原生二进制;1.0.0(10-27)加入 Linux(glibc 2.35+,经 AT-SPI),npm 最新 1.0.2(10-30)
  • 工作方式:snapshot 输出带 ref 的 JSON 树,click @<snapshot_id>:eN 操作,再 snapshot 核对;UI 变化时返回 STALE_REF,错误里带 retry 是否安全的标记
  • 规模:README 称共 60 个命令名、56 个可用命令,覆盖窗口、键鼠、通知、剪贴板、等待与会话追踪
  • 默认无头:按 ref 的操作走无障碍 API,不移动鼠标、不抢焦点,需要真实输入时加 --headed;Chris Tate 称多个 Agent 可各带一个光标并行使用电脑
  • 跑分:官方未公布任何成功率或速度基准;它只是工具,不内置模型,网页自动化仍交给 agent-browser
阅读全文

腾讯混元开源同声传译模型 Hy-SimulMT:中英双向实时语音翻译,延迟约 3 秒并支持实时音色克隆

腾讯混元(Tencent Hy)10 月 26 日开源实时同声传译模型 Hy-SimulMT,支持中英双向语音到语音翻译,边听边译,同时输出译文文本和语音,并可实时克隆说话人音色。Hugging Face 上一次放出 6 个权重(30B-A3B 的纯译文版与带原文的 Interleave 版,各含 BF16、FP8、GGUF),模型卡标注 Apache-2.0;GitHub 同步提供 SimulInfer 推理服务与 SimulTrain 训练工具。官方口径:RealSI 长音频评测 StreamLAAL 约 3 秒,为对比系统最低。

腾讯混元开源同声传译模型 Hy-SimulMT:中英双向实时语音翻译,延迟约 3 秒并支持实时音色克隆

核心要点速览

  • 规模与形态:30B-A3B MoE(约 3B 激活),共 6 个权重:纯译文版与 Interleave(原文+译文)版,各有 BF16、FP8、GGUF(Hugging Face 合集)
  • 延迟(官方/厂商口径):RealSI 长音频评测 StreamLAAL 约 3 秒,为对比系统中最低,GEMBA 质量分超过对比的开源模型和 5 个商业 API 中的 4 个
  • 短音频(官方/厂商口径):FLEURS 90.3、CoVoST2 75.5、ACL6060 81.2、RealSI-Sentence 84.7,后者为表中所有系统最高;同表 Qwen3.8-LiveTranslate 为 88.4/82.1/80.5/84.4
  • 真人对比:18 段约 6 分钟的真实中英音频,对比 6 名 CATTI 一级/二级口译员,官方称质量相当、延迟常更低,并注明仅适用于该小规模测试
  • 部署:SimulInfer 一条 deploy.sh 命令拉起 vLLM(需 >=0.31)与 Web/WebSocket 服务,语音输出和音色克隆需另配 TTS;llama.cpp 支持尚未合入上游(SimulInfer 文档)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Hy-SimulMT-30B-A3B⚡ Hy-SimulMT-30B-A3B-Interleave⚡ Qwen3.8-LiveTranslate🌐 Tencent

阿里通义实验室开源 OpenGCUA:通用计算机控制智能体全开源技术栈,OSWorld 步数锐减 53%

阿里巴巴通义实验室(Tongyi-MAI)在 arXiv:2610.22200 正式发布并全面开源 OpenGCUA(Open Generalist Computer-Use Agent)通用计算机控制智能体技术栈。针对当前 GUI 智能体过度依赖逐帧截图与单点点击、无法执行高效批处理操作的行业痛点,OpenGCUA 首创“代码执行即行动(Code-Execution-as-Action)”范式,将视觉感知、可访问性树(Accessibility Tree)、Bash 脚本与 Playwright API 深度融合。在权威 OSWorld-v2 基准测试中,OpenGCUA 推动各大主流前沿模型平均得分大幅提升 19.6 分,同时将任务完成平均步数削减 53.0%,并配套开源了 macOS 实体机状态栏应用与跨设备 SDK。

阿里通义实验室开源 OpenGCUA:通用计算机控制智能体全开源技术栈,OSWorld 步数锐减 53%

核心要点速览

  • 阿里通义开源 OpenGCUA 全技术栈,收录于 arXiv:2610.22200,代码采用 Apache 2.0 协议全面开源
  • 提出“代码执行即行动”机制,将多轮循环点击转化为包含条件分支、循环与 API 调用的聚合 Python/Bash 脚本
  • 在权威 OSWorld-v2 基准测试中,推动跨 8 大前沿模型平均基准分提升 +19.6 分,平均执行步数削减 53.0%
  • 开源发布 macOS 物理设备状态栏调度 Harness 及连接 PC、浏览器与移动端的 Cross-Device SDK
阅读全文
AD赞助内容

腾讯混元开源 Hy Memory 2.0:3B 激活的记忆写入模型跨 4 套框架均分 55.49(官方口径略超 Opus 5),MemHub 打通 Claude Code/Cursor/Codex 本地记忆

腾讯混元 10 月 16 日开源 Hy Memory 2.0,三层齐发:Apache-2.0 的专用记忆写入模型 Hy-Memory-30B-A3B(约 3B 激活,HF + arXiv 技术报告)、覆盖 Chat/Working/Coding 三种场景的 Python SDK(PyPI hy-memory 2.0.x),以及本地优先的 MemHub(CLI + macOS,preview)。官方口径下,该模型替换 Mem0、MemOS、Hy-Memory 与留出的 EverMemOS 中的写入 LLM 后四框架均分 55.49,Claude Opus 5 为 54.62;评测基于固定 20% 子样本,部分单项仍落后 Opus 5。

腾讯混元开源 Hy Memory 2.0:3B 激活的记忆写入模型跨 4 套框架均分 55.49(官方口径略超 Opus 5),MemHub 打通 Claude Code/Cursor/Codex 本地记忆

核心要点速览

  • 官方口径:四框架均分 55.49,Claude Opus 5 为 54.62,DeepSeek V4.1 Flash 53.64
  • 留出框架 EverMemOS 上 56.89 vs Opus 5 的 54.04;Mem0 的 LoCoMo 单项仍落后(59.54 vs 69.47)
  • 约 3B 激活、Apache-2.0,vLLM v0.31.0 实测可部署,OpenAI 兼容接口
  • SDK 一行 pip install hy-memory,Chat/Working/Coding 三场景自动路由
  • MemHub 支持 Linux 与 macOS(preview),不支持 Windows
阅读全文

MBZUAI IFM × Inception42 发布 Jais 3:六档开源阿拉伯语智能体模型(0.9B–375B)+ Jais Speech,512K 上下文落地 Hugging Face

阿联酋 MBZUAI 旗下 Institute of Foundation Models(IFM)与 Inception42 于 2026-10-15 正式发布 Jais 3:在开源底座 K2 Horizon 上做的首个语言适配,提供六档开源权重(0.9B 稠密至 375B-A23B 稀疏 MoE,每 token 激活约 23B)与阿拉伯语 ASR 模型 Jais Speech。全系列共享训练配方与智能体能力,上下文最长 512K(0.9B 为 128K),Apache-2.0,权重与分阶段 checkpoint 已上 Hugging Face,vLLM 宣布 Day-0 支持。

MBZUAI IFM × Inception42 发布 Jais 3:六档开源阿拉伯语智能体模型(0.9B–375B)+ Jais Speech,512K 上下文落地 Hugging Face

核心要点速览

  • 规模:六档 0.9B / 3.7B / 7B / 32B 稠密 + 36B-A4B(MoE+MoVA,约 4B 激活)+ 375B-A23B(约 23B 激活);旗舰需约 8×H200 BF16 节点(模型卡)
  • 官方自测阿拉伯语均分:375B 开源对照最高 84.0(Qwen3.5-397B 82.0);7B 79.4,相对同尺寸 K2 Horizon 基座 56.4→79.6(技术博客)
  • 智能体:3.7B/7B 在同尺寸对照中领先约 20 分;375B agentic average 60.2,SWE-Bench Verified 70.2、Terminal-Bench 2.1 73.8(官方同 harness 复测)
  • 语音:Jais Speech 在六套公开 ASR 测试宏平均 WER/CER 22.85/8.37,低于 Audar、Cohere Transcribe Arabic、omniASR 等对照(Jais 页)
  • 开箱:Apache-2.0;HF 集合 IFM/jais-3;vLLM≥0.30 / SGLang≥0.5.20 参考配方;推理 parser k2_horizon;配对 github.com/ifm-ai/JaisVoice
阅读全文
关联模型 / 智能体 / 厂商:

昆仑万维 Skywork 开源 Matrix-Game 4.0:游戏引擎管状态、5B 因果视频模型实时渲染,单卡可玩的「神经渲染」游戏

Skywork AI(昆仑万维)于 2026-10-15 开源 Matrix-Game 4.0:把世界状态、物理与规则交给可执行游戏引擎,引擎只输出低模 RGB 代理画面,再由基于 Wan2.2-Fun-5B-Control 的 5B 因果视频模型以 1–2 步去噪流式重渲染成成品画面。GitHub 已放出推理代码、浏览器 WebRTC Demo 与游戏源码(Apache-2.0),Hugging Face 提供城堡、古埃及、城市赛车三套场景权重。官方宣称 RTX 5090 上 480p/60 FPS、端到端 112ms;仓库自测 A100 上约 38–39 FPS。训练代码与数据未开源。

核心要点速览

  • 规模:每个场景 checkpoint 5,001,016,512 个 BF16 参数,底座 alibaba-pai/Wan2.2-Fun-5B-Control,输出 480×864(HF 模型卡)
  • 官方宣称(RTX 5090):480p 60 FPS、端到端响应 112ms、生成峰值 83.4 FPS;仓库 A100-80GB 实测:城堡/古埃及固定 prompt 约 38–39 FPS,赛车动态 prompt 约 28.9 FPS(v4 README)
  • 推理配置:realtime 预设为 TAEHV 编解码 + 单步去噪 + CUDA Graph;quality 预设为 Wan VAE + 两步去噪;注意力缓存 21 个 latent(含 sink),每块 4 帧
  • 许可:代码与场景权重 Apache-2.0;训练代码与训练数据未包含,权重需配套推理源码,非 Diffusers 即插即用
  • 定位:「Harness」范式——引擎维护世界状态与规则,Coding Agent 把自然语言改写成新规则与 prompt,视频模型只负责渲染
阅读全文
关联模型 / 智能体 / 厂商:
⚡ matrix-game-4.0⚡ wan2.2-fun-5b-control🌐 skywork🌐 kunlun-tech🌐 huggingface

谷歌云 AI 提出 Harness²:递归执行框架自进化机制,开放世界任务跑分狂飙 11.8%

智能体的工程表现不仅取决于基座大模型,更深度依赖其执行外壳(Execution Harness)。传统递归自我提升(RSI)在开放世界下面临缺乏真实验证器与场景泛化差的两大死穴。谷歌云 AI 团队提出 Harness² 框架,通过两级递归机制解耦进化:任务级递归通过对比式的“提议-探针-组合”(Propose-Probe-Compose)在零 Ground-Truth 验证器下引导外壳迭代;架构级递归提取经验更新持续进化外壳。在 GLM-5 与 Gemini 3.5 Flash 上测试,LAB 提升 11.8%,WorkBuddy-Bench 飙升 11.5 分。代码已在 GitHub 以 Apache-2.0 开源(google-research/harness2),支持 OpenCode 与 Codex 执行器及 JobBench、LAB、WorkBuddy-Bench。

谷歌云 AI 提出 Harness²:递归执行框架自进化机制,开放世界任务跑分狂飙 11.8%

核心要点速览

  • 解耦智能体双层进化:首次将智能体外壳(Harness)自进化拆解为任务级递归(Task-level)与外壳级递归(Harnessing-level),解决开放环境无真值检验难题
  • Propose-Probe-Compose 机制:无需外部 Ground-Truth 验证器即可通过对比式探针检验引导 Harness 代码与工具集动态修复
  • 跨模型显著泛化:在 GLM-5 与 Gemini 3.5 Flash 上实测,LAB 提高 11.8 个百分点,WorkBuddy-Bench 提高 11.5 分,JobBench 提升 4.5 分
阅读全文

Physical Intelligence 开放 Pi API 测试版:上传机器人数据即可托管微调 π 系列模型并云端推理

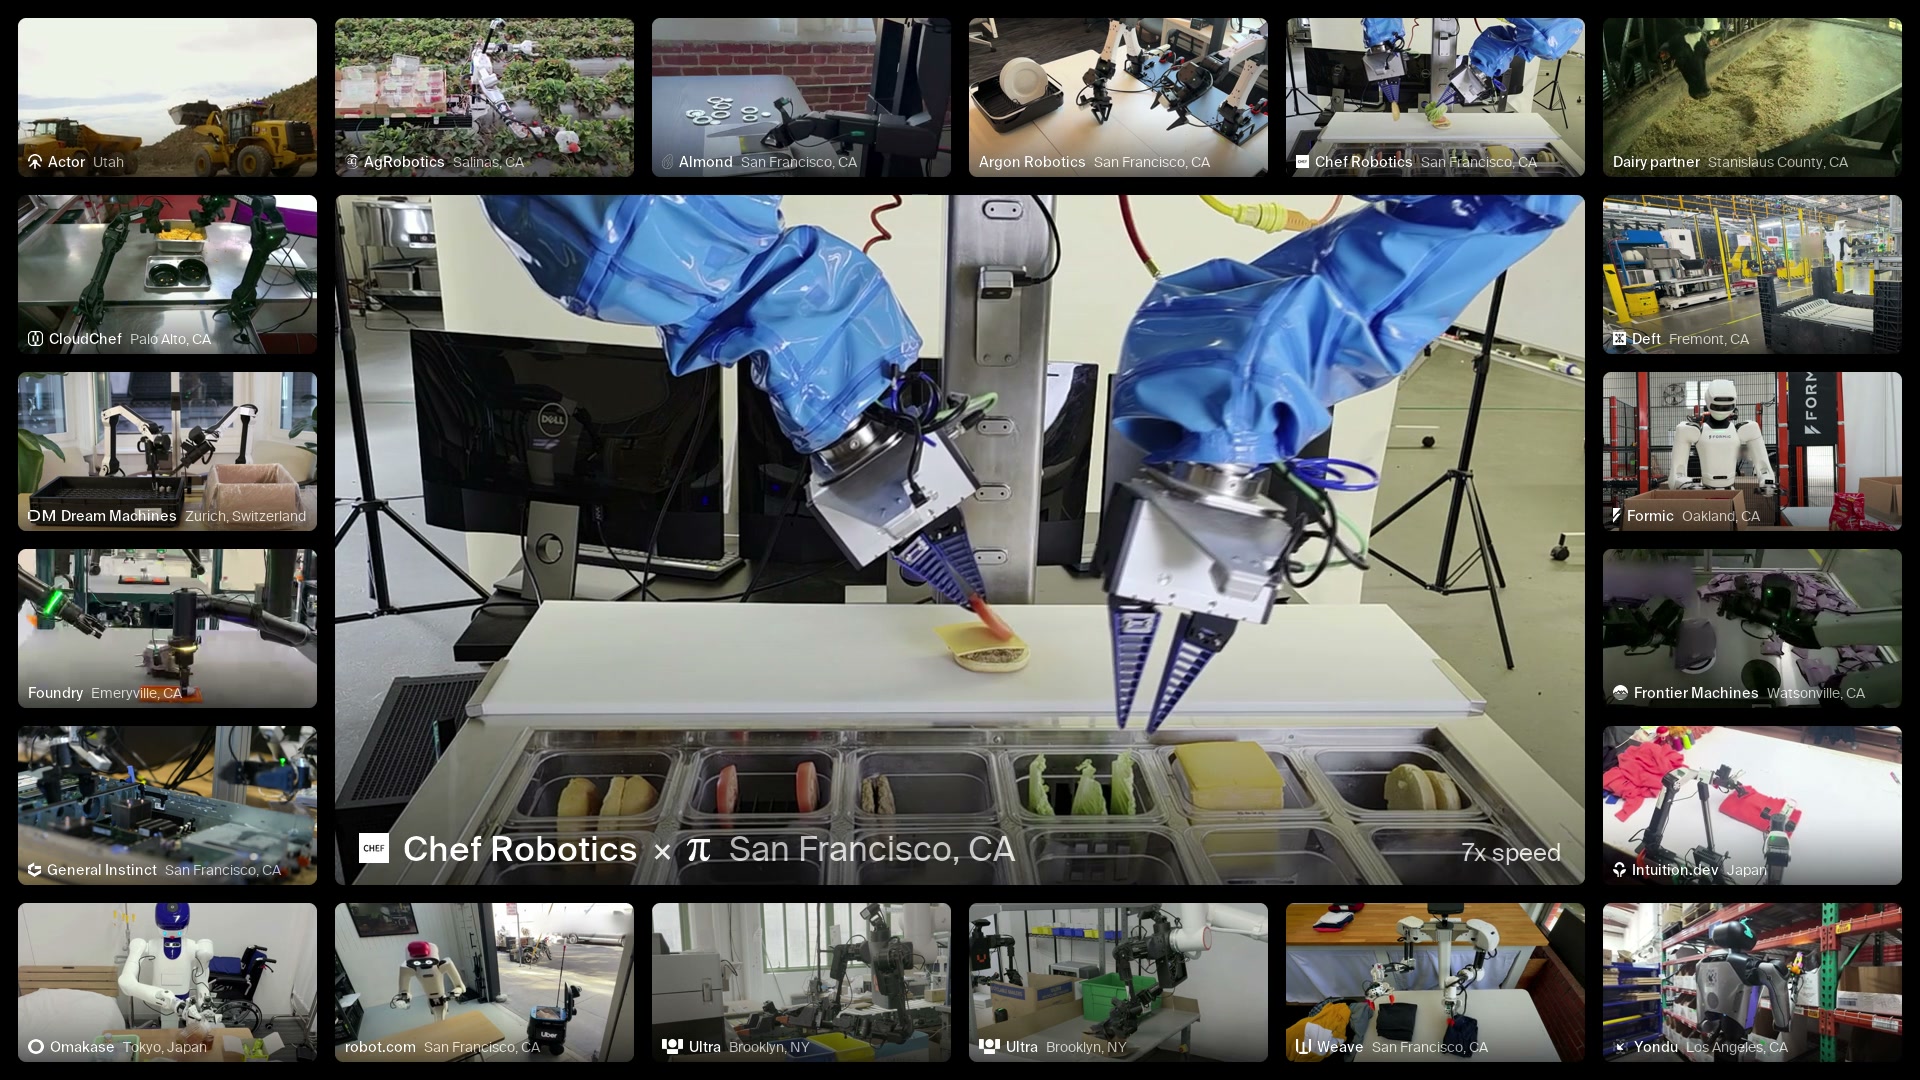
Physical Intelligence 10 月 13 日开放 Pi API 测试版:开发者上传机器人示教数据,在 Pi 托管的算力上微调其最新机器人基础模型,再通过托管网关为自家机器人提供云端推理。官方展示了从无人驾驶装载机、草莓采摘到服务器装配等合作案例,早期客户 Almond 仅迭代 4 天就让双臂机器人完成去毛刺任务。测试版需申请,定价与 API 参数尚未公开;想自托管可继续用 Apache-2.0 的 openpi(π0/π0.5 基座)。

Physical Intelligence 开放 Pi API 测试版:上传机器人数据即可托管微调 π 系列模型并云端推理

核心要点速览

  • 工作流三步:上传数据 → 在 Pi 托管算力上微调 π 模型 → 经托管网关云端推理,并用评测数据决定下一轮采集(官方博客)
  • 早期客户 Almond 用 API 迭代 4 天,得到可让 Axol 双臂机器人为自身零件去毛刺的策略
  • 官方列出约 20 家合作/早期接入方(Actor、Chef Robotics、Formic、Ultra 等),部署覆盖日本、瑞士与美国,多数案例走云端推理,官方承认部分场景存在网络连接问题
  • 自托管替代:openpi(Apache-2.0,约 1.4 万星)提供在 10k+ 小时机器人数据上预训练的 π0 / π0-FAST / π0.5 基座;推理需 >8GB 显存、LoRA 微调 >22.5GB、全量微调 >70GB
  • 测试版需申请,API 定价、端点与参数均未公开
阅读全文
关联模型 / 智能体 / 厂商:
⚡ π0⚡ π0-FAST⚡ π0.5🌐 Physical Intelligence

LightOn 开源 ColGrep-Agent-2B:本地 2B 代码检索 Agent 接入 Claude Code,API token 降约 34%、成本约 40%

LightOn AI 于 2026-10-12 发布 ColGrep-Agent-2B(基于 MiniCPM5-2B,Apache-2.0):本地 2B 代码定位 Agent,用 ColGrep 多向量语义检索 + 只读终端在仓库内搜索,再把文件路径与行范围交还给前沿编程 Agent。在 13 个未见仓、52 道代码搜索题、624 次会话中,接入 Claude Code(Sonnet 5.5)相对纯 grep 平均少用约 34.3% API token、缓存感知成本约降 40%;准确率 80.8% vs grep 83.3%(差异无统计显著)。SWE-bench Lite 行级 F1 达 19.92,高于同 harness 下多款 10×+ 参数量模型。提供 brew/cargo/GGUF 一键安装与 Claude Code / Codex / OpenCode 钩子。

LightOn 开源 ColGrep-Agent-2B:本地 2B 代码检索 Agent 接入 Claude Code,API token 降约 34%、成本约 40%

核心要点速览

  • 官方:HF Blog — ColGrep-Agent(2026-10-12);模型 lightonai/colgrep-agent-2B;仓库 lightonai/next-plaid
  • 实测(厂商口径,Claude Code + Sonnet 5.5,52 题×3 跑):相对 grep,token −34.3%(95% CI 28–40),缓存感知成本约 −40%(7.3¢→4.4¢/题);正确率 80.8% vs 83.3%
  • 定位评测:SWE-bench Lite 文件 F1 76.18 / 行 F1 19.92;Multi-SWE-bench Flash 文件 F1 62.57 / 行 F1 15.93(五种子均值)
  • 训练:MiniCPM5-2B → SFT(Qwen3.5-27B 教师轨迹)→ GRPO 500 step;工具仅 colgrep / 只读 terminal / finish;10 轮预算
  • 开箱:brew install lightonai/tap/colgrep && colgrep --install-agent;默认 GGUF ~2.5GB;colgrep --install-claude-code|codex|opencode
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

OpenBMB 开源 MiniCPM-V 4.7:35B-A3B 首个 MoE 端侧多模态模型,iPhone 17 Pro Max 实测 13+ token/s

2026-10-12 OpenBMB(面壁智能)发布 MiniCPM-V 4.7 开源多模态系列,含 35B-A3B(系列首个 MoE)与 1B 两款,Apache-2.0。配套的 Lookahead Expert Scheduling(LES)跨层预取专家,叠加分层混合精度量化与 DSpark 投机采样,官方在 iPad Pro M4(16GB)上把专家从 SSD 加载的解码速度从 2.97 提到 17.39 token/s(5.86 倍)。权重已上架 Hugging Face / ModelScope / Ollama,支持 vLLM、SGLang、llama.cpp 与 iOS / Android / 鸿蒙端侧部署。

OpenBMB 开源 MiniCPM-V 4.7:35B-A3B 首个 MoE 端侧多模态模型,iPhone 17 Pro Max 实测 13+ token/s

核心要点速览

  • 两款开源权重(Apache-2.0):35B-A3B(系列首个 MoE,语言底座 Qwen3.6)与 1B,另附 FP8 / AWQ / GPTQ / int4 / GGUF 与 DSpark 草稿模型(Hugging Face)
  • LES 端侧解码(官方口径,iPad Pro M4 16GB):基线 2.97 → LES 9.81 → +分层量化 14.92 → +DSpark 17.39 token/s,累计 5.86×(LES 文档)
  • iPhone 17 Pro Max 上 35B-A3B 达 13+ token/s;视觉 token 支持 4x / 16x 混合压缩,按任务切换细节与成本
  • 厂商评测(Instruct,4x):MMBench 91.72、OCRBench 91.20、OmniDocBench v1.6 94.24、MMMU 80.22,对比 Qwen3.6-35B-A3B 分别为 86.76 / 86.00 / 80.17 / 77.44;SimpleVQA、ScreenSpot 等项仍落后
  • Day-0 芯片支持 Rockchip、后摩、Intel、AMD、Arm;推理框架覆盖 vLLM、SGLang、llama.cpp、Ollama,微调支持 SWIFT / LLaMA-Factory
阅读全文
关联模型 / 智能体 / 厂商:
⚡ MiniCPM-V 4.7 35B-A3B⚡ MiniCPM-V 4.7 1B⚡ Qwen3.6-35B-A3B🌐 OpenBMB🌐 面壁智能

vLLM Semantic Router 开源 Decision 3.0:0.6B–27B 六款多模态决策模型,官方测评 Jev Decision Index 第一

vLLM Semantic Router(vllm-sr)团队于 10 月 11 日在 Hugging Face 以 Apache-2.0 开源 Decision 3.0 系列(d3、d3-flash、d3-mini、d3-nano、d3-lite、d3-edge),基于 Qwen3.5/3.8,支持文本、图片和视频输入,一次调用直接输出选择题、是/否、打分三类问题的概率而不生成文本。官方口径:27B 旗舰 d3 在 Jev Decision Index 0.3.1 得 64.7,领先 Perplexity Decider v1.1(62.8)和上一代 Decision 2.0(55.9);单张 MI325X 上文本请求中位延迟 55ms。vLLM 官方账号转发祝贺。

vLLM Semantic Router 开源 Decision 3.0:0.6B–27B 六款多模态决策模型,官方测评 Jev Decision Index 第一

核心要点速览

  • 六档尺寸:d3-edge 0.59B、d3-lite 0.85B、d3-nano 2.2B、d3-mini 4.5B、d3-flash 8.4B、d3 26.1B,全部 Apache-2.0(HF 合集)
  • 官方口径 Jev Decision Index 0.3.1:d3 64.7,Perplexity Decider v1.1 62.8,Jev 60.1,Decision 2.0 55.9
  • 视觉榜(Vision Index 0.3.1):d3 71.6,Perplexity Decider v1.1 70.6,JEV-27B-VL 69.6
  • 单张 AMD MI325X、单并发中位延迟:d3 文本 55ms / 图片 273ms / 10 秒视频 553ms;d3-edge 文本仅 6.7ms
  • 不生成文本,直接给每个选项打概率;同一输入可一次问多道 Choice / Yes-No / Score 题
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Decision 3.0⚡ d3⚡ D3 Flash⚡ D3 Edge⚡ Qwen3.5⚡ Qwen3.8🌐 vLLM🌐 vLLM Semantic Router
P
Perplexityperplexity-ai·
👀124
🔥84

Perplexity 开源 pplx-decider-v1.1-27b 决策模型:Decision Index 从 56.4 提到 61.56,反超 Jev 3.6 分

Perplexity 在 Hugging Face 发布 Apache-2.0 的 pplx-decider-v1.1-27b,基于 Qwen3.8-27B,不生成文本而是直接输出带概率的分类/路由/打分答案;Decision Index 总分 61.56(v1 为 56.4,Jev 为 57.9),并可通过 Perplexity Decisions API 调用。

Perplexity 开源 pplx-decider-v1.1-27b 决策模型:Decision Index 从 56.4 提到 61.56,反超 Jev 3.6 分

核心要点速览

  • Decision Index 总分 61.56,比 v1(56.4)高 5.16 分,比 Jev(57.9)高 3.66 分,同一 Qwen3.8-27B 底座
  • 分项:Language 69.45、Retrieval 61.26、Tools 78.88、Knowledge 48.18(仍低于 Jev 的 51.4)
  • 提升主要来自取消全注意力层的因果掩码(noncausal)以及加入 tasksource 等更多训练数据
  • 输出头是 [255, 5120] 的 BF16 readout,不是全词表 lm_head;权重约 49 GiB,需 CUDA GPU
  • 托管调用:POST /v1/decisions,支持 noul / choice / score 三类问题,一次请求可问多个问题(文档)
阅读全文
关联模型 / 智能体 / 厂商:
⚡ pplx-decider-v1.1-27b⚡ Pplx Decider V1 27b⚡ Qwen3.8-27B⚡ Jev🌐 Perplexity

AI 自己设计的开源 AI 芯片 openTPU 走红:RTL/ISA/编译器全栈开源,Kintex-7 FPGA 卡跑 Qwen3.5、Gemma 4 与 35B MoE,小模型解码 85.8 tok/s

开源项目 FeSens/openTPU(Apache-2.0)在 Hacker News 登上首页(250+ 分、300+ 评论):作者沿用此前用 AI 设计 RISC-V 核的 auto-arch-tournament 方法,让 AI 代理迭代设计一颗推理加速器,单仓库包含 SystemVerilog RTL、ISA、逐位精确模拟器、内核语言编译器与 Profiler。在 Kintex-7 xc7k480t PCIe 卡上以真实权重运行 Qwen3、Qwen3.5、Gemma 4、Phi-4-mini 等模型,输出与模拟器逐 token 一致;LFM2.5-230M 4-bit 解码 85.8 tok/s,Qwen3.5-35B-A3B 借主机专家卸载跑到 3.95 tok/s。

AI 自己设计的开源 AI 芯片 openTPU 走红:RTL/ISA/编译器全栈开源,Kintex-7 FPGA 卡跑 Qwen3.5、Gemma 4 与 35B MoE,小模型解码 85.8 tok/s

核心要点速览

  • 全栈 1 仓库:SystemVerilog RTL + 8×32-bit 指令 ISA + Python 逐位精确模拟器 + @ol.jit 内核编译器 + Lens Profiler,Apache-2.0(GitHub)
  • 实测解码(设备侧,4-bit/int8 头):LFM2.5-230M 85.8 tok/s、Qwen3-0.6B 31.3 tok/s、Qwen3.5-2B 12.09 tok/s、Gemma 4 E2B 12.14 tok/s(2026-09-29 至 10-01 实测)
  • 带宽利用:DDR3-1066 峰值 17.1 GB/s,解码时达 82–94%;设计时钟 133.33 MHz,四列脉动阵列
  • MoE 卸载:Qwen3.5-35B-A3B 3.95 tok/s(每 token 经 PCIe 拉取 153 MB 专家权重,命中率 62%),LFM2.5-8B-A1B 10.6 tok/s(offload 文档)
  • 4-bit 量化(FP4 + 两级块缩放,4.25 bit/权重)比 int8 解码快 40–45%,困惑度代价逐模型公开
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Qwen3.5⚡ Gemma 4⚡ LFM2.5⚡ Phi-4 Mini

OpenAI 开源内部前沿模型的数学成果库:722 篇手稿、372 个结果族上架 GitHub,自称涉及准黎曼假设、CM 阿贝尔簇 Hodge 猜想等难题

OpenAI 于 2026-10-06 发布 Sharing AI progress in mathematics,把一个尚未发布的内部前沿模型产出的数学结果整体公开到 openai/math(Apache-2.0):722 篇手稿归入 372 个结果族,来自约 4,000 道开放问题的评测,平均每个结果耗费约 3 小时 ChatGPT Pro 思考算力;附 10 份推理摘要与部分 Lean 形式化证明。OpenAI 承认未形式化结果可能存在问题,且尚未经同行评审。

OpenAI 开源内部前沿模型的数学成果库:722 篇手稿、372 个结果族上架 GitHub,自称涉及准黎曼假设、CM 阿贝尔簇 Hodge 猜想等难题

核心要点速览

  • 规模:722 篇手稿 / 372 个结果族,从约 4,000 道开放问题的评测中筛出
  • 算力:平均每个结果约等于 3 小时 ChatGPT Pro 思考算力(同一内部未发布模型、固定流程)
  • 可核验:372 个结果族中 235 个附 Lean 链接,formalization.yaml 列出 162 篇主结果已形式化的论文,可用 Comparator 校验
  • 透明度:公开 10 份推理摘要(π 的无理性指数、Mahler 猜想、自由群因子同构等),并按 IAS 数学与 AI 顾问组建议设修订/引用协议
  • 风险提示:OpenAI 自承部分未形式化结果可能有误,全部尚未经同行评审;生成模型暂未开放
阅读全文
关联模型 / 智能体 / 厂商:
⚡ OpenAI internal frontier model🌐 OpenAI