AI 编程实时动态与要闻

DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

DeepSeek 官方正式开源其生产级高性能推理引擎 DeepInfer(基于 Apache 2.0 协议发布)。DeepInfer 汲取了 vLLM、SGLang 与 TensorRT-LLM 架构精华,专为大规模部署 DeepSeek-V4.1-Flash 设计。引擎支持 NVIDIA SM100 架构与华为昇腾 Ascend 950 NPU,原生集成 FlashMLA、DeepGEMM、DeepEP 与 TileKernels。引入 DSpark 置信度投机采样(默认 5 个 Draft Token)、SWA 有界重放(140 Token 窗口)与 MoE 专家并行动态负载均衡。同时开源生产级分词与编解码组件 deepseek-recipe,构建从模型、算子到推理服务的全栈开源生态。
DeepSeek 正式开源 DeepInfer 推理引擎:全面支撑 V4.1-Flash 大规模生产服务,兼顾 NVIDIA SM100 与华为昇腾 950

核心要点速览

  • DeepSeek 官方正式开源 DeepInfer 推理引擎(Apache 2.0),完整公开支撑 DeepSeek-V4.1-Flash 线上高吞吐与低延迟调度的底层代码
  • 跨异构硬件深度调优,同时全面适配 NVIDIA SM100 GPU 与华为昇腾 Ascend 950 NPU,提供硬件级确定性输出保证
  • 深度融合 FlashMLA、DeepGEMM、DeepEP 与 TileKernels 原生算子,并搭载基于 DSpark 的 5-Token 置信度投机解码与 140-Token 滑动窗口重放
  • 同步开源生产级 token 编解码套件 deepseek-recipe,彻底消除开源社区本地部署与官方 API 之间的对齐鸿沟
阅读全文

DeepSeek 开源生产推理框架 DeepInfer:支撑 V4.1-Flash 线上服务,含投机解码、批次不变推理与结构化输出,同步开源 deepseek-recipe

DeepSeek 于 10 月 20 日(UTC)开源内部推理框架 DeepInfer(Apache 2.0),即支撑 DeepSeek-V4.1-Flash 大规模线上服务的推理栈。本次开源版本提供离线推理,支持 Attention DP/CP、MoE EP+EPLB 并行、DSpark 投机解码、SWA bounded replay、批次不变推理、确定性采样和结构化输出,硬件为 NVIDIA SM100 与华为昇腾 950。KV cache 系统、PD 分离和负载均衡未包含在内。同时开源的 deepseek-recipe(MIT)负责把 Chat Completions、Messages、Responses 等格式请求统一转换并编码,对齐官方 API 行为。

DeepSeek 开源生产推理框架 DeepInfer:支撑 V4.1-Flash 线上服务,含投机解码、批次不变推理与结构化输出,同步开源 deepseek-recipe

核心要点速览

  • DeepInfer 以 Apache 2.0 开源,官方称即支撑 DeepSeek-V4.1-Flash 线上服务的推理框架,目前只支持这一个模型
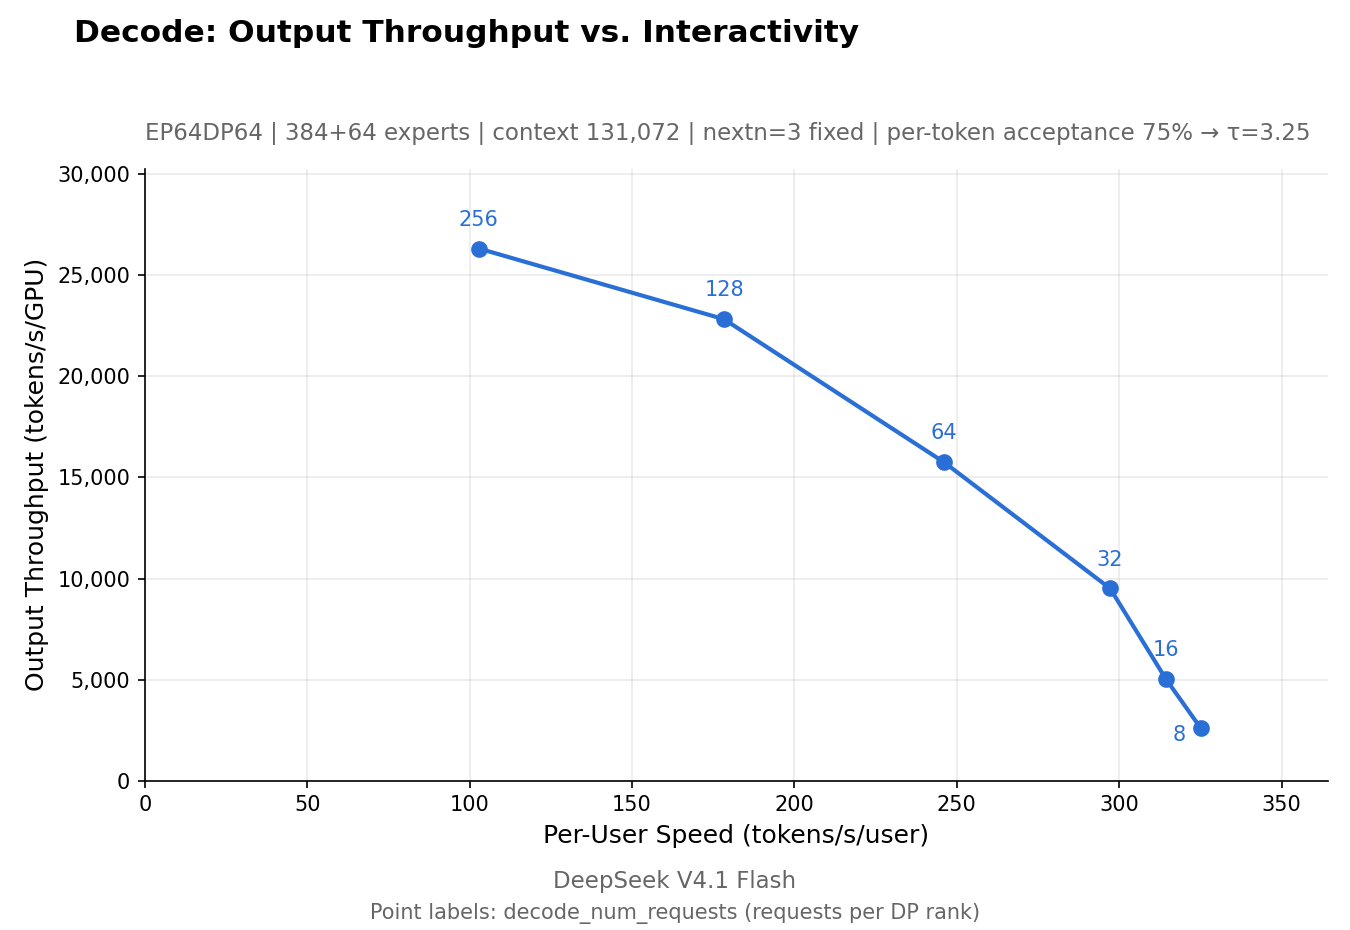
  • 硬件仅支持 NVIDIA SM100(Blackwell)GPU 和华为昇腾 950 NPU;官方性能曲线测于 4 卡 prefill、64 卡 decode
  • 开源版缺 KV cache 系统、VE/Prefill/Decode 分离和多副本负载均衡三块,离完整线上服务还有距离
  • 官方给出的 V4.1 参考成绩(Pass@1,厂商口径):AIME 2026 99.9%、GPQA Diamond 93.4%、HLE-Full 42.6%,用于校验部署是否配置正确
  • 同步开源 deepseek-recipe(MIT,Rust+Python 绑定),统一处理 Chat Completions/Messages/Responses 请求转换与 token 编解码
阅读全文
关联模型 / 智能体 / 厂商:
⚡ DeepSeek-V4.1-Flash-1017🌐 DeepSeek🌐 NVIDIA🌐 Huawei

LMDeploy 0.18.0:Qwen3.5 dflash、SM90 量化 GEMM、Ascend GLM-5.2;TurboMind W4A16 与 piecewise CUDA Graph

上海 AI Lab 开源推理栈 LMDeploy 于 2026-09-28 发布 v0.18.0:支持输出 input logprobs、扩展 SM90 量化 GEMM 并统一 TurboMind linear 执行路径;Ascend 侧支持 GLM-5.2;为 Qwen3.5 接入 dflash;MoE 将 shared expert 并入 FFN 并在节点内切分 dense FFN。PyTorch 路径原型化 TurboMind W4A16(AWQ)、piecewise CUDA Graph prefill、XTuner TileLang sparse MLA,并支持 checkpoint-engine 权重热更新与 request-only KV cache 用量指标。

LMDeploy 0.18.0:Qwen3.5 dflash、SM90 量化 GEMM、Ascend GLM-5.2;TurboMind W4A16 与 piecewise CUDA Graph

核心要点速览

  • 发版:v0.18.0(2026-09-28);PyPI lmdeploy==0.18.0
  • 模型/硬件:Qwen3.5 dflash;Ascend GLM-5.2;SM90 量化 GEMM 扩展(#4943)
  • 推理内核:TurboMind W4A16 AWQ 原型(#4897);piecewise CUDA Graph prefill(#4895);TileLang sparse MLA(#4904)
  • 运维:checkpoint-engine 权重更新(#4913);request-only cache 用量指标(#4940);input logprobs(#4793)
  • 安装:pip install -U "lmdeploy>=0.18.0";文档见 lmdeploy.readthedocs.io
阅读全文
关联模型 / 智能体 / 厂商:

中国电信开源 Xing4.0-29B-A4B:29B/4B MoE,SWE-bench Verified 75.0,Ascend 全链路训练

@mylifcc 转发并解读中国电信人工智能科技开源的 Xing4.0-29B-A4B(原 TeleChat 系列,HF:XingChen-AGI/Xing4.0-29B-A4B,Apache-2.0):29B 总参 / 每 token 激活 4B、原生 256K 上下文;官方卡宣称 SWE-bench Verified 75.0、Terminal-Bench 2.1 57.50,并称可对接 OpenCode / Claude Code 等智能体框架,权重在 Ascend NPU + MindSpore 全链路训练。

中国电信开源 Xing4.0-29B-A4B:29B/4B MoE,SWE-bench Verified 75.0,Ascend 全链路训练

核心要点速览

  • HF XingChen-AGI/Xing4.0-29B-A4B(Apache-2.0):29B/4B MoE,256K 上下文。
  • 官方跑分:SWE-bench Verified 75.0;Terminal-Bench 2.1 57.50。
  • 称 Ascend+MindSpore 全链路训练,并适配 OpenCode / Claude Code 等智能体工作流。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

DeepSeek 规模上线国产昇腾集群,552B 不对称 MoE 架构推理吞吐创新高

深度求索(DeepSeek)披露其下一代 AI 数据中心已大规模部署国产华为昇腾智算集群。配合最新上线的 552B 参数不对称 MoE 模型 DeepSeek-V4.1-Flash,系统在吞吐效率与显存优化上实现突破,单卡推理吞吐刷新历史记录,全面打造硬件与算法全栈自主可控的基座闭环。

核心要点速览

  • 规模化导入华为昇腾 AI 算力集群,构建全流程自主可控的国产大模型算力底座
  • 552B 参数不对称 MoE 架构兼具极高推理吞吐量与前沿视觉代码理解能力
  • 进一步巩固 DeepSeek 在全球开源社区的极致性价比与高吞吐工程标杆地位
阅读全文
关联模型 / 智能体 / 厂商: