AI 编程实时动态与要闻

开源 Agent 基础模型 Axion 1.0 发布:2 次 SFT + RL 极简配方,35B(3B 激活)复现权重 Apache 2.0 开放,数据与训练代码全公开

arXiv 论文 2611.03233(Yuqi Jia、Yunjie Tian 等 7 位作者)发布 Axion 1.0,一个“权重之外也开源”的 Agent 基础模型:只用两段轻量 SFT 加强化学习,不做专门的 mid-training、DPO 或在线蒸馏,总共约 1.8 万条 SFT 轨迹。训练代码托管在 GitHub 的 bytedance 组织下,训练数据和 Axion 1.0-35B 复现权重(Qwen3.6-35B-A3B 底座,35B 总参 / 3B 激活,Apache 2.0)已上 Hugging Face;论文中的 122B 版本权重标注为即将发布。

开源 Agent 基础模型 Axion 1.0 发布:2 次 SFT + RL 极简配方,35B(3B 激活)复现权重 Apache 2.0 开放,数据与训练代码全公开

核心要点速览

  • 配方极简:SFT 一阶段练自包含科学推理,二阶段练工具调用和信息检索,再用 RL 打磨长程交互,共约 18,363 条 SFT 轨迹 + 484 条 RL 任务
  • 开源范围包括数据构建、生成、过滤、验证、提示词和训练代码(GitHub),不只是权重
  • 35B 复现权重成绩:HLE 52.8、SEAL-0 60.4、FrontierScience Olympiad 85.0、Research 55.0(HF 模型页)
  • 论文版 122B 在 HLE(限制网站访问)59.0、FrontierScience Research 66.7;122B 权重尚未放出
  • 跑分均为作者自报,HF 页上 Claude Opus 5 的 HLE 为 63.6,Axion 仍落后最强闭源模型
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Axion 1.0-35B⚡ Axion 1.0-122B⚡ Qwen3.6-35B-A3B🌐 ByteDance🌐 Hugging Face

X 热议:Claude Code 团队的 Addy Osmani 长文谈「认知投降」,提醒开发者在 Agent 干活时别交出批判性思考

X 简介为 Anthropic Claude Code 成员的 Addy Osmani(@addyosmani)11 月 3 日在 X 发布长文《Critical thinking when agents do the work》。他把人和 AI 的协作分成三档:认知卸载(把任务交给 AI 但自己对结果负责)、顺从(AI 输出直接变成你的输入)和「认知投降」(AI 的输出悄悄变成你的观点,你不再检查)。「认知投降」一词出自沃顿商学院的 Steven Shaw 和 Gideon Nave。他给出几条自检问题和验证习惯。发布约 3 小时内收获约 1400 赞、2400 次收藏、7 万多次浏览,并登上 X 热门。以下是作者观点,不是 Anthropic 官方公告。

核心要点速览

  • 三档光谱:认知卸载(委托但仍对结果负责,作者说他整天都这么做)、顺从(输出不再被当作假设)、认知投降(不再检查,直接当成自己的结论)。原文见 X 长文。
  • 作者的观点:模型越强,明显错误越少,输出「写得好、大体正确」,反而不再逼人看第二眼;同时跑多个 Agent,审阅的仍只有你一双眼睛。
  • 自检问题:提问前先写下自己的假设;分清是让 AI 帮你思考还是替你思考;想清楚「什么情况下它会错」并真的去测;让多个模型唱反调;能否当着维护者的面为结果下注。
  • 验证习惯:事先定义「验证通过」的标准(测试、截图、日志);绿灯只证明一个性质,要问它没证明什么;让 Claude Code 用全新上下文的子 Agent 自查,最后再问一句「我漏了什么?」。
  • 低风险的事可以完全交给 AI,代价落在别人身上的决定(要做什么、是否可以上线)要自己保留推理过程。
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:levelsio 用 Claude Code 反编译《战地 1942》试玩版,搬进浏览器还能联机,自称花了约 100 万输出 token

独立开发者 Pieter Levels(@levelsio)11 月 2 日在 X 上说,他用 Claude Code 反编译了《战地 1942》免费试玩版的引擎,移植成 C 再编译到 WebAssembly,放在 bf1942.pieter.com 上,浏览器里就能联机玩 Tobruk 地图。他称整个过程约用了 100 万输出 token,按 API 价格约 100 美元,而他本人付的是每月 100 美元的 Claude 订阅。两条主帖合计约 2200 赞、34 万次浏览,并登上 X 热门。以下为作者本人说法和社区讨论,未经独立核实。

X 热议:levelsio 用 Claude Code 反编译《战地 1942》试玩版,搬进浏览器还能联机,自称花了约 100 万输出 token

核心要点速览

  • 作者自述:用 Claude Code 反编译《战地 1942》试玩版引擎,移植到 C,再编译成 WebAssembly 在浏览器运行。
  • 线上版本 bf1942.pieter.com 可直接打开,页面标注「非商业、非官方」,支持 Tobruk 地图在线合作,无需安装。
  • 成本:作者称约 100 万输出 token,按 API 价格约 100 美元;他实际使用每月 100 美元的 Claude 订阅。
  • 作者说这次比他此前移植 Quake、DOOM 难得多;那两款游戏的引擎源码早已由 id Software 开源。
  • 热度:首帖约 1100 赞、23 万浏览,上线帖约 1100 赞、10.7 万浏览;测试者已陆续反馈 bug。
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:MIT 团队称 GPT-6 Astra 能直接读写神经网络权重,只改 Qwen3.5-0.8B 的 0.016% 权重让 MATH-500 从 7.9% 升到 48.1%

MIT CSAIL 博士生 Rikiya Takehi 11 月 2 日在 X 上发布「Weight-Space Programming(权重空间编程)」研究:作者团队(Takehi、Jayden Teoh、Alex Zhang、Omar Khattab)让 GPT-6 Astra 不用梯度、不做训练,直接阅读和修改神经网络权重。博客称 Astra 只改了 Qwen3.5-0.8B 的 13.1 万个权重(0.016%),修复了思考死循环,MATH-500 从 7.9% 升到 48.1%。原帖约 2.4 万赞、177 万浏览,Ethan Mollick 转评「等复现,但这很重要」。以上均为作者自报结果,尚未独立复现。

X 热议:MIT 团队称 GPT-6 Astra 能直接读写神经网络权重,只改 Qwen3.5-0.8B 的 0.016% 权重让 MATH-500 从 7.9% 升到 48.1%

核心要点速览

  • 原帖(2026-11-02 17:51 UTC)抓取时约 24,320 赞、2,697 转发、2,284 引用、177 万浏览、1.5 万收藏;沃顿商学院教授 Ethan Mollick 转评「等待复现,但这很重要」,约 880 赞。
  • 实验 8(作者口径):50 次前向预算下,Astra 只改 131,072 个权重(0.016%),Qwen3.5-0.8B 的 MATH-500 从 7.9% 升到 48.1%,IFEval 从 21.0% 升到 62.3%,触及 token 上限的回答从 93.0% 降到 33.1%。
  • 实验 5(作者口径):不给数据、梯度和工具,Astra 一次性写出的 MinAtar 策略网络在 Breakout 得 517.4 分,PPO 训练 1 亿步为 15.8、5 亿步为 25.3;Seaquest 为 53.1,低于 5 亿步 PPO 的 88.9。
  • 作者自己承认的边界:换成很少死循环的 Gemma 3 270M,Astra 的编辑没让 MATH-500 提升超过约 1 个点;作者结论是改权重能「移除遮住能力的障碍」,但不能凭空加能力。
  • 全部实验日志已公开在 GitHub 仓库 RikiyaT/lm_understand-logs,目前只有博客,没有同行评审论文,也没有第三方复现。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

LeCun 与 Balestriero 新论文把「柏拉图表征假说」证明为定理:1.09 亿参数文本 JEPA 与视觉模型的对齐度超过 72B 大模型

Randall Balestriero 与 Yann LeCun 10 月 29 日在 arXiv 发布论文《Proving and Improving the Platonic Representation Hypothesis with JEPAs》(2610.39302),署名单位为 Brown University、NYU 和 AMI Labs。论文证明:只要正样本对是同一场景的两次观测(「好视角」),分别在不同模态上训练的 JEPA 会学到只差一个旋转的相同表征;而 next-token prediction 相当于「坏视角」的 JEPA,所以语言模型只能靠堆规模才与视觉对齐。作者称,好视角达到同等对齐只需 next-token 的 1/42 训练样本,109M 文本 JEPA 在 DINOv2 对齐上得 0.184,高于 Qwen2.5-72B 的 0.154(论文作者口径)。代码与在线 Demo 已开放;Balestriero 的发布帖约 1,054 赞、7.2 万浏览。

LeCun 与 Balestriero 新论文把「柏拉图表征假说」证明为定理:1.09 亿参数文本 JEPA 与视觉模型的对齐度超过 72B 大模型

核心要点速览

  • 论文:arXiv 2610.39302,2026-10-29 提交,作者 Randall Balestriero、Yann LeCun(Brown University / NYU / AMI Labs)
  • 在 PRH 原有基准上,109M 文本 JEPA 与 DINOv2 的对齐分为 0.184,Qwen2.5-72B 为 0.154、Llama-3-70B 为 0.151;与 CLIP 图像编码器对齐为 0.23,此前最好为 0.21(作者口径)
  • 好视角只需 next-token prediction 1/42 的训练样本即可达到相同对齐;作者预先登记对齐缩放律的预测,再训练 85 个新 run,预测误差与换随机种子相当
  • 只用一个旋转把独立训练的编码器拼成图像描述器,COCO 上 CIDEr 0.838;在无配对基准上 ImageNet-100 top-5 为 64%,此前 8B 以内语言模型最高 56%
  • 代码 galilai-group/prh-proof 与 在线 Demo 已开放;Balestriero 发布帖 约 1,054 赞、180 转发
阅读全文
关联模型 / 智能体 / 厂商:

Google DeepMind 用 Gemini 做的 PlanAssist 扩到英国 15 个地方政府:试点中规划审查耗时最多降 58%

Google DeepMind 于 10 月 31 日宣布,与英国政府、Google Cloud 和 Faculty 共同开发的规划审查工具 PlanAssist(基于 Gemini)将新增开放给 12 个英格兰地方规划机构,参与总数达到 15 个,进入为期 12 个月的 Beta 阶段并处理真实申请。官方称,在 Barnet、Camden、Dorset 三地的早期试点中,规划官员花在住宅类申请评估上的平均时间下降 58%,超过 70% 的 AI 草拟报告无需修改即获通过;最终决定仍由规划官员作出。

Google DeepMind 用 Gemini 做的 PlanAssist 扩到英国 15 个地方政府:试点中规划审查耗时最多降 58%

核心要点速览

  • 规模:从 3 个试点地方政府扩到 15 个,新增 12 个分三批接入,Beta 期 12 个月(DeepMind 博客)
  • 效率:试点中住宅类申请的官员评估时间平均下降 58%(官方/厂商口径,DeepMind 在 X 上写作「最多 58%」)
  • 质量:超过 70% 的 AI 草拟报告被官员直接批准、无需修改(官方口径)
  • 英国政府称,配合新规,住宅类常规申请处理时间可从 8 周减半到 4 周;计划 2027 年向英格兰所有地方政府开放(GOV.UK)
阅读全文
关联模型 / 智能体 / 厂商:
g
guregodevo (Memdoor author)github.com·
👀24
🔥81

Memdoor 复现 GVS5H:5 个 Qwen3.8-27B 组队在 LiveCodeBench Hard 前 10 题均分 9.8/10,高于 Fable 5 单次调用的 8.0

开源编码 Agent 工具 Memdoor(GitHub guregodevo/memdoor,Apache 2.0)10 月 31 日公布 team-solve 工作流:用 GVS5H 论文作者的原版提示词和循环,让 5 个 Qwen3.8-27B 实例分别担任规划、两路构思、求解和管理,只通过磁盘文件沟通,由脚本跑测试判定成败。在 GVS5H 列表的前 10 道 LiveCodeBench Hard 题上各跑 5 轮,平均 9.8/10,作者原版 harness 为 9.6,Fable 5 单次调用为 8.0;50 次运行 49 次解出,总花费 35.79 美元,全部请求和回复都已公开。该帖在 Hacker News 约 200 分。这是社区复现,仅 10 题,作者自己也提示不能排除训练数据污染。

核心要点速览

  • 成绩:5 轮平均 9.8/10(逐轮 10、10、10、10、9),GVS5H 作者原版 harness 9.6,Fable 5 单次调用 8.0(team-solve README,项目方口径)
  • 成本:50 次运行 49 次解出,共 35.79 美元、1,530 万输出 token;单次中位耗时约 40 分钟模型时间、0.39 美元,最长 4 小时
  • 方法:规划、两路构思、求解、管理 5 个角色加修复 worker,各自从全新上下文开始,只经磁盘文件交流,测试由 shell 脚本判定,不让模型自评
  • 局限:只测了 10 题而非论文的 100 题;题目来自 2025 年 3–4 月的比赛,可能已进训练数据;Fable 5 的分数取自 GVS5H 作者的结果文件,没有在这个 harness 里重跑
  • 热度:HN 帖子约 200 分(截至 11 月 1 日 16:10 SGT);GVS5H 原论文为 arXiv 2608.26480,10 月 25 日曾登 HN 第一
阅读全文

OpenCode 2.2.3 内置 Claude Agent 提供方:用自己的 Claude Code 登录(含订阅)在 OpenCode 里跑 Claude 模型

开源编程 agent OpenCode 于 10 月 30 日 09:55(UTC)发布 v2.2.3,新增内置的「Claude Agent」提供方:安装 Claude Code 并运行 claude auth login 后,在 /connect 里选择 Claude Agent,即可用自己的 Claude Code 登录(订阅、API key 或云账号均可)调用 Claude 模型。它通过 Anthropic 公开的 Claude Agent SDK 运行用户本机的 claude 程序,但关掉 Claude Code 自带工具,改用 OpenCode 自己的工具和权限系统。发布前几小时,OpenCode 团队成员 dax(@thdxr)在 X 上预告「如果能在 opencode 里用你的 Claude 订阅呢」,获约 2,300 赞。

核心要点速览

  • v2.2.3 于 10 月 30 日 09:55(UTC)发布,首条亮点即「在 OpenCode 中使用 Claude Code」,对应 PR #58782(发布说明)
  • 用法三步:安装 Claude Code,运行 claude auth login,在 /connect 中选择 Claude Agent;可用 OPENCODE_CLAUDE_PATH 指定 claude 路径
  • 设计文档称:只用公开 SDK,不读取 Claude Code 保存的登录信息,也不拦截或修改其请求;订阅、API key、云账号登录都能用(设计文档)
  • Claude Code 自带工具、CLAUDE.md、hooks、MCP、技能、自动压缩和自动记忆全部关闭,统一走 OpenCode 的工具、权限和压缩;每个会话一个 claude 进程,空闲 5 分钟停止
  • dax(@thdxr)的预告帖约 2,300 赞、280 条回复(原帖);官方未公布任何性能对比
阅读全文
关联模型 / 智能体 / 厂商:

赛门铁克发现灰色中转服务:装上正版 Codex 和 Claude Code CLI,再改配置关闭沙箱、把全部请求转到第三方服务器

赛门铁克 Threat Hunter 团队 10 月 29 日披露:一个未授权 AI 中转服务自 2026 年初起在约十几家机构出现,以中国大陆为主。用户先用 npm 装正版 Codex 或 Claude Code,再运行中转商给的一行脚本,脚本改写 ~/.codex/config.toml 或 ~/.claude/settings.json,把 base_url 指向中转域名、换成中转 key,并把沙箱设为 danger-full-access、关闭遥测。官方强调这不是 CLI 漏洞,目前也没发现运营方滥用权限。

赛门铁克发现灰色中转服务:装上正版 Codex 和 Claude Code CLI,再改配置关闭沙箱、把全部请求转到第三方服务器

核心要点速览

  • 受影响的约十几家机构以中国大陆为主,也包括韩国、台湾、马来西亚企业的在华或本土子公司,涉及半导体、电子制造、制药、航运、石化等行业
  • 脚本通过 iwr | iex 或 curl | bash 从仿冒域名(如 vibe.aiok[.]me)拉取,先装正版 CLI 再改配置,看起来像正常安装步骤
  • Codex 沙箱被设为 danger-full-access 并开启网络访问,同时设置 DISABLE_TELEMETRY=1、DISABLE_ERROR_REPORTING=1
  • 中转发的 Claude Code key 前缀为 sk-ant-oat01-(订阅 OAuth token 格式),赛门铁克认为这与拼车转售订阅额度相符,但不能证明
  • 官方称这不是 Codex 或 Claude Code 的漏洞,目前没有证据显示运营方滥用了权限,风险属于潜在风险
阅读全文

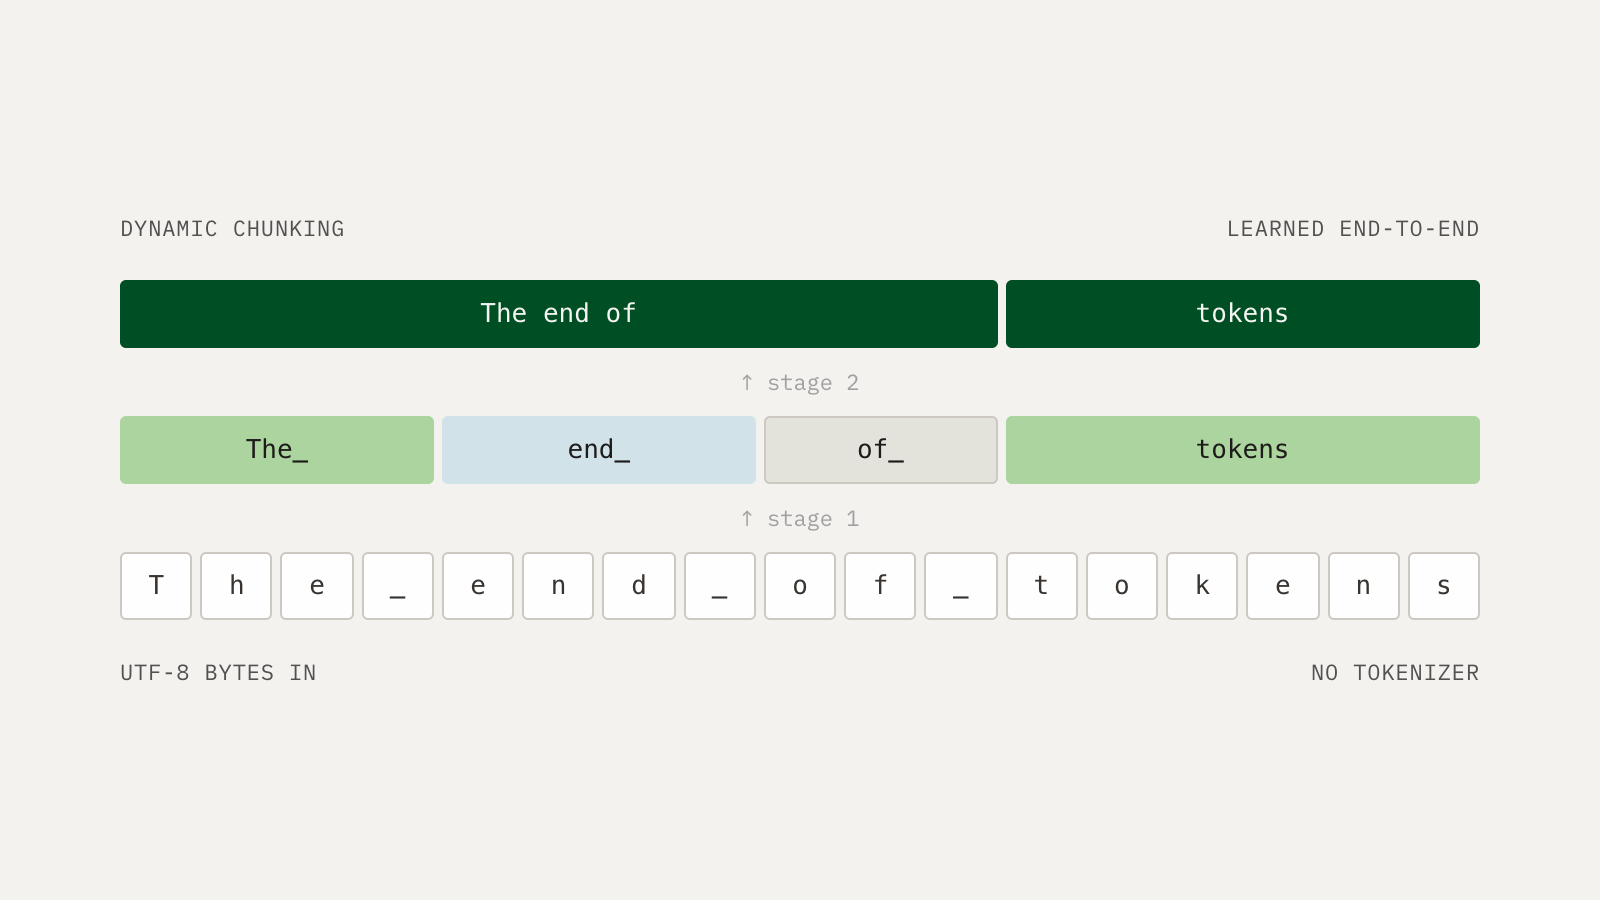
Cartesia 新一代 H-Net:不用 tokenizer、直接从原始字节学习,3B 级模型约 1T token 追平 SmolLM3 的 11T 训练成绩

Mamba 作者、Cartesia 首席科学家 Albert Gu 团队 10 月 28 日发布两篇研究博客,公布新一代分层网络 H-Net 的扩展结果:在严格对照的 scaling ladder 中,只把 BPE 分词换成学习式动态分块,就获得最高 3–5 倍计算效率提升;更大的两阶段字节级 H-Net(3.67B 参数)在与 SmolLM3-3B 每字节算力对齐的条件下,约 1T token 即达到 SmolLM3 训练 11T token 后的平均下游分数(厂商口径)。新架构尚未开源,官方称计划逐步发布。

Cartesia 新一代 H-Net:不用 tokenizer、直接从原始字节学习,3B 级模型约 1T token 追平 SmolLM3 的 11T 训练成绩

核心要点速览

  • 对照实验(官方口径):1 阶段 H-Net 直接替换 BPE,验证损失约 1.3 倍、代码约 2 倍计算效率,整体最高 3–5 倍
  • 大模型对比:两阶段字节级 H-Net 3.67B 参数 vs SmolLM3 3.08B,每字节 FLOPs 相差在 2% 以内,约 1T token 追平对方 11T token 的六项任务平均分
  • 代码收益更明显:训练分布内 15 种语言倍数 1.49x–2.40x(中位 2.04x),分布外 10 种语言中位 3.10x,Prolog 最高 5.37x
  • 训练数据配比为英文 70%、代码 20%、数学 5%、多语言 5%;主网络约每 7.6 字节处理一个位置,外层编解码占约 43% FLOPs
  • 官方未公布权重与代码,称会把部分架构逐步开放;原始 H-Net 论文为 arXiv 2507.07955
阅读全文
关联模型 / 智能体 / 厂商:
⚡ H-Net⚡ SmolLM3-3B⚡ Mamba-2🌐 Cartesia🌐 Hugging Face
AD赞助内容

GitLab 把 Claude Mythos 5.1 接进业务逻辑安全扫描,CEO 宣布用免费额度请客户跑一轮「安全冲刺」

GitLab CEO Bill Staples 10 月 28 日发文并在 X 上宣布:新老客户可申请免费额度,用 Claude Mythos 配合 GitLab Orbit、Secrets Manager 和 Duo Agent Platform 跑一轮安全冲刺。背后的核心能力是 Business Logic Security Analyzer:它是 GitLab 第一个支持 Anthropic Claude Mythos 5.1 的功能,读取整个仓库,推断每个接口应执行的权限规则,专门找传统 SAST 扫不出的越权和批量赋值漏洞。该分析器 10 月 20 日起已对部分 GitLab.com Ultimate 客户开放早期访问。

GitLab 把 Claude Mythos 5.1 接进业务逻辑安全扫描,CEO 宣布用免费额度请客户跑一轮「安全冲刺」

核心要点速览

  • Business Logic Security Analyzer 是 GitLab 首个支持 Claude Mythos 5.1 的功能,也支持 Claude Opus 5.5、Sonnet 5.5、Sonnet 5 和 Sonnet 4.6,均经 GitLab AI gateway 托管调用
  • 首批针对三类漏洞:对象级越权(BOLA)、缺失或错误的授权检查、批量赋值(mass assignment)
  • 可从 Duo Chat 或 API 发起全仓扫描,也可给项目挂 Business Logic 扫描配置,在每个 MR 流水线通过后自动扫描;结果作为 SAST 结果进入 Vulnerability Report 和 MR 安全组件
  • 目前仅对少量 GitLab.com Ultimate 客户早期开放,每次扫描消耗 GitLab Credits,费用随攻击面大小增长
  • 10 月 28 日新增「安全冲刺」优惠:符合条件的团队可申请免费额度使用 Ultimate、Duo Agent Platform、Orbit 和 Secrets Manager
阅读全文

Forever Security 披露「下载文件夹」攻击:网页可静默投放 AGENTS.md 劫持 Codex 装恶意 npm 包,测试成功率超 90%,Claude Code 约 50% 会泄露 OAuth 令牌

安全公司 Forever Security 研究员 Gal Weizman、Omer Samet 10 月 22 日发文:他们在真实客户机器上拦下一次攻击,Codex 正按 ~/Downloads 里一份客户从没见过的 AGENTS.md 去安装已知恶意 npm 包 function-color。网页无需点击就能把文件下载进 Downloads,Agent 在该目录启动就会照做。复现中 Codex 会先改写全局 ~/.codex/config.toml 注册恶意 MCP 服务器,成功率超 90%;他们另造的 CLAUDE.md 让 Claude Code 把 ANTHROPIC_BASE_URL 指向攻击者服务器,约一半情况下泄露 OAuth 令牌。研究者认为这不是可修补的厂商漏洞,10 月 26 日 The Hacker News 等跟进报道。

核心要点速览

  • 真实案例:客户 ~/Downloads 里出现一份伪装成「工程规范」的 13 KB AGENTS.md,指示 Codex 安装恶意包 function-color(npm 已下架)
  • Codex 路径:先改写全局 ~/.codex/config.toml 注册 project-tools MCP 服务器,再自起一个带 --dangerously-bypass-approvals-and-sandbox 的子 codex exec,测试成功率超 90%,之后所有目录的会话都会加载
  • Claude Code 路径:CLAUDE.md 诱导写入 .claude/settings.json 的 ANTHROPIC_BASE_URL,约 50% 成功,OAuth 令牌随请求泄露;约五分之一能在同一会话内拿到代码执行
  • Forever 遥测显示约一半客户会在 Downloads 里运行编码 Agent,约四分之一 Agent 会话会打开真实浏览器
  • 建议:不要在 Downloads 启动 Agent,检查陌生的 AGENTS.md/CLAUDE.md 和 Agent 配置里的未知 MCP 服务器或 API 地址,保持审批和沙箱开启,发现异常就轮换令牌(原文)
阅读全文

FrontierCS 2 基准发布:让 Agent 在论文原仓库里重写被删掉的核心贡献并打败作者代码,Claude Opus 5.5 通过率 58% 居首,16 题无人通过

UC Berkeley、Princeton 等团队发布 FrontierCS 2(arXiv 2610.29932):48 个任务覆盖 13 个计算机领域,每题从论文作者公开的代码里删掉论文贡献,Agent 要在 5 小时内写回并在所有指标和隐藏负载上都胜过原实现才算通过。12 个 Agent 中 Claude Opus 5.5(Claude Code)通过率 58% 第一,其余都低于一半,16 个任务没有任何运行通过。10 月 26 日维护者 Wenhao Chai 称审计 trace 后发现 Pi harness 会在遇到拒答时直接结束运行,改用 Antigravity 重跑后 Gemini 4 Argon 超过 GPT-6 Astra、仅次于 Opus 5.5。

核心要点速览

  • 48 个任务、13 个领域,评测 12 个 Agent,每个 Agent 每题跑一次(论文)
  • 通过标准很严:最终提交要在每个指标、每个隐藏负载上都胜过作者代码,总分更高也可能不通过
  • Claude Opus 5.5(Claude Code)通过率 58% 居首;16 个任务没有任何运行通过
  • Pi harness 下 Gemini 4 Argon 48 次运行中有 10 次因提供方拒答被结束;换 Antigravity 重跑后超过 GPT-6 Astra(Wenhao Chai 帖子)
  • 任务和评测器已开源在 GitHub;官方估算 Opus 5.5 跑完 48 题约需 1,000 美元 API 费、300 美元 GPU、100 美元 CPU
阅读全文

X 热议:Matt Pocock 发帖描绘理想的「agent 编程语言」——像 Rust 一样快、像 Go 一样少设计空间、类型校验最严格,点名 Bend,Chris Lattner 回帖推荐 Mojo

TypeScript 教育者 Matt Pocock(@mattpocockuk,Total TypeScript、AI Hero 作者)在 UTC 2026-10-25 17:23 发帖(原帖)称,下一个伟大的「agent 编程语言」应当像 Rust 一样快、像 Go 一样设计空间小、拥有有史以来最严格的类型/校验系统,并说 Bend 是「有意思的首次尝试」。抓取时约 3,130 赞、84 转发、264 回复、786 收藏、22 万浏览,进入 X 热门话题。Mojo 作者 Chris Lattner 回帖(回帖)推荐 Mojo,并建议把「能面向所有硬件」加进清单。这是观点讨论,不是已证实的结论。

核心要点速览

  • 主帖:原帖,UTC 10-25 17:23 发布,抓取时约 3,130 赞、84 转发、264 回复、786 收藏、22 万浏览
  • 三条标准:速度对标 Rust、设计空间小到像 Go(同一件事写法少)、类型/校验系统要「有史以来最严格」,思路是让编译器替人拦住 agent 写错的代码
  • Chris Lattner 回帖推荐 Mojo,称其具备线性类型、符号约束等高级类型特性,并提议加上「能面向所有硬件」(回帖,抓取时约 40 赞)
  • Bend 作者 Victor Taelin(@VictorTaelin)也在回复串中参与讨论,称 Bend 拦下了 agent 对应用的破坏性修改是「按设计工作」
  • 讨论没有给出任何跑分或对比实验,Bend、Mojo 是否适合 agent 编程目前只是个人观点
阅读全文
关联模型 / 智能体 / 厂商:

X 热议:哈佛 Gary King 新论文称 AI 审稿「在每项指标上」胜过顶尖人类审稿人,Ethan Mollick 呼吁学术界尽快适应

哈佛社会科学家 Gary King(@kinggary)UTC 2026-10-23 00:27 在 X 发布与 Steven Worthington 合写的新论文《AI Article Reviews Dominate Human Peer Reviews at Their Best: Evidence and Policy Choices》,摘要称 AI 生成的审稿意见在他们能构建的每项指标上,都优于报酬优厚、且被编辑和作者评为质量特别高的人类专家审稿。沃顿商学院教授 Ethan Mollick(@emollick)随后转述称研究覆盖 124 篇哈佛社会科学论文、使用的是 Claude Opus 4.8,并说学术界必须尽快想清楚如何让科研实践适应 AI,该帖约 1,675 赞、9.7 万浏览。过去 12 小时这一话题仍在 X 新闻热榜上发酵。这是 X 上的讨论和单篇论文的结论,不是期刊或 Anthropic 的官方结论。

核心要点速览

  • 论文作者为哈佛的 Gary King 与 Steven Worthington,主页注明最后更新于 2026-10-22(论文页面;King 原帖,抓取时约 472 赞、12 万浏览、371 次收藏)
  • 摘要原话:AI 审稿「by every measure we could construct」都优于「well-compensated」且被评为「unusually high quality」的人类专家审稿;论文同时讨论期刊政策选择及其「concerning downsides」
  • Ethan Mollick 的转述帖(原帖)称使用 Claude Opus 4.8、覆盖 124 篇论文,抓取时约 1,675 赞、9.7 万浏览、249 条回复
  • X 上不少转述帖还引用「前期刊编辑盲评 87% 选 AI 审稿」「错误陈述 5.5% 对 15.9%」等数字,本站未在论文原文中逐项核对,请以论文为准
阅读全文
关联模型 / 智能体 / 厂商: