AI 编程实时动态与要闻

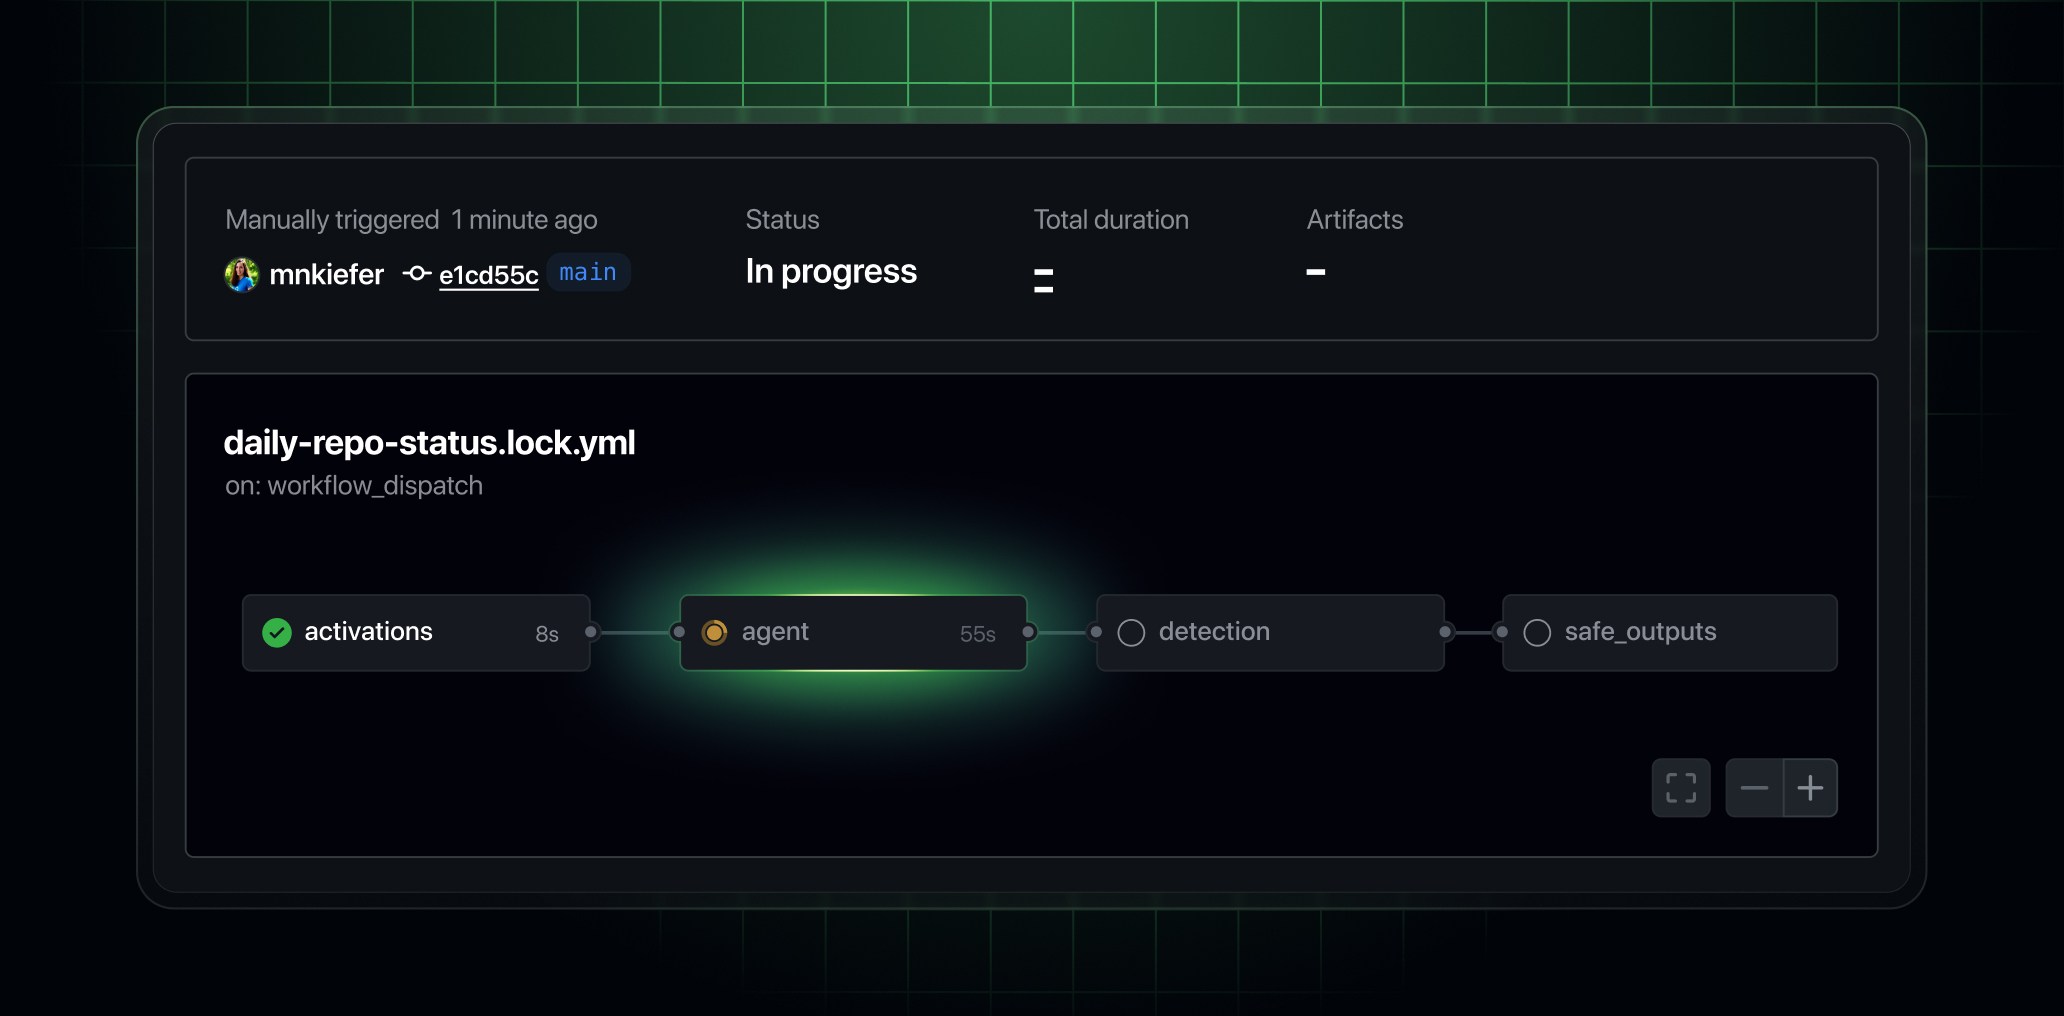
GitHub Copilot Automations 升级:团队共享自动化归仓库所有,新增 24 个触发器、20 个工具和 AI 额度上限

GitHub 在 10 月 28 日 Universe 大会上发布一组 Copilot Automations 更新:共享自动化归仓库所有,以 Copilot 身份执行、AI 额度记在仓库所有者账上,创建者离职也照常运行;新增 24 个 GitHub 事件触发器、REST API 外部触发和自动化串联,20 个新工具并支持自定义 MCP 服务器;可按单次、每天、每周、每月设置 AI 额度上限;自动化还能根据真实结果提出改进自身提示词的建议,VS Code 1.144 起可在云端运行。

GitHub Copilot Automations 升级:团队共享自动化归仓库所有,新增 24 个触发器、20 个工具和 AI 额度上限

核心要点速览

  • 共享自动化归仓库所有:有读权限即可查看、有写权限即可编辑,操作记为 Copilot,AI 额度计入仓库所有者
  • 新增 24 个触发器,覆盖 issue、PR、Discussions 和安全告警;可用 REST API 从 Jira、Sentry、PagerDuty 等外部系统触发
  • 新增 20 个 GitHub 工具(如合并 PR、重跑 workflow、上传截图),并可接入自定义 MCP 服务器
  • AI 额度上限可按单次、每天、每周、每月设置;组织仓库需管理员开启「Allow use of Copilot cloud agent billed to the organization」策略
  • 面向 Copilot Pro、Pro+、Max、Business 和 Enterprise 用户逐步开放;VS Code 1.144 打开 chat.automations.cloud.enabled 即可在云端运行
阅读全文
关联模型 / 智能体 / 厂商:

GitHub Agentic Workflows 正式 GA:用 Markdown 写自动化、编译成 Actions YAML,支持 Copilot 或自带编码 Agent,新增 ARC 自托管和 micro-VM 隔离

GitHub 于 10 月 28 日(Universe 2026)宣布 GitHub Next 的开源项目 GitHub Agentic Workflows 正式 GA,面向 GitHub Free、Team 和 Enterprise。开发者用自然语言 Markdown 描述 issue 分拣、CI 失败分析、文档更新、写测试等任务,gh aw 把它编译成标准 Actions YAML,由 Copilot 或自带的编码 Agent 执行。GA 新增 ARC 自托管 runner 和 Docker-in-Docker 支持、正式版 gh aw forecast 成本预估、按工作流选模型和模型路由,以及 Cloud Hypervisor / NVX micro-VM 隔离。

GitHub Agentic Workflows 正式 GA:用 Markdown 写自动化、编译成 Actions YAML,支持 Copilot 或自带编码 Agent,新增 ARC 自托管和 micro-VM 隔离

核心要点速览

  • 适用范围:github.com 上的 GitHub Free、Team 和 Enterprise 均可用;用默认的 Copilot CLI 引擎需要 Copilot 许可
  • 工作方式:Markdown 写需求,编译成标准 Actions YAML,复用已有 runner 组和策略;可用 Copilot 或自带编码 Agent
  • 安全默认值:只读权限、沙箱容器加 Agent Workflow Firewall、safe outputs 校验,以及应用变更前的威胁检测作业
  • GA 新增:ARC 自托管 runner 加 Docker-in-Docker、gh aw forecast 转正(含威胁检测额度和月度区间)、按工作流选模型提供方、模型路由、micro-VM 隔离和跨仓库 enclave
  • 客户案例(Accenture 口径):一位负责人每周省约 29 小时,团队 91% 的 commit 由 AI 编写,生产错误从每天约 11,000 个降到 1,000 以下
阅读全文

X 热议:Box CEO Aaron Levie 称企业工作流里真正用上 AI 智能体的不到 1%,呼应 Sarah Guo「仍处于早期 Claude Code 时代」

Conviction 创始人 Sarah Guo 10 月 27 日发帖说,企业工作流自动化「仍处在自动补全 / 早期 Claude Code 时代,但不会太久」,约 8 万浏览、近 500 赞。Box CEO Aaron Levie 次日引用并展开,认为绝大多数企业流程还没有被智能体实质性改造,整体部署可能不到 1%,瓶颈主要在 AI 能力本身;他认为计算机操作、长时运行智能体和智能体集群正在改变这一点。Levie 的帖子约 635 赞、486 收藏、6.3 万浏览、150 多条回复。这是两人的观点和估计,不是统计数据。

核心要点速览

  • Sarah Guo(Conviction 创始人):企业工作流自动化仍处在「自动补全 / 早期 Claude Code 时代」,但不会持续太久
  • Aaron Levie(Box CEO):多数企业流程还没被智能体实质改造,经济整体部署「可能不到 1%」,这是他的估计
  • Levie 认为主要瓶颈是 AI 能力本身,其次才是企业采用速度
  • 他看好计算机操作、长时运行智能体、harness 改进和智能体集群,让更复杂的流程可以交给智能体
  • 他的判断:重点不在用户给智能体下指令,而在组织重构底层流程,金融、生命科学、医疗等信息密集行业受影响最大
阅读全文
关联模型 / 智能体 / 厂商:

蚂蚁百灵开源 Ling-3.1-flash-1019:560B/25B 激活 MoE 再后训练,AA 智能指数从 41 升到 44,同步放出 base 底座

蚂蚁百灵(Ant Ling / inclusionAI)10 月 27 日开源 Ling-3.1-flash-1019,是 10 月初 Ling-3.1-flash 的再后训练升级版:总参 560B、每 token 激活 25B、1M 上下文,MIT 许可。官方称它在 Artificial Analysis 智能指数 v4.3.2 上得 44 分(前代 41),AA-Briefcase、AutomationBench-AA 等智能体任务明显提升;同时开源可继续训练的 Ling-3.1-flash-base。

蚂蚁百灵开源 Ling-3.1-flash-1019:560B/25B 激活 MoE 再后训练,AA 智能指数从 41 升到 44,同步放出 base 底座

核心要点速览

  • 规模:总参 560B、激活 25B,1M token 上下文,MIT 许可,HF 与 ModelScope 同步上架
  • Artificial Analysis 智能指数 v4.3.2:44 分,前代 Ling-3.1-flash 为 41(官方口径)
  • AA-Briefcase 约 1400 升至 1524 Elo,AutomationBench-AA 62% 升至 68%(官方口径)
  • 科学类:CritPt 18% 升至 26%,SciCode 54% 升至 57%(官方口径)
  • 架构:混合线性 MoE,63 层 KDA + 9 层门控 MLA(7:1),512 路由专家、每 token 激活 8 个
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容

上海 AI 实验室发布 Atria Dawn 正式版:基于 744B MoE GLM-5.2 的智能体模型,上下文翻倍至 512K,MIT 开源

上海人工智能实验室把 Atria Dawn 从 Preview 升级为正式版,Hugging Face(internlm/Atria-Dawn 及 FP8 版)与 ModelScope 均已上线开放权重,MIT 许可。模型基于 744B 参数 MoE 的 GLM-5.2,面向科研与工程类长程智能体任务,上下文从 Preview 的 256K 翻倍到 512K,仅接受文本输入。官方表格显示其在 AutomationBench、CyberGym、SkillsBench 等智能体基准上领先所列模型,但在 SWE-bench Pro、Terminal-Bench 2.1 等编码基准上仍落后 Claude Opus 5(均为厂商口径)。

上海 AI 实验室发布 Atria Dawn 正式版:基于 744B MoE GLM-5.2 的智能体模型,上下文翻倍至 512K,MIT 开源

核心要点速览

  • 上下文 512K,是 Preview 版 256K 的两倍;基座为 744B 参数 MoE 的 GLM-5.2,仅支持文本输入
  • Hugging Face 与 ModelScope 提供 BF16 与 FP8 权重,MIT 许可
  • 厂商口径:AutomationBench 54.7、CyberGym 86.8、SkillsBench 67.8、BFCL V4 78.4,均为表内最高
  • 短板同样来自官方表:SWE-bench Pro 61.7 对 Claude Opus 5 的 76.5,Terminal-Bench 2.1 81.0 对 90.2
  • 本地部署需 SGLang v0.5.13.post1+ 或 vLLM v0.23.0+;也提供 OpenAI 兼容 API,可直接接入 Codex
阅读全文
关联模型 / 智能体 / 厂商:

Mistral 与 NVIDIA 达成工业工程 AI 战略结盟:万亿参数 Mistral Large 4 重磅前瞻曝光

欧洲前沿 AI 巨头 Mistral AI 与 NVIDIA 在 GTC Berlin 宣布达成工业工程 AI 深度战略合作,全面加速物理 AI、计算机辅助工程(CAE)与芯片设计(EDA)的智能化变革。合作将 Mistral 旗舰模型与 NVIDIA CUDA-X、Warp 物理引擎以及 Omniverse 实时数字孪生进行全链路打通。官方博客同时公布了备受瞩目的下一代旗舰模型 Mistral Large 4 的核心技术参数:总参数量接近 1 万亿(1T),激活参数为 490 亿(49B MoE),在 3800 张 Grace Blackwell GPU 集群上训练完成,模型权重定于 10 月底正式开源发布,并将联合 Nemotron 联盟共建工业基座。

Mistral 与 NVIDIA 达成工业工程 AI 战略结盟:万亿参数 Mistral Large 4 重磅前瞻曝光

核心要点速览

  • Mistral AI 与 NVIDIA 官宣战略合作,将大模型能力全面注入计算机辅助工程(CAE)、物理仿真与半导体芯片设计(EDA)
  • 深度融合 NVIDIA Warp、CUDA-X 物理加速库与 Omniverse 数字孪生平台,构建工程仿真领域的开源智能体评测与基准
  • 首次正式公开 Mistral Large 4 核心规格:约 1 万亿总参、49B 稀疏激活 MoE 架构,在 3800 张 Grace Blackwell 算力集群完成预训练
  • Mistral Large 4 官方权重定于 2026 年 10 月底全量开源发布,并宣布双方加入 Nemotron 联盟向 2030 年 1 GW 绿色算力推进
阅读全文
关联模型 / 智能体 / 厂商:

MiniMax 正式发布 M3.1 Flash 并于 10 月 23 日开放权重:428B 总参 / 23B 激活,每百万 token 输入 $0.15、输出 $0.60,DeepSWE 73.7%

MiniMax 官方确认,此前在 OpenRouter 等榜单上用量领先的匿名模型 Space Bunny 就是 M3.1 Flash 的早期版本,并于 10 月 19 日正式上线 API。按量计费为输入 $0.15、输出 $0.60、缓存读 $0.015(每百万 token),1M 上下文,支持文本、图片和视频输入,可用 effort 调节思考深度。官方口径:成本是 M3 的 1/3、速度 3 倍,DeepSWE 73.7%、Automation-Bench 62.2%;10 月 23 日权重已按期在 Hugging Face 开放(MiniMax Community 许可,MXFP8),Together、Inferact(vLLM)、LightSeek TokenSpeed 首日支持。

MiniMax 正式发布 M3.1 Flash 并于 10 月 23 日开放权重:428B 总参 / 23B 激活,每百万 token 输入 $0.15、输出 $0.60,DeepSWE 73.7%

核心要点速览

  • 官方定价(按量):输入 $0.15 / 输出 $0.60 / 缓存读 $0.015 每百万 token;按单价是 M3($0.30/$1.20)的一半,官方「1/3 成本」未说明计算口径。
  • 官方跑分:DeepSWE v1.1 73.7%(Opus 5 为 74.0%)、Automation-Bench 62.2%、BabyVision(带工具)91.0%、Terminal Bench 4.0 38.1%(Opus 5 为 51.8%)。
  • 1M 上下文,文本/图片/视频输入,effort 五档 low 到 max,默认 max,思考不能关闭。
  • 10 月 23 日权重已开放:Hugging Face MiniMaxAI/MiniMax-M3.1-Flash,非 gated,MiniMax Community 许可(非 MIT/Apache),MXFP8 量化,原生多模态 MoE,总参约 428B、每 token 激活 23B,自带 DSpark 投机解码草稿头。
  • 迁移提醒:M2.5/M2.7 自 10 月 19 日起不再对新用户开放,11 月 18 日下线;M Plan 与 Token Plan 的请求已自动路由到 M3.1 Flash。
  • 首日部署:Together AI 托管上线,MiniMax 与 Inferact 合作把生产推理改进回馈 vLLM,LightSeek 的 TokenSpeed 也提供首日支持。
阅读全文

Liquid AI 开源 LFM2.5-24B-A2B:24B 总参、约 2B 激活的推理型 MoE,主打本地 Agent 与工具调用

Liquid AI 10 月 13 日发布 LFM2.5 家族最大也是最后一款模型 LFM2.5-24B-A2B:总参 24B、每 token 激活约 2.45B,131K 上下文,强制先思考再回答。厂商口径下在 8 项工具/Agent 基准中 5 项领先或持平 Qwen3.6-35B-A3B(AutomationBench 27.69 vs 8.72),但 SWE-Bench Verified、GPQA 等知识与编码项落后。权重已上 Hugging Face,并有 GGUF/MLX/FP8/ONNX 版本;API 定价 $0.10/$1.00 每百万 token,OpenRouter 同步上架。

Liquid AI 开源 LFM2.5-24B-A2B:24B 总参、约 2B 激活的推理型 MoE,主打本地 Agent 与工具调用

核心要点速览

  • 规格(模型卡):总参 24.0B、激活 2.45B;40 层(30 个门控短卷积块 + 10 个 GQA);每个 MoE 块 64 专家 top-4 路由;上下文 131,072、词表 128K
  • Agent 基准(厂商口径,对比 Qwen3.6-35B-A3B):AutomationBench 27.69 vs 8.72、LiveClaw 48.09 vs 38.19、ToolSandbox 80.71 vs 75.02、BFCLv4 65.01 vs 65.00
  • 短板同样公开:SWE-Bench Verified(OpenCode)51.00 vs 66.20、GPQA Diamond 74.42 vs 83.69、WebArena Verified 26.75 vs 37.62,官方建议知识类任务搭配检索
  • 速度(官方博客):Apple M5 Max 解码 184 tok/s、AMD Ryzen AI Max+ 395 为 114 tok/s;单张 B300 + SGLang 高并发超 21K 输出 tok/s
  • 训练:预训练由 17T 扩到 33T token,中训 2T@32K + 300B@131K;后训练含在 OpenClaw、Hermes Agent、Pi、OpenCode 中的 Agentic RL;API $0.10 输入 / $1.00 输出每百万 token
阅读全文
关联模型 / 智能体 / 厂商:
⚡ LFM2.5-24B-A2B⚡ LFM2.5-24B-A2B-Base⚡ LFM2-24B-A2B⚡ Qwen3.6-35B-A3B⚡ Gemma-4-26B-A4B-it🤖 Hermes Agent🤖 OpenClaw🤖 OpenCode🤖 Pi🌐 Liquid AI🌐 Hugging Face🌐 OpenRouter

ChatGPT dots 更新:手机上就能创建自己的 dot,还能直接给 Codex 派活、续接已有线程

OpenAI 10 月 9 日发布 dots 周更:iOS / Android 版 ChatGPT 可直接创建并定制 dot、连接插件;dot 能在 Codex 发起任务并跟进已有线程,检索 ChatGPT 对话与 Codex 线程、自动化作为上下文,并能查看和修改 ChatGPT Work 的定时任务。

ChatGPT dots 更新:手机上就能创建自己的 dot,还能直接给 Codex 派活、续接已有线程

核心要点速览

  • 移动端:iOS / Android 可直接创建 dot、命名、改外观、连接插件,并可设为打开 ChatGPT 即进入 dot 对话(更新说明)
  • Codex 联动:dot 可在 Codex 新建任务或续接已有线程,更会判断“续接还是新开”
  • 上下文:可检索 ChatGPT 历史对话,并读取已有 Codex 线程与自动化
  • 自动化:dot 可读取并编辑 ChatGPT Work 的定时任务
  • 热度:官方公告帖约 1,090 赞、11.9 万次浏览
阅读全文
关联模型 / 智能体 / 厂商:

Anthropic 三连降本:Sonnet 5.5 缓存读取腰斩至 $0.10/MTok,Max 订阅每月送 $100–$200 API 额度,Managed Agents 定时自动化官方模板上线

Sonnet 5.5 缓存命中价降至基础输入价的 0.05 倍($0.10/MTok),官方称多数 Agent 工作负载便宜约 20%;Max 5x/20x 每月附赠 $100/$200 Claude API 额度(Team 每席 $20–$100),可用于 API、Managed Agents 与 Agent SDK;配套发布定时读 Slack/GitHub 并推送简报的 Managed Agents 参考实现。

核心要点速览

  • Sonnet 5.5 缓存读取 $0.20→$0.10/MTok(0.05x 基础输入价),输入 $2、输出 $10 不变,官方定价页已更新;Opus 5.5 同为 0.05x($0.20/MTok)
  • 官方口径:多数 Agent 工作负载整体成本下降约 20%;仅限 API,Claude Code 订阅用量上限不变
  • Max 5x 每月 $100、Max 20x 每月 $200 API 额度,Team 标准席 $20/高级席 $100(团队池上限 $500),当期过期不滚存,详情
  • 额度覆盖 Claude API / Managed Agents / Agent SDK / Playground,不覆盖 Claude Code 与 App 超额用量
  • Managed Agents 计费 = Token + $0.08/会话小时运行时;官方 daily-brief 参考实现 可在 Claude Code 中一条命令生成
阅读全文
AD赞助内容

零人工标注造就自进化智能体!DAEDALUS 框架开源:探索-解题双 Agent 自博弈练习,程序化记忆使成功率狂升 15.9%

大模型智能体进入陌生环境或操作新工具时,往往极度缺乏系统运维经验与环境隐性规则,导致在类似步骤中反复触礁。现有的智能体记忆系统严重依赖昂贵的人工标注指南或预先提供的基准任务与 Oracle 判定器。Illuin Technology 团队在最新研究(arXiv:2610.08048)中开源了全新无监督记忆自演进框架 DAEDALUS。DAEDALUS 独创“探索者(Explorer)与解答者(Solver)”双智能体自博弈范式:Explorer 自主在沙箱环境中挖掘有挑战性但可解的新任务;Solver 尝试解题并在遭遇失败时提炼启发式规则(Heuristics);只有当该规则在后续重试中持续带来确定性成功时,系统才会将其持久化写入记忆库。在 AppWorld、tau^2-bench 和 AutomationBench 三大高难度真实环境基准中,DAEDALUS 在零人工干预下将任务平均成功率最高提升 15.9 个百分点,Pass^5 成功率实现 2.2 倍翻倍提升,且提炼出的记忆规则具备出色的跨模型家族通用迁移能力。

核心要点速览

  • Illuin Technology 开源 DAEDALUS 框架,实现零人工标注与无 Oracle 判定器的智能体程序化记忆自演进
  • 首创探索者(Explorer)与解答者(Solver)自博弈架构,基于失败轨迹提炼可重复验证的黄金启发式规则
  • 在 AppWorld 等三大基准上任务成功率最高提升 15.9%,Pass^5 翻倍达 2.2x,沉淀出的经验具备跨模型通用迁移能力
阅读全文
关联模型 / 智能体 / 厂商:

盲目重试导致 53% 状态重放灾难!UndoBench 首创工具智能体容灾回滚基准:解耦名义任务力与故障自愈力

随着大模型工具调用智能体(Tool-Using AI Agents)在金融风控、企业 ERP、DevOps 及云运维核心业务中深度落地,现行主流基准(如 AgentBench、ToolBench)普遍仅测试“顺境下的单向任务完成率”,将基础规划能力与运行期故障容灾能力严重混淆。真实生产环境充斥着网络丢包、并发冲突、局部事务失败等隐蔽故障,盲目重试极其容易导致资金重复扣减、数据库重复写入等灾难性副作用。为此,研究团队正式提出 UndoBench(arXiv:2610.05622),涵盖 8 大企业级领域的 36 类基准业务流与 36 种真实故障场景。通过同种子反事实配对试验、网络线级副作用历史(Wire-Level Effect History)与全局环境状态预言机,评测揭示了触目惊心的断层:在开源与商业大模型的测试中,智能体名义任务完成率虽高达 83.54%,但在遭遇突发故障时,条件容错恢复成功率(CRSR)断崖式跌至 46.72%,且最常用的朴素重试策略在 53.33% 的测试中直接诱发了不可逆的外部重复副作用。代码已在 GitHub 全面开源(tradertanmay/undobench)。

核心要点速览

  • 推出首个面向工具调用智能体的故障容灾与回滚基准 UndoBench,涵盖 8 大企业领域 36 类工作流与 36 种实战故障
  • 解耦名义任务力与故障自愈力:测试显示任务顺境完成率高达 83.54%,但故障自愈率跌破 46.72%,且 53.33% 的朴素重试引发重复扣减等不可逆副作用
  • 揭示状态突变中与提交后未确认等不同阶段的容错断层,推动 Agent 系统从无脑重试转向基于补偿事务的确定性容错
阅读全文
关联模型 / 智能体 / 厂商:

Google DeepMind 发布 Gemini 4 Argon:DeepSWE 77.9%、1M 输出;Fairwind 可信防御方首发

DeepMind 官宣前沿模型 Gemini 4 Argon,面向长程编码、企业知识工作与网络防御;首发经 Fairwind 向可信防御方开放。官方:DeepSWE v1.1 77.9%、AutomationBench 51.3% 第一、LVBench 91.7%、CWE-bench v1 并列 68%;引进价 $2/$10 每百万 token,输出上限 1M。

Google DeepMind 发布 Gemini 4 Argon:DeepSWE 77.9%、1M 输出;Fairwind 可信防御方首发

核心要点速览

  • 模型:Gemini 4 Argon;长程编码 / 企业知识工作 / 网络防御;见 官方博文
  • Benchmark(官方):DeepSWE v1.1 77.9% SOTA;AutomationBench 51.3% #1;LVBench 91.7%;CWE-bench v1 并列 68%;Fairwind 图:漏洞发现 85.8% / Wiz 渗透 70.9%
  • 容量与定价:输出上限 1M tokens(自 ~64K);引进价 $2/$10 每百万 in/out(缓存 input ~95% off),引进期后 $4/$20
  • 准入:今日仅 Fairwind 可信防御方;随后优先付费 API 与 Google AI Ultra;公开 AI Studio 尚不可用
  • 内部实证:量子子程序时空优化一例优于基线 40%;libgav1 Rust 端口较原 Rust 快 2.7×;数据中心已释放 300+ TiB 内存
阅读全文
C
Comet@comet-ml·
👀51
🔥91

Comet Opik 2.2.84:在线评测规则原生接 Jev(OpenRouter Decisions API);队列自动化与溯源

Comet Opik 于 2026-09-29 发布 2.2.84:在线 LLM-as-a-Judge 规则可端到端调用 TypeSafe Jev(经 OpenRouter POST /api/alpha/decisions,而非 chat/completions)。布尔指标各成一道 yes/no 题,单次调用批答;概率 ≥0.5 记 1,原因字段展示 Probability: 0.93。后端新增 OpenRouterDecisionsClient(工作区 OpenRouter key + 429/5xx 重试),模型 ~typesafe/jev-latest / typesafe/jev-1.13。同步支持 Annotation Queue 自动化配置与条目 provenance;相对 2.2.83 约 8 commits / 104 files。

Comet Opik 2.2.84:在线评测规则原生接 Jev(OpenRouter Decisions API);队列自动化与溯源

核心要点速览

  • 发版:2.2.84(2026-09-29);对比 2.2.83...2.2.84 ≈8 commits / 104 files
  • 核心:PR #8540 在线评测走 OpenRouter Decisions API 调 Jev;chat/completions 会被拒
  • 计分:每条 Boolean 规则→一道 yes/no;概率 ≥0.5 → 分值 1,reason 带 Probability
  • 模型:~typesafe/jev-latest、typesafe/jev-1.13(不进常规 chat 模型 YAML 同步列表)
  • 体验:Annotation Queue 可配自动化并展示条目 provenance;另有 trace stats 读窗口与 thread_id 注册修复
阅读全文
关联模型 / 智能体 / 厂商:

CompoWorld 突破通用智能体多服务协同瓶颈:10,130 个工具组合拓扑缩放,35B 模型跑分超越 Claude Opus 4.6

针对合成环境局限于孤立单工具、无法泛化到真实世界多服务跨界协同长程流程的根本痛点,南京大学等研究团队推出 CompoWorld。通过构建包含 448 个独立服务与 10,130 个工具的组合式环境,借助随机游走依赖图生成跨服务信息流动任务,并配套以完成度为核心的细则奖励机制(Completion-Focused Rubric Reward),在仅用 3K SFT 轨迹和 1K RL 任务训练的 Qwen3.6-35B-A3B 上,八项基准平均提升 9.17 分,并在 AutomationBench 上全面超越 Claude Opus 4.6。

CompoWorld 突破通用智能体多服务协同瓶颈:10,130 个工具组合拓扑缩放,35B 模型跑分超越 Claude Opus 4.6

核心要点速览

  • 10,130 个跨服务工具的组合式扩展:打破以往合成环境单一孤岛限制,通过自动化 Coding Agent 生成具备类型化状态与统一接口的 448 个微服务,并利用世界模型模拟无法硬编码的外部工具。
  • 依赖图随机游走与真实跨界信息流:利用随机游走算法串联异构服务的依赖拓扑,生成必须跨越多个异构 API 传递上下文与执行回执的复杂高保真长程任务。
  • 35B 小基座全面击败前沿旗舰:在 8 项主流智能体基准上平均大涨 9.17 分;在权威自动化工作流基准 AutomationBench 上,35B-A3B 稀疏架构击败 Claude Opus 4.6,领跑所有同量级智能体特化模型。
阅读全文
关联模型 / 智能体 / 厂商: