
AI 编程实时动态与要闻

Artificial Analysis 发布 Endpoint Accuracy Index v1.1:100+ 无服务器端点近 1/4 低于参考权重部署

2026-11-06,Artificial Analysis 发布 Endpoint Accuracy Index v1.1:以自建官方权重部署为 100% 参考,用 BFCL-500、HLE-250、AA-LCR-25(等权)衡量各厂商 serverless 端点保住了多少精度。官方口径:已测 100+ 端点中近四分之一低于参考;AA-LCR-25 升至 v1.1 且重复从 10 提到 25(平均 95% CI 约 ±4.7→±2.6);覆盖扩至六款开源权重模型,新增 GLM-5.3 Flash 与 Muse Spark Open。
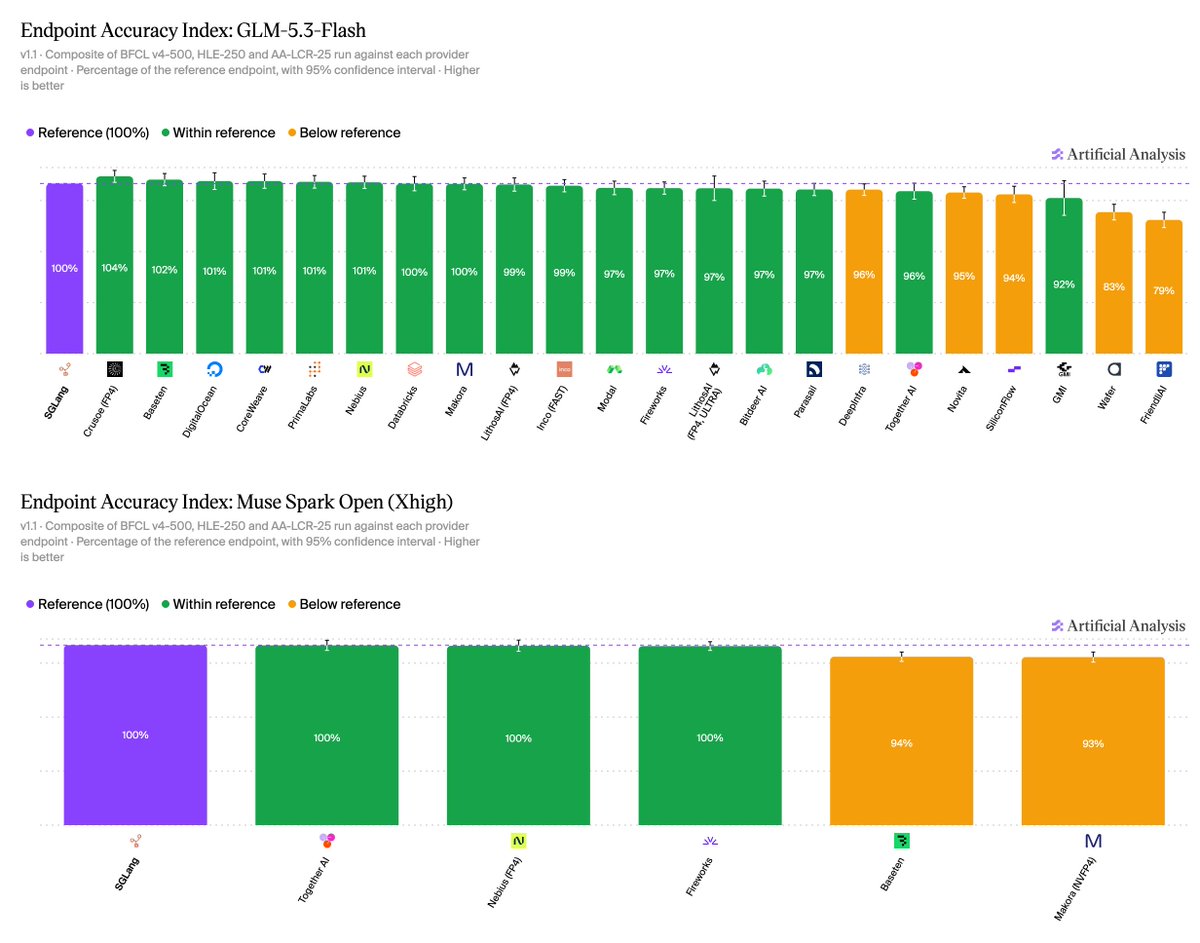
Artificial Analysis 发布 Endpoint Accuracy Index v1.1:100+ 无服务器端点近 1/4 低于参考权重部署

核心要点速览

  • 官方:@ArtificialAnlys 2026-11-06 02:44 UTC;changelog 05 Nov 2026;方法论页 Endpoint Accuracy Index v1.1
  • 厂商口径:100+ serverless 端点中近 1/4 低于自建参考;服务商常为速度/成本做量化、自定义 kernel、调栈或限输出
  • 套件等权:BFCL v4-500(3 次)、HLE-250(10 次)、AA-LCR-25(25 次);相对参考给 95% 置信区间并标注是否显著偏低
  • GLM-5.3 Flash:22 端点中 16 个与参考统计一致、1 个约 104.2;约 32K 输出上限端点 HLE-250 约 22%/29% vs 参考 55%
  • Muse Spark Open:5 端点中 3 个约 99.5–99.9(含 FP4);另 2 个主要在工具调用掉分(BFCL-500 约 50%/51% vs 59%)
阅读全文

NVIDIA 开源 Nemotron 3.5 Bolt E4B 4GB:基于 Gemma 4 E4B 后训练的本地小模型,主打语音助手、角色与机器人对话和工具调用

2026-10-23(UTC 15:41,SGT 23:41),NVIDIA AI 官方账号 @NVIDIAAI 宣布 Nemotron 3.5 Bolt E4B 4GB 上线,定位是能对话、能调用工具的本地小模型,用于本地助手、互动角色和机器人。Hugging Face 官方模型卡显示:它由 Gemma-4-E4B-it 后训练而来,总参数 8B(有效 4B),Q4_K_M 量化,输入输出各支持最多 64K token,可开关思考模式,并提供 DFlash 推测解码草稿模型和 BF16 版本;权重、数据和训练配方开放,许可证为 OpenMDW-1.1,可商用。模型卡跑分中,4GB 量化版 MultiChallenge 55.60(Gemma4 E4B-it 同量化 39.36、Qwen3.5 4B 52.23),但 Tau2-Bench 52.32、BFCL-v3 67.31 低于 Qwen3.5 4B。

NVIDIA 开源 Nemotron 3.5 Bolt E4B 4GB:基于 Gemma 4 E4B 后训练的本地小模型,主打语音助手、角色与机器人对话和工具调用

核心要点速览

  • NVIDIA 官方发布 Nemotron 3.5 Bolt E4B 4GB,面向本地助手、互动角色和机器人
  • 基于 Gemma-4-E4B-it 后训练,总参数 8B(有效 4B),Q4_K_M 量化,64K 上下文,可开关思考模式
  • 权重、数据、训练配方开放,OpenMDW-1.1 许可可商用,附 DFlash 推测解码草稿模型
  • 模型卡跑分:MultiChallenge 55.60 领先同级,但 Tau2-Bench 和 BFCL-v3 不及 Qwen3.5 4B
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Nemotron 3.5 Bolt E4B⚡ Gemma 4 E4B🌐 NVIDIA🌐 Google

工具调用后训练新体系!复旦大学等开源 WEFT:全系统自进化+MegaMCP 隔离,BFCL 与复杂流评测暴涨 12%

近期推动大模型工具调用能力后训练(Post-Training)的研究大多局限于可执行环境的孤立合成(如 Agent-World)。然而,环境只是由“环境、任务、智能体外壳(Harness)与评估器”构成的完整智能体交互系统中的单一组件,孤立扩展环境无法产生可靠且协调的强化学习训练信号。复旦大学邱锡鹏团队联合多家机构提出了全系统自进化后训练体系 WEFT(Whole-system Evolution For Tool-use Post-training,arXiv:2609.36887):框架在环境广度、任务复杂性与交互多样性三层维度联合构建交互生态;通过执行驱动的自进化(Execution-driven self-evolution)解析交互轨迹与环境状态证据,对失效根因组件进行定点定向修订并生成全新 Rollout 迭代进化;针对后训练阶段的大规模并发不稳定性,WEFT 创新设计了保留前缀的动态采样、原子交互轮次信用分配,并打造了基于模型上下文协议的 MegaMCP 运行时,在共享工具服务上保障完全隔离且可恢复的会话状态。评测显示,WEFT-14B 在 BFCL V4、tau^2-Bench 和 Claw-Eval 上全面超越同等规模基线,相较 Agent-World-14B 提升高达 6.41、2.23 和 12.27 个百分点,并在 Toolathlon-Verified 等长程复杂工作流上展现出极强的工业级工具调用泛化力。

工具调用后训练新体系!复旦大学等开源 WEFT:全系统自进化+MegaMCP 隔离,BFCL 与复杂流评测暴涨 12%

核心要点速览

  • 提出 WEFT 全系统协同后训练架构,打破孤立合成环境的传统局限,实现环境、任务、外壳与评测器四位一体闭环进化
  • 集成保留前缀采样、原子轮次信用分配与 MegaMCP 隔离运行时,保障长程工具强化学习的极高训练稳定性
  • WEFT-14B 在 BFCL V4 提升 6.41 pp、tau^2-Bench 提升 2.23 pp,在 Claw-Eval 上相较 Agent-World 暴涨 12.27 pp
阅读全文
关联模型 / 智能体 / 厂商:

SLCA-GRPO 破解工具调用智能体强化学习难题:段级优势解耦消除奖励污染,τ²-Bench 大涨 9.15%

针对工具调用智能体在 GRPO 强化学习中将整条轨迹标量优势均摊导致梯度噪声污染工具调用的结构性缺陷,北大等团队提出 SLCA-GRPO。通过架构段级优势解耦、Schema 引导模拟器 (SGLS) 与分层奖励机制,无需额外重采样即彻底隔绝文本与工具区段的噪声传递,在 7B 模型上实现 τ²-Bench +9.15% 提升与 BFCL +1.36% 提升。

SLCA-GRPO 破解工具调用智能体强化学习难题:段级优势解耦消除奖励污染,τ²-Bench 大涨 9.15%

核心要点速览

  • 解决 CSCM 奖励污染:针对现有 GRPO 盲目将轨迹总标量优势回传给所有 Token 导致的跨段误归因(CSCM),首次在单次 rollout 组内实现结构段级优势解耦。
  • 分层奖励与无害探索:配套提出 Schema 引导的 LLM 模拟器(SGLS)和分层奖励(HierR),将执行优势精确导向工具 Token,偏好优势导向文本 Token,无需调用昂贵真实 API。
  • 全方位跑分与降本:在 7B 参数基座上相比标准 GRPO、ToolPO 和 RLTR,域内提升 +2.53%,伯克利函数调用榜(BFCL)提升 +1.36%,复杂双层 τ²-Bench 大涨 +9.15%,且显著降低冗余调用成本。
阅读全文
关联模型 / 智能体 / 厂商:
AD赞助内容