
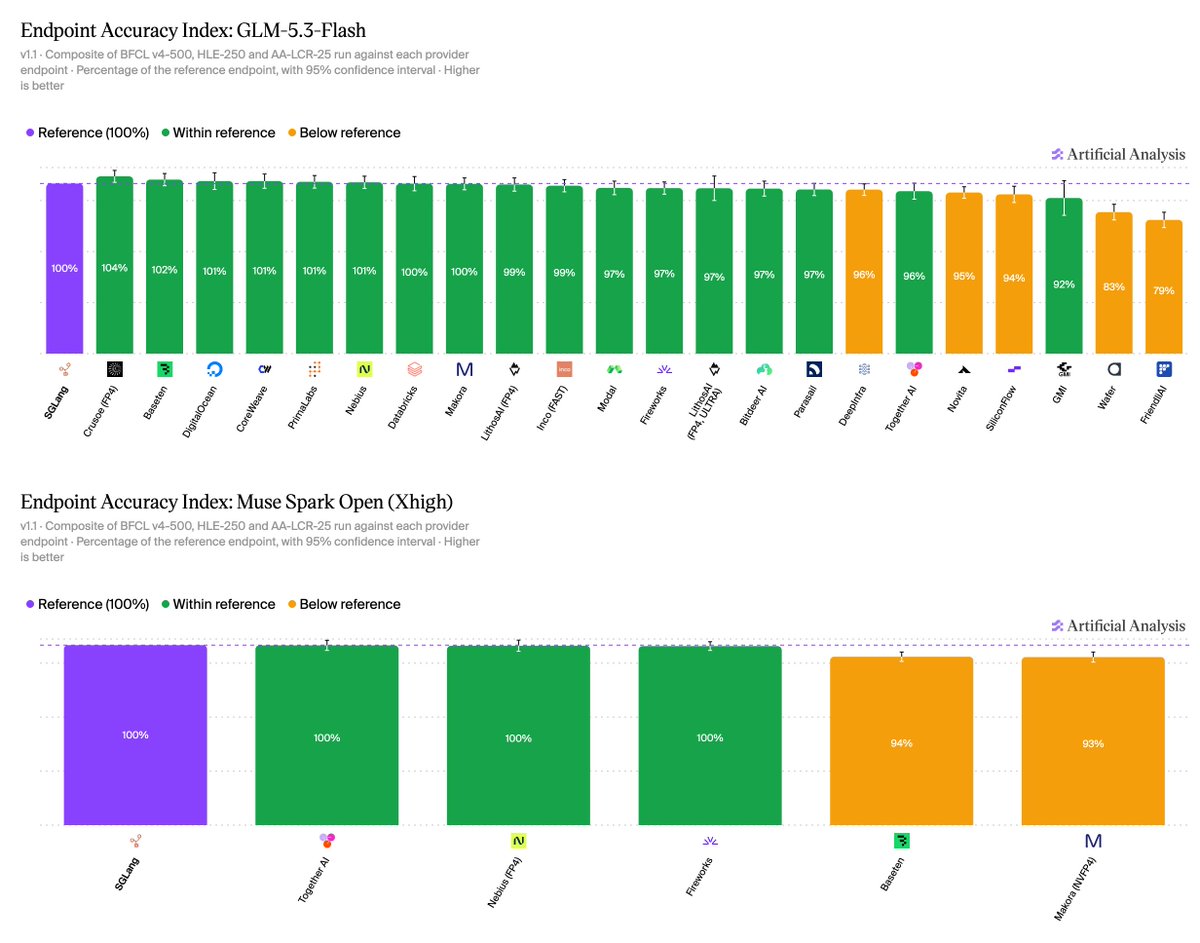
2026-11-06,Artificial Analysis 发布 Endpoint Accuracy Index v1.1:以自建官方权重部署为 100% 参考,用 BFCL-500、HLE-250、AA-LCR-25(等权)衡量各厂商 serverless 端点保住了多少精度。官方口径:已测 100+ 端点中近四分之一低于参考;AA-LCR-25 升至 v1.1 且重复从 10 提到 25(平均 95% CI 约 ±4.7→±2.6);覆盖扩至六款开源权重模型,新增 GLM-5.3 Flash 与 Muse Spark Open。
核心要点速览
- ✓官方:@ArtificialAnlys 2026-11-06 02:44 UTC;changelog 05 Nov 2026;方法论页 Endpoint Accuracy Index v1.1
- ✓厂商口径:100+ serverless 端点中近 1/4 低于自建参考;服务商常为速度/成本做量化、自定义 kernel、调栈或限输出
- ✓套件等权:BFCL v4-500(3 次)、HLE-250(10 次)、AA-LCR-25(25 次);相对参考给 95% 置信区间并标注是否显著偏低
- ✓GLM-5.3 Flash:22 端点中 16 个与参考统计一致、1 个约 104.2;约 32K 输出上限端点 HLE-250 约 22%/29% vs 参考 55%
- ✓Muse Spark Open:5 端点中 3 个约 99.5–99.9(含 FP4);另 2 个主要在工具调用掉分(BFCL-500 约 50%/51% vs 59%)
开发者 3 秒速决决策指标
把技术选型换算成你的开发预算
40 款主流编程套餐横向比价,支持输入/输出 Token 真实账单模拟
相关资源与官方项目出处
免代理直达深度技术解析与实战评估
核心背景与行业痛点
同一开源权重经不同 API 厂商托管后,常因量化、采样默认、上下文截断、输出上限或工具调用解析而掉精度。只比价格与速度,可能买到「同名模型、更低精度」。Artificial Analysis Endpoint Accuracy Index 把端点精度做成可比较分数。
架构亮点与底层机制
以自建官方权重部署为参考(100%),对 serverless 端点重跑等权套件并给 95% 置信区间。v1.1 将 AA-LCR-25 升到 v1.1(修正答案键,判分用 GPT-5.6 Luna medium),重复 10→25,官方称平均 95% CI 约 ±4.7→±2.6。覆盖六款开源权重,新增 GLM-5.3 Flash 与 Muse Spark Open。结果为带日期点测,非实时监控。
权威 Benchmark 与实测跑分对比
以下为 Artificial Analysis 官方口径:100+ 端点近 1/4 低于参考。GLM-5.3 Flash:22 端点中 16 个与参考统计一致、1 个约 104.2;约 32K 输出上限端点 HLE-250 约 22%/29% vs 参考 55%。Muse Spark Open:5 端点中 3 个约 99.5–99.9(含 FP4);另 2 个主要在 BFCL-500 掉分(约 50%/51% vs 59%)。请按方法论页核对最新点测日期。
开发者实战落地与开箱指南
选型时对照该指数,优先选与参考置信区间重叠的端点;低分先查输出上限、默认推理力度与工具调用解析。自建/第一方端点可作基线。详见 artificialanalysis.ai;不替代自有评测。
即刻查看该技术对应模型与主流工具的实测差异,或一键测算团队 API 调用与 $20/月套餐盈亏平衡点。
讨论与评论
0登录后即可参与深度讨论
与广大 AI 开发者、工程师交流评测心得与前沿洞察