AI 编程实时动态与要闻

Mistral 与 NVIDIA 达成工业工程 AI 战略结盟:万亿参数 Mistral Large 4 重磅前瞻曝光

欧洲前沿 AI 巨头 Mistral AI 与 NVIDIA 在 GTC Berlin 宣布达成工业工程 AI 深度战略合作,全面加速物理 AI、计算机辅助工程(CAE)与芯片设计(EDA)的智能化变革。合作将 Mistral 旗舰模型与 NVIDIA CUDA-X、Warp 物理引擎以及 Omniverse 实时数字孪生进行全链路打通。官方博客同时公布了备受瞩目的下一代旗舰模型 Mistral Large 4 的核心技术参数:总参数量接近 1 万亿(1T),激活参数为 490 亿(49B MoE),在 3800 张 Grace Blackwell GPU 集群上训练完成,模型权重定于 10 月底正式开源发布,并将联合 Nemotron 联盟共建工业基座。

Mistral 与 NVIDIA 达成工业工程 AI 战略结盟:万亿参数 Mistral Large 4 重磅前瞻曝光

核心要点速览

  • Mistral AI 与 NVIDIA 官宣战略合作,将大模型能力全面注入计算机辅助工程(CAE)、物理仿真与半导体芯片设计(EDA)
  • 深度融合 NVIDIA Warp、CUDA-X 物理加速库与 Omniverse 数字孪生平台,构建工程仿真领域的开源智能体评测与基准
  • 首次正式公开 Mistral Large 4 核心规格:约 1 万亿总参、49B 稀疏激活 MoE 架构,在 3800 张 Grace Blackwell 算力集群完成预训练
  • Mistral Large 4 官方权重定于 2026 年 10 月底全量开源发布,并宣布双方加入 Nemotron 联盟向 2030 年 1 GW 绿色算力推进
阅读全文
关联模型 / 智能体 / 厂商:

端侧算子自动生成首个统一基准:EdgeKernelBench 联合 LEKA 智能体攻克异构硬件代码生成

多所顶尖高校与科研机构在 arXiv:2610.24648 中正式发布首个面向异构端侧硬件的大模型底层算子生成统一基准 EdgeKernelBench 与分层智能体架构 LEKA。针对当前学术界算子生成评测过度局限于云端高性能服务器 GPU,而在端侧设备上面临硬件高度异构、底层软件栈严重碎片化(CUDA、OpenCL、TileLang、Triton)以及极度严苛资源约束的行业痛点,EdgeKernelBench 建立了包含 331 项经典任务与 650 个实例的统一中间表示(IR)部署管线。配合分层算子生成智能体 LEKA 解耦复杂编译决策,使大模型端侧算子生成性能取得跨越式突破。

端侧算子自动生成首个统一基准:EdgeKernelBench 联合 LEKA 智能体攻克异构硬件代码生成

核心要点速览

  • 研究团队在 arXiv:2610.24648 中开源首个端侧异构算子生成统一基准 EdgeKernelBench,填补端侧 AI 编译大模型评测空白
  • 涵盖 CPU/LLVM、GPU/CUDA 与 GPU/OpenCL 等跨平台硬件栈,设立 331 项经典计算范式与 650 个实测实例
  • 提出分层端侧算子生成智能体 LEKA(Layered Edge Kernel Agent),沿 IR 中间表示层级化解耦决策,攻克传统单次生成仅 25.5% 性能达标的瓶颈
  • 为移动端芯片、嵌入式 NPU 与机器人端侧加速器的底层高性能算子自动化编译铺平了产业落地道路
阅读全文
关联模型 / 智能体 / 厂商:

Gradium 开源端侧 TTS 模型 Phonon:31M 参数、64 MB,笔记本 CPU 上 7 毫秒开口,英文版 Apache 2.0 可商用

10 月 20 日,法国语音 AI 公司 Gradium 开源 Phonon 端侧文本转语音模型家族:英文 Phonon 31m(q8 权重 64 MB,Apache 2.0)和 Phonon 40m(英/法/德/西/葡单语版与五语合一版,CC BY-NC 非商用)。模型基于 Kyutai 的 Pocket TTS 和 Mimi 编解码器,自带推理栈,覆盖 CPU、Metal、CUDA、Vulkan、WebGPU、Core ML 和骁龙,可在手机、浏览器、树莓派上离线运行。官方称 MacBook Air M5 CPU 上首段音频 7 毫秒,Kokoro 为 517 毫秒。

Gradium 开源端侧 TTS 模型 Phonon:31M 参数、64 MB,笔记本 CPU 上 7 毫秒开口,英文版 Apache 2.0 可商用

核心要点速览

  • 许可要看清:只有英文 Phonon 31m 是 Apache 2.0 可商用;Phonon 40m 各语言版和多语版均为 CC BY-NC 4.0,商用需联系 Gradium
  • 体积(官方):31m 的 q8 权重 64 MB,40m 为 74.6 MB;内置 37 个英文音色,多语版 102 个,也可用 Gradium 克隆或设计的音色
  • 速度(官方实测):MacBook Air M5 CPU 4 线程首段音频 6.9 毫秒、29.9 倍实时;Kokoro 517 毫秒(Kokoro 不流式输出);树莓派 5 上 38 毫秒开口、3.7 倍实时;骁龙 8 Elite Gen 5 上 7.5 毫秒
  • 准确率(厂商自建难句集,每种语言 500 句,已在 HF 公开):英文 WER 31m 1.70%、40m 2.22%,Kokoro 3.50%、NeuTTS Nano 8.71%;号码、日期、版本号等结构化文本靠文本规范化读对
  • 上手:uvx ptts 或 pip install ptts 即可本地合成,另有浏览器 npm 包 phonon-tts 和 GitHub 运行时 gradium-ai/xn-ptts
阅读全文
关联模型 / 智能体 / 厂商:
⚡ Phonon 31m⚡ Phonon 40m⚡ Phonon 40m multilingual⚡ Pocket TTS⚡ Kokoro🤖 Pipecat🌐 Gradium🌐 Kyutai🌐 Arm🌐 Qualcomm🌐 Hugging Face

Google 联合 Meta 开源 TorchTPU:PyTorch 原生跑在 TPU 上,把 .to("cuda") 改成 .to("tpu") 即可迁移,vLLM、SGLang 同步上 TPU 原生后端

10 月 20 日 PyTorch Conference 2026 上,Google 宣布与 Meta PyTorch 团队共同开发的 TorchTPU 在 GitHub 开源,让 TPU 和 GPU、CPU 一样成为 PyTorch 原生设备:支持 eager 模式和 torch.compile、约 450 个 ATen 算子、torch.distributed 集合通信。同时开源 vLLM-TorchTPU、SGLang-TorchTPU 推理引擎,打通 TorchTitan、Ray、VeRL、Hugging Face Transformers v5(device_map="tpu"),并预览面向 Claude Code、Antigravity 等编码助手的 TPU agent suite。前一天 AWS 刚发布同类的 TorchNeuron。

Google 联合 Meta 开源 TorchTPU:PyTorch 原生跑在 TPU 上,把 .to("cuda") 改成 .to("tpu") 即可迁移,vLLM、SGLang 同步上 TPU 原生后端

核心要点速览

  • 迁移门槛(PyTorch 官方博客):现有代码把 model.to("cuda") 改成 model.to("tpu")、分布式后端换成 tpu_dist 即可跑起来;官方也说明想拿到峰值性能仍需按 TPU 调整形状和切分
  • 覆盖面(官方口径):约 4,917 个热门 Hugging Face 模型中 98%(4,821 个)可在 TPU 上无报错运行,657 个架构代表模型里 97%(638 个)与 GPU 数值一致
  • 训练扩展(官方口径):TorchTitan 上 Qwen3 MoE 235B 从 1,024 扩到 8,192 颗 TPU v7,MFU 基本稳定在 27%–29%;64 颗 TPU v7 上吞吐 1,828 TPS,接近 JAX/MaxText 的 1,937 TPS
  • 推理成本(官方转引 SemiAnalysis InferenceX):TPU v7 加 vLLM-TorchTPU 在 8K/1K 场景每百万 token 2.01 美分,9 月首测时为 3.6 美分
  • 同步开源 4 个仓库:torch_tpu、vllm-torchtpu、sglang-torchtpu、TorchTitan TPU 版;TPU agent suite 以预览形式上线,支持 TPU v6e 与 TPU7x
阅读全文
AD赞助内容

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

vLLM 团队联合 Inferact、Red Hat 与 NVIDIA 于 10 月 9 日发布 Rubin 早期支持:基于 CUDA 13.4 的每日镜像已可在 Vera Rubin NVL72 上服务 DeepSeek、Kimi、GLM、MiniMax。官方口径下,SemiAnalysis AgentX 上 MiniMax M3 同等交互性单卡吞吐最高为 GB200 的 7.84 倍;MLPerf Inference v6.1 的 VLM 项上 Qwen3-VL-235B-A22B 相对 GB300 NVL72 最高 3.7 倍。

vLLM 正式支持 NVIDIA Vera Rubin NVL72:AgentX 上 MiniMax M3 单卡吞吐达 GB200 的 7.84 倍

核心要点速览

  • 硬件对比 GB200 NVL72:NVFP4 算力 5 倍、HBM4 带宽约 2.4 倍、NVLink 双向带宽 1.7 倍,softmax 指数运算快 2–4 倍(vLLM 博文)
  • AgentX + MiniMax M3:同等交互性单卡吞吐最高 7.84 倍,150 TPS 约束下 5.18 倍(官方口径,早期结果)
  • MLPerf Inference v6.1:Qwen3-VL-235B-A22B 经 vLLM + Dynamo,相对 GB300 NVL72 最高 3.7 倍
  • CUDA 13.4 locality domain 拆分 MoE 权重,小 token decode 场景 MoE 层平均提速约 1.2 倍
  • 开箱镜像:vllm/vllm-openai:cu134-nightly(CUDA 13.4 + PyTorch 2.15)
阅读全文

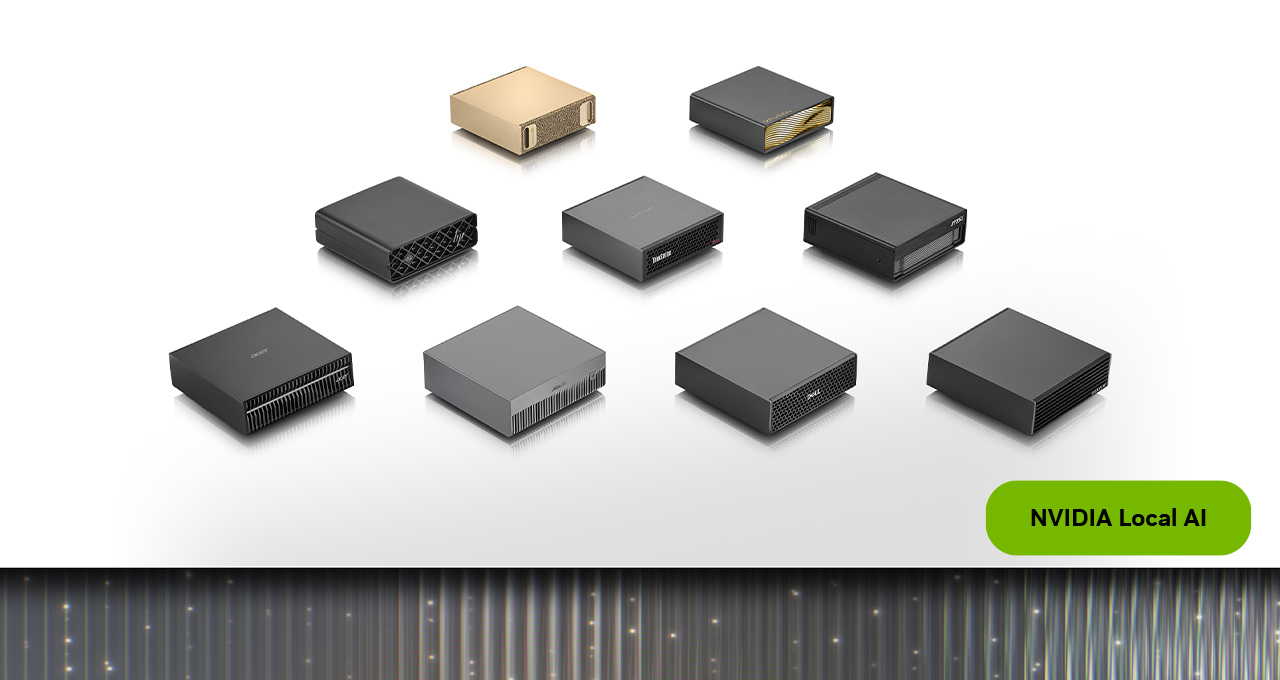
NVIDIA 推出 DGX Spark 64GB:10/23 起 OEM 开卖起价 $4,999;双机集群最高约 1.7×,本地跑至约 100B

NVIDIA 于 2026-10-02 在博客宣布 DGX Spark 64GB:10 月 23 日(周五) 起经 Acer / ASUS / Dell / Gigabyte / HP / MSI 发售,起价 $4,999。同款 GB10 Grace Blackwell、DGX OS 与完整 CUDA AI 栈;单机统一内存 64GB、官方称可本地支撑约 100B 参数模型与 Agent。两台经 ConnectX-7 + QSFP 集群可池化 128GB(约 200B);Qwen 3.8 27B 测试中双 64GB 相对单机最高约 1.7×。

NVIDIA 推出 DGX Spark 64GB:10/23 起 OEM 开卖起价 $4,999;双机集群最高约 1.7×,本地跑至约 100B

核心要点速览

  • 官宣:NVIDIA Blog — DGX Spark 64GB(Allen Bourgoyne,2026-10-02)
  • 渠道与价格:2026-10-23 起 OEM(Acer/ASUS/Dell/Gigabyte/HP/MSI);博客写明 starting at $4,999;64GB 仅经参与 OEM
  • 算力栈:保留 GB10 + DGX OS + CUDA AI;开箱支持 Agent Toolkit、Ollama、vLLM、PyTorch、Nemotron 等
  • 扩展:内置 ConnectX-7;双机 QSFP 直连池化 128GB / 约 200B 参数;Qwen 3.8 27B 实测双机相对单机最高约 1.7×
  • 月底预告:NVIDIA Sync Model Launcher 可一键拉起 Qwen3.8 27B,并配置 OpenCode 走本地模型
阅读全文

LMDeploy 0.18.0:Qwen3.5 dflash、SM90 量化 GEMM、Ascend GLM-5.2;TurboMind W4A16 与 piecewise CUDA Graph

上海 AI Lab 开源推理栈 LMDeploy 于 2026-09-28 发布 v0.18.0:支持输出 input logprobs、扩展 SM90 量化 GEMM 并统一 TurboMind linear 执行路径;Ascend 侧支持 GLM-5.2;为 Qwen3.5 接入 dflash;MoE 将 shared expert 并入 FFN 并在节点内切分 dense FFN。PyTorch 路径原型化 TurboMind W4A16(AWQ)、piecewise CUDA Graph prefill、XTuner TileLang sparse MLA,并支持 checkpoint-engine 权重热更新与 request-only KV cache 用量指标。

LMDeploy 0.18.0:Qwen3.5 dflash、SM90 量化 GEMM、Ascend GLM-5.2;TurboMind W4A16 与 piecewise CUDA Graph

核心要点速览

  • 发版:v0.18.0(2026-09-28);PyPI lmdeploy==0.18.0
  • 模型/硬件:Qwen3.5 dflash;Ascend GLM-5.2;SM90 量化 GEMM 扩展(#4943)
  • 推理内核:TurboMind W4A16 AWQ 原型(#4897);piecewise CUDA Graph prefill(#4895);TileLang sparse MLA(#4904)
  • 运维:checkpoint-engine 权重更新(#4913);request-only cache 用量指标(#4940);input logprobs(#4793)
  • 安装:pip install -U "lmdeploy>=0.18.0";文档见 lmdeploy.readthedocs.io
阅读全文
关联模型 / 智能体 / 厂商:

Unsloth 发布 v0.1.815 与 CUDA 13 预编译轮子:本地极速运行 Qwen-Image-2.1 并接入 Claude 规范 Agent Skills

知名大模型轻量高效训练与推理工具 Unsloth 正式发布 v0.1.815-beta 版本,并上线 Linux x86_64 CUDA 13 官方预编译二进制轮子(涵盖 Flash-Attention 2.8.4、Causal-Conv1D 与 Mamba-SSM)。新版本原生支持在本地消费级与企业级 GPU 上以 Fast FP8 与 GGUF(默认 Q4_K_M)量化运行阿里开源的多模态图像编辑与生成旗舰模型 Qwen-Image-2.1。此外,Unsloth 本地 UI 引入了深度兼容 Claude Code 与 .agents 规范的自定义 Agent Skills 体系,支持在聊天中以 @skill 快速编排专用技能,长链思考思维块渲染速率提升一倍达到 60 FPS。

Unsloth 发布 v0.1.815 与 CUDA 13 预编译轮子:本地极速运行 Qwen-Image-2.1 并接入 Claude 规范 Agent Skills

核心要点速览

  • CUDA 13 官方二进制:提供针对 PyTorch 2.13/2.14 与 Python 3.13 的 Flash-Attention 2.8.4、Causal-Conv1D 与 Mamba 预编译 Wheel,告别数小时本地编译
  • Qwen-Image-2.1 本地量化落地:支持 Fast FP8 与 GGUF Q4_K_M,完整覆盖图像生成与多轮指令式图像编辑,彻底修复 A100 黑块伪影
  • 全兼容 Agent Skills 体系:无缝复用已有 Claude Code 与 .agents 目录中的专用指令技能,聊天框支持 @skill 即时激活与参数传递
  • 思维链推理渲染翻倍:重构 CoT 思考块交互逻辑,长推理文本流式渲染速度从 30 FPS 提升至 60 FPS,交互顿挫感大幅消除
  • 多系统开箱即用:内置 Debian 应用内自动更新,并为 Ubuntu 24.04+ ARM64 架构提供专用独立安装器
阅读全文
关联模型 / 智能体 / 厂商:

llama.cpp v0.5.0:CUDA conv2d 隐式 GEMM + Metal MoE/SSM 融合,新增 MiMo-V2.6 / HunyuanOCR / Mimir 1B

ggml-org 于 2026-09-23 发布 llama.cpp v0.5.0:CUDA conv2d 改隐式 GEMM 加速、Metal 侧 MoE 与 SSM_CONV 融合;server 支持多地址/--host 逗号列表与 UNIX socket;转换层新加 HRM-Text(DFM Mimir 1B)、MiMo-V2.6、HunyuanOCR(DFlash),并捆绑 ggml 0.25.0。

llama.cpp v0.5.0:CUDA conv2d 隐式 GEMM + Metal MoE/SSM 融合,新增 MiMo-V2.6 / HunyuanOCR / Mimir 1B

核心要点速览

  • 发布:v0.5.0(2026-09-23),相对站内既有 v0.4.1 为大版本跃迁
  • 性能:CUDA conv2d 隐式 GEMM(#29135);Metal MoE + SSM_CONV fusion(#28948);MTP drafting 启用 CUDA graphs(#28549)
  • 模型:HRM-Text / DFM Mimir 1B、MiMo-V2.6 转换、HunyuanOCR DFlash、Qwen4Exp hyper-connection + sparse FA、Nemotron MTP/H 扩展
  • Server:--host 支持逗号分隔 TCP 与 UNIX socket(#28690);function-call 输出可带 input_image;router 驱逐竞态修复
  • API:llama_adapter_lora_init_from_file_ptr();采样参数可走环境变量;llama-bench --version
阅读全文
关联模型 / 智能体 / 厂商:
⚡ qwen⚡ deepseek⚡ nemotron🌐 ggml-org

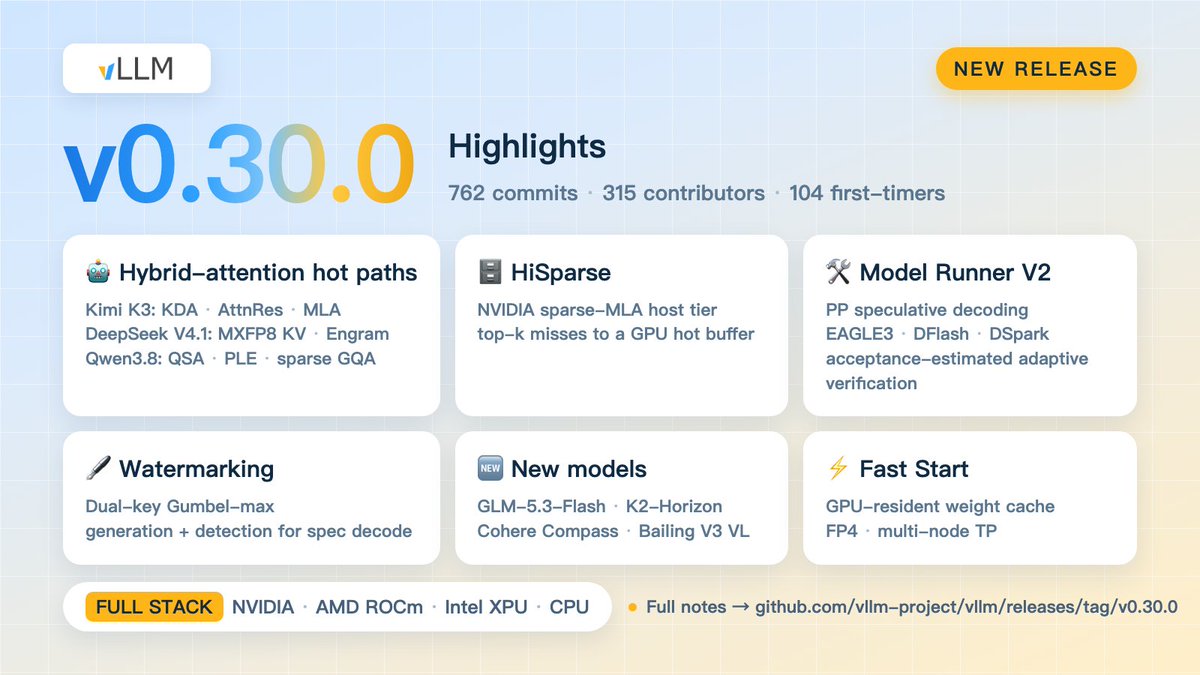
vLLM v0.30.0:762 提交上线,加速 Kimi K3 / DeepSeek-V4.1-Flash / Qwen3.8-Flash-Next

vLLM 项目(@vllm_project)发布 v0.30.0(762 提交、315 贡献者)。亮点包括混合注意力热路径:Kimi K3 精简 KDA/AttnRes/MLA,DeepSeek-V4.1-Flash 加入 MXFP8 KV 与异步 Engram,Qwen3.8-Flash-Next 融合 QSA/PLE 并降低 sparse-GQA 开销;另有 HiSparse 主机层、Model Runner V2 的 EAGLE3 管线并行与自适应校验、双密钥 Gumbel-max 水印,以及 Fast Start(CUDA IPC 权重缓存)与 GLM-5.3-Flash、K2-Horizon、Cohere Compass、Bailing V3 VL 等新模型支持。

vLLM v0.30.0:762 提交上线,加速 Kimi K3 / DeepSeek-V4.1-Flash / Qwen3.8-Flash-Next

核心要点速览

  • 混合注意力热路径覆盖 Kimi K3、DeepSeek-V4.1-Flash、Qwen3.8-Flash-Next 等当前编码常用模型。
  • Model Runner V2 把 EAGLE3 式草稿扩展到流水线并行,并在线估计验收率。
  • Fast Start 用 CUDA IPC 缓存量化分片权重,重启加载更快。
阅读全文
AD赞助内容

Hugging Face Kernels:换更快算子不必改模型,按层映射推理/训练与设备类型

Hugging Face 工程师 @RisingSayak 介绍 🤗 Kernels(huggingface.co/docs/kernels):发现更快算子时不必重写模型,可直接替换支持层的 forward()。同一层可为推理与训练指定不同 kernel,也可按设备类型分流;选择写入全局或局部映射,验证负载后再保留有效方案。配套 Hub 动态加载与 kernels Python 包(需 torch≥2.5 与 CUDA),官方维护 kernels-community。

核心要点速览

  • 按层替换 forward() 即可换更快算子,无需改模型代码。
  • 可分别为推理/训练与不同设备指定 kernel,映射可全局或局部。
  • Hub 动态加载 + kernels 包(torch≥2.5/CUDA);文档与 kernels-community 已公开。
阅读全文
关联模型 / 智能体 / 厂商: